摘要 Anthropic 的工程实验把记忆拆成记录、笔记、wiki 和每次开场加载的要点。闲时“做梦”可以对照记录纠错、整理知识,但单靠 wiki 仍不如直接搜索,两者配合才在测试中得分更高。给 AI 加记忆,关键在验证、组织和更新,而非把所有细节都塞进下一次对话。
Claude 把宝可梦中心的位置记反了,以为自己已经穿过月见山,往前走却掉回了来时的路。Anthropic 让它在空闲时对照游戏记录,改正那条笔记,再继续玩,它才走出了山洞。11 月 6 日发布的《The components of agent memory》用这类实验讨论怎样管理 agent 的记忆:其中的“做梦”指离线复盘,并非面向所有 Claude 用户新上线的功能。下文实验成绩均为 Anthropic 官方自测。
记什么:屏幕上有的,不必再抄一遍
这里的 agent 是能调用工具、连续完成任务的 AI。“记忆”特指它从任务中学到、跨会话保存下来并能重新读取的内容,例如一份笔记文件;不包括修改模型参数,也不等于把同一场对话压缩成摘要。写下一条规则,其实是在判断:以后还会遇到这个情况。
宝可梦实验里,Sonnet 3.7 几乎什么都记,战斗、道具、人物各建文件。大约第 1 万步时,它连续花了 17 步建文件、删文件,游戏却一步没走。游戏状态一直变化,抄得越细,越容易留下过时信息;读取这些笔记又占去了继续行动的时间。
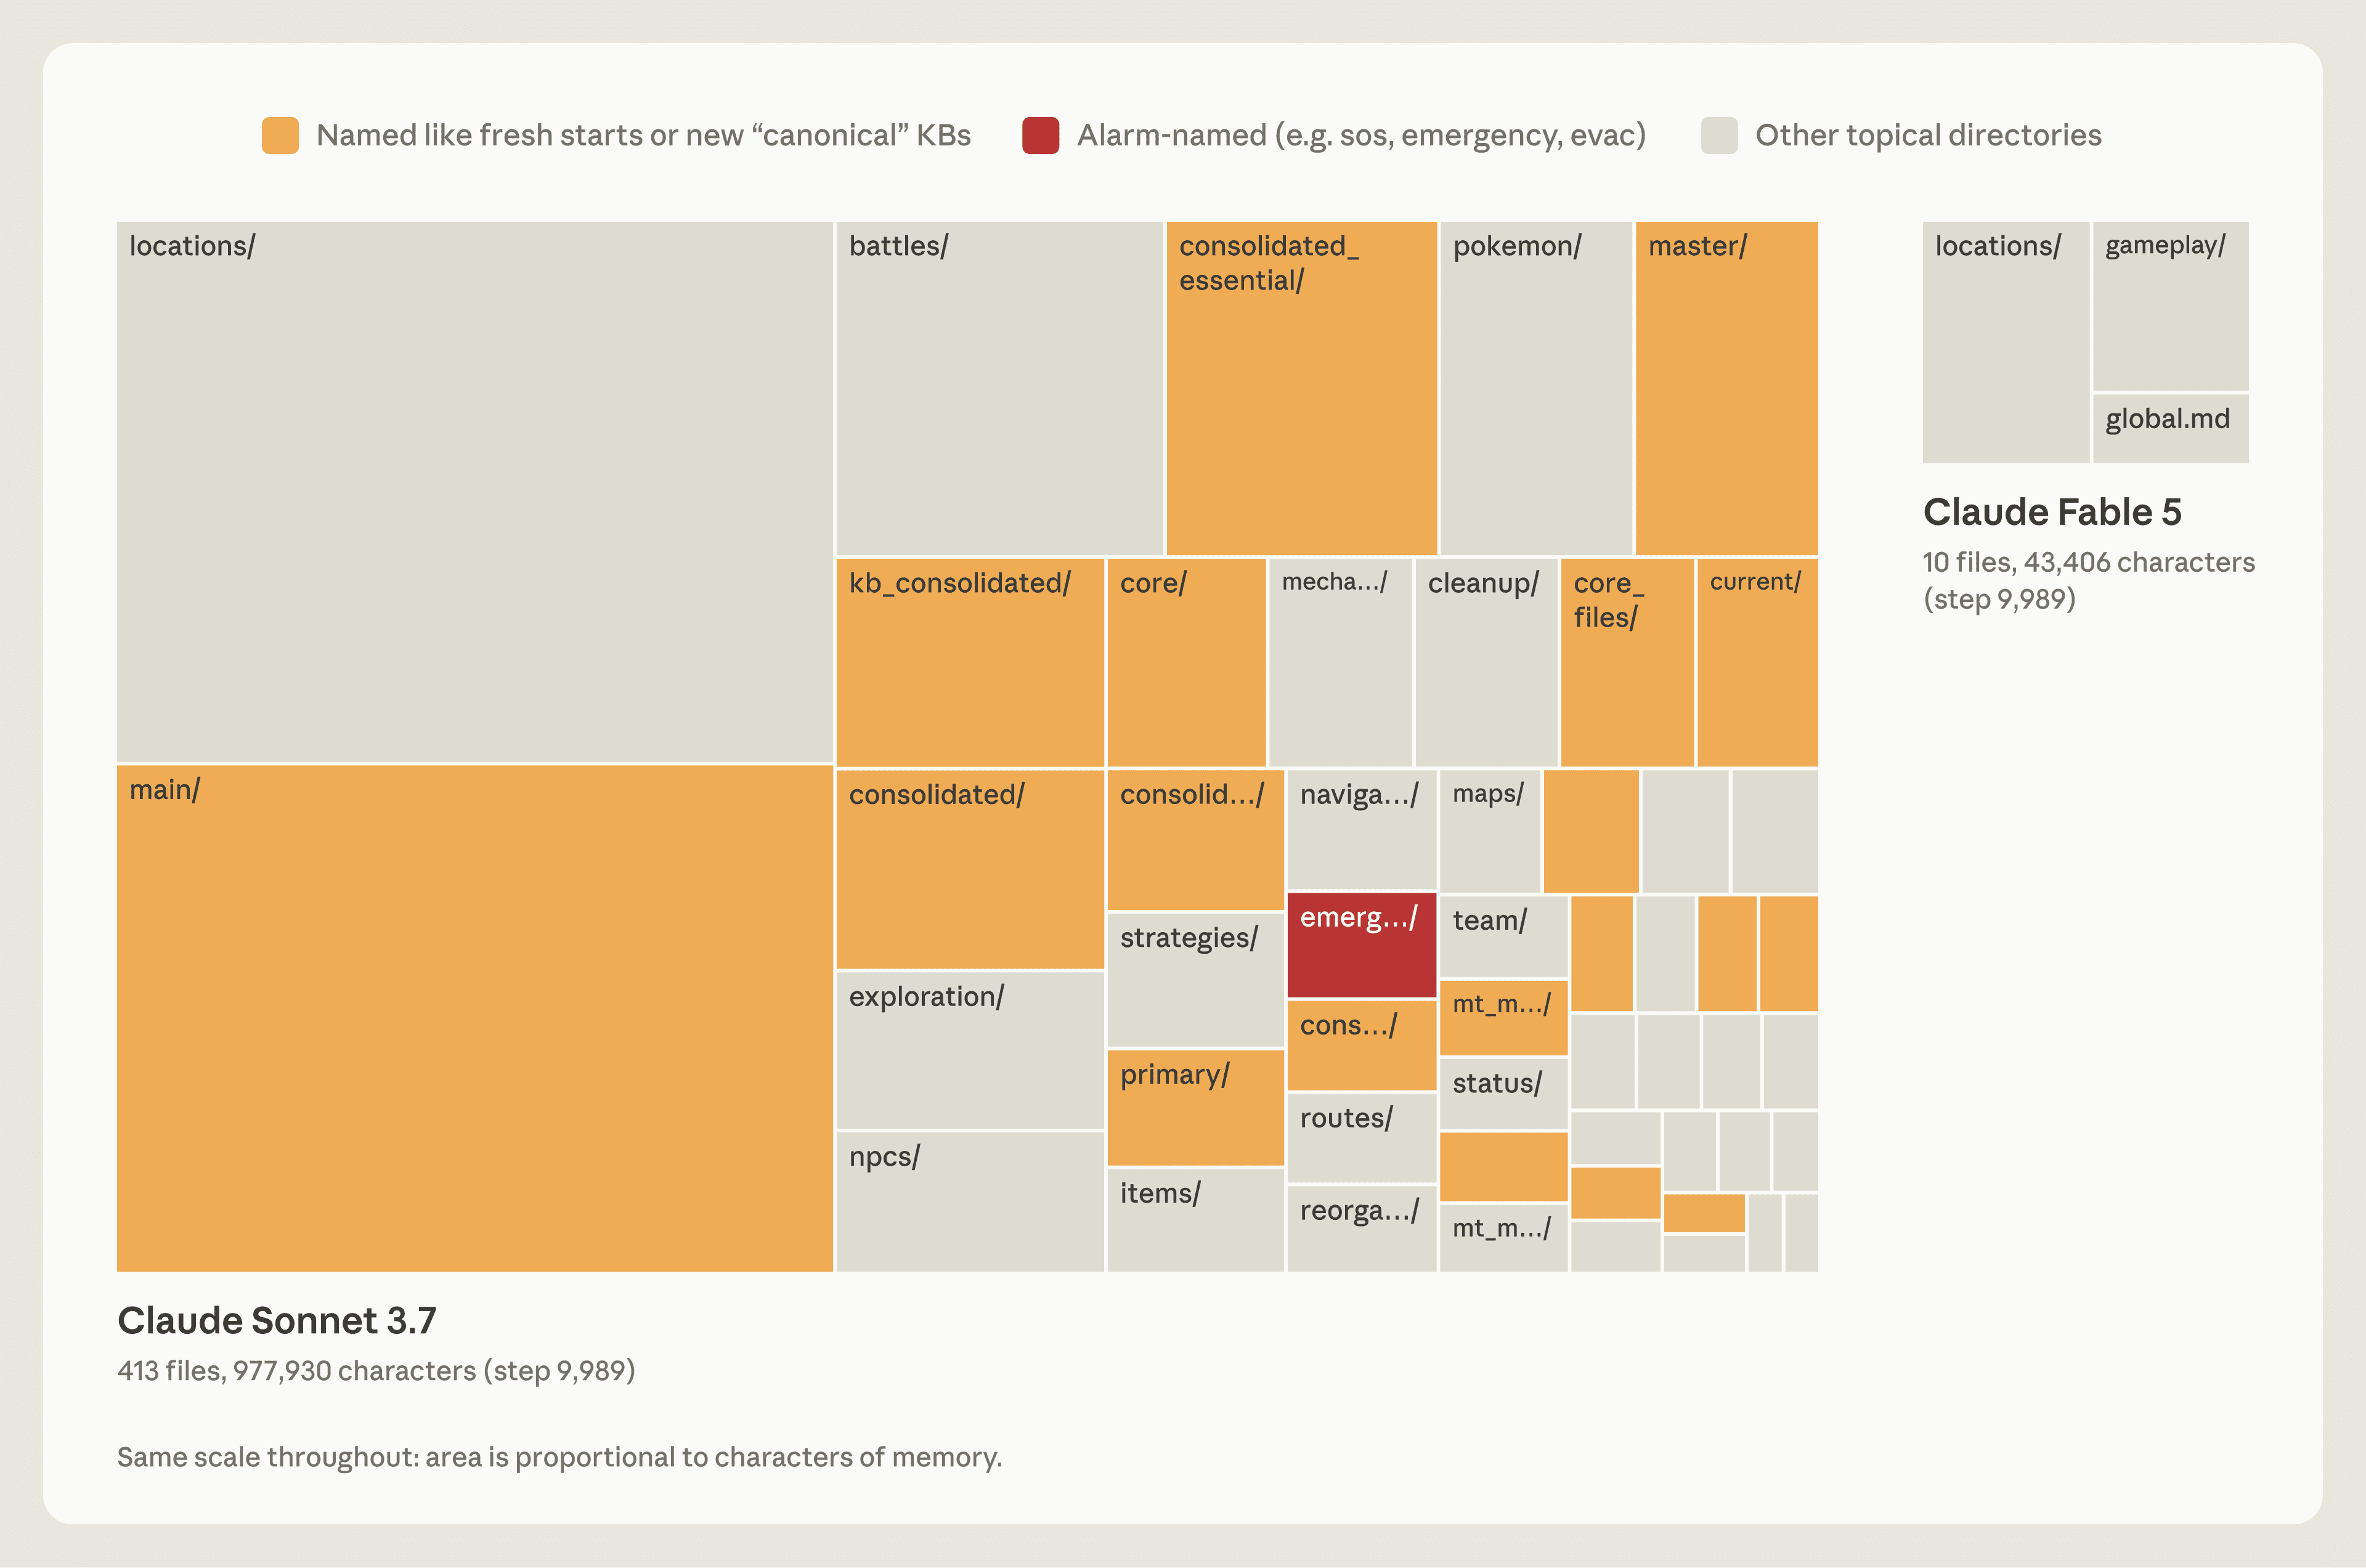
Sonnet 3.7 写了 413 个文件,拿到 1 枚代表游戏进度的徽章;Fable 5 只写 9 个文件加一份 global.md 总览,拿到 4 枚。这是跨代模型各跑一次的观察,不能把成绩差距全算在笔记多少上。 更值得学的是后者的取舍:位置和余额随时能从屏幕读到,目标、路线计划和试出来的规则才需要保存。
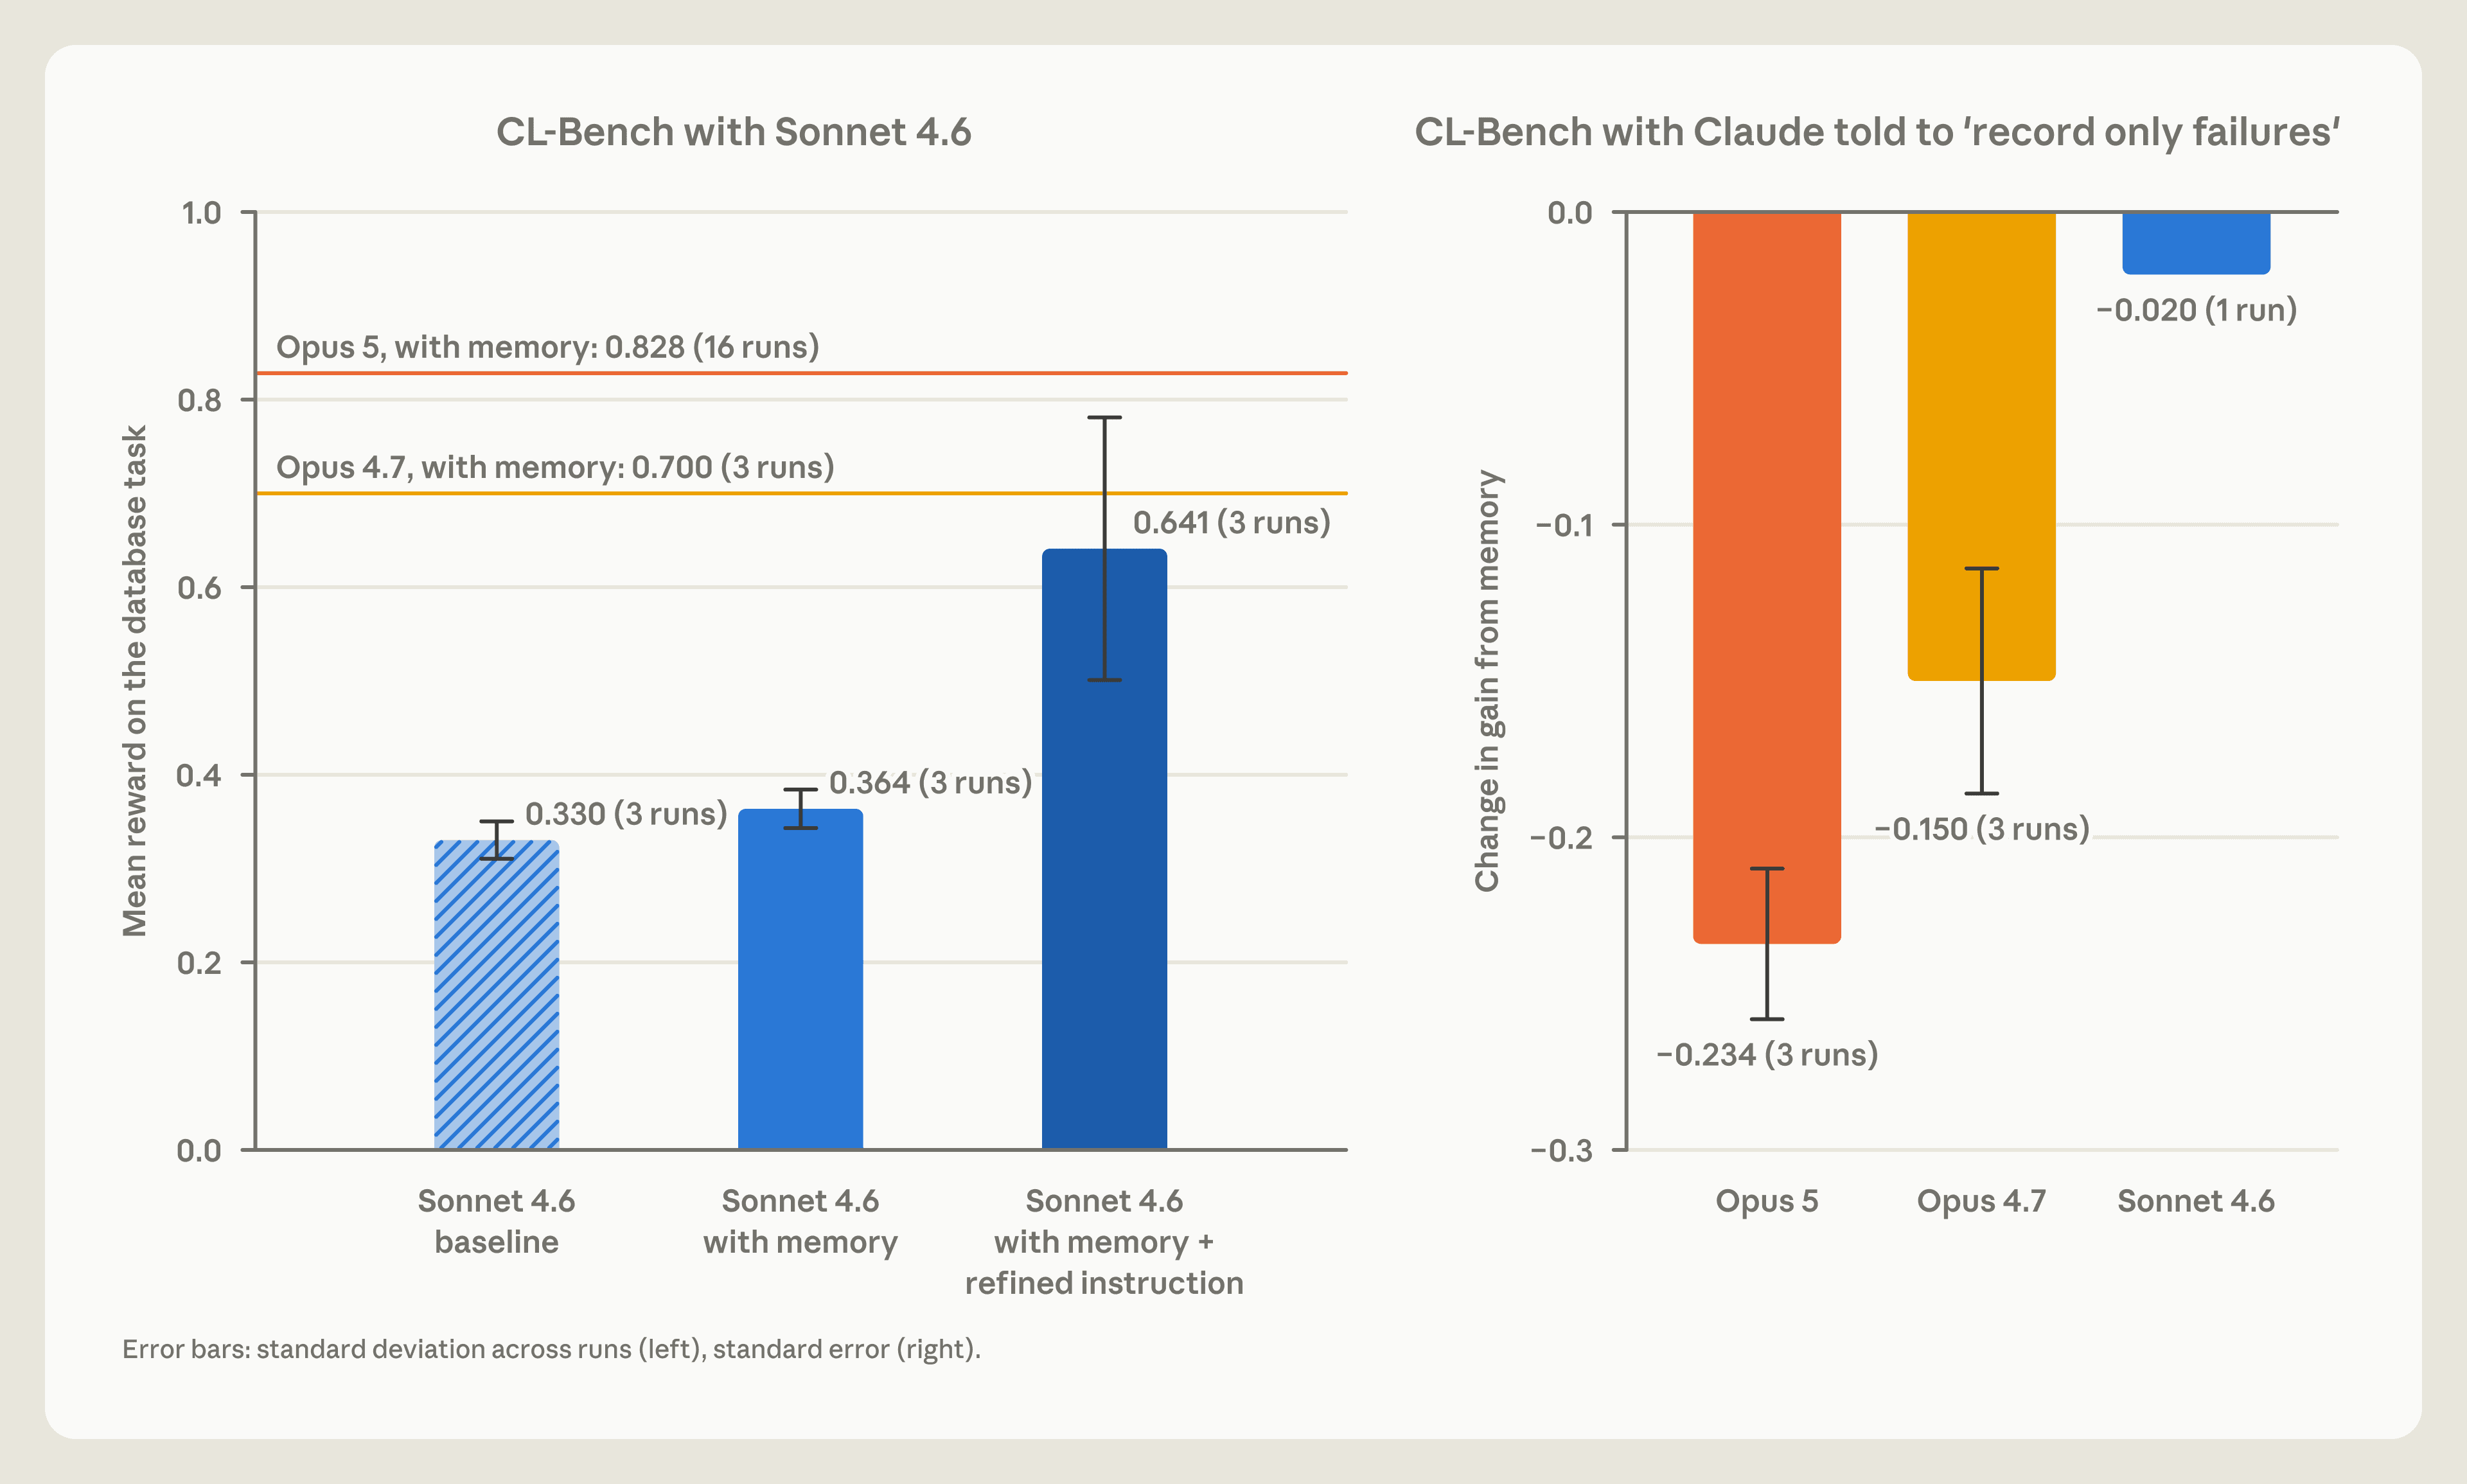
这也不意味着给模型规定“只记失败”就行。在 CL-Bench 数据库任务中,Opus 5 和 Opus 4.7 遵守这条规则后,丢掉了大部分记忆带来的收益;较老的 Sonnet 4.6 则需要提醒先读笔记、再检验猜想,分数才接近翻倍。提示该补什么,取决于模型原本漏了哪一步。
“做梦”怎样纠错:回查记录,不只润色笔记
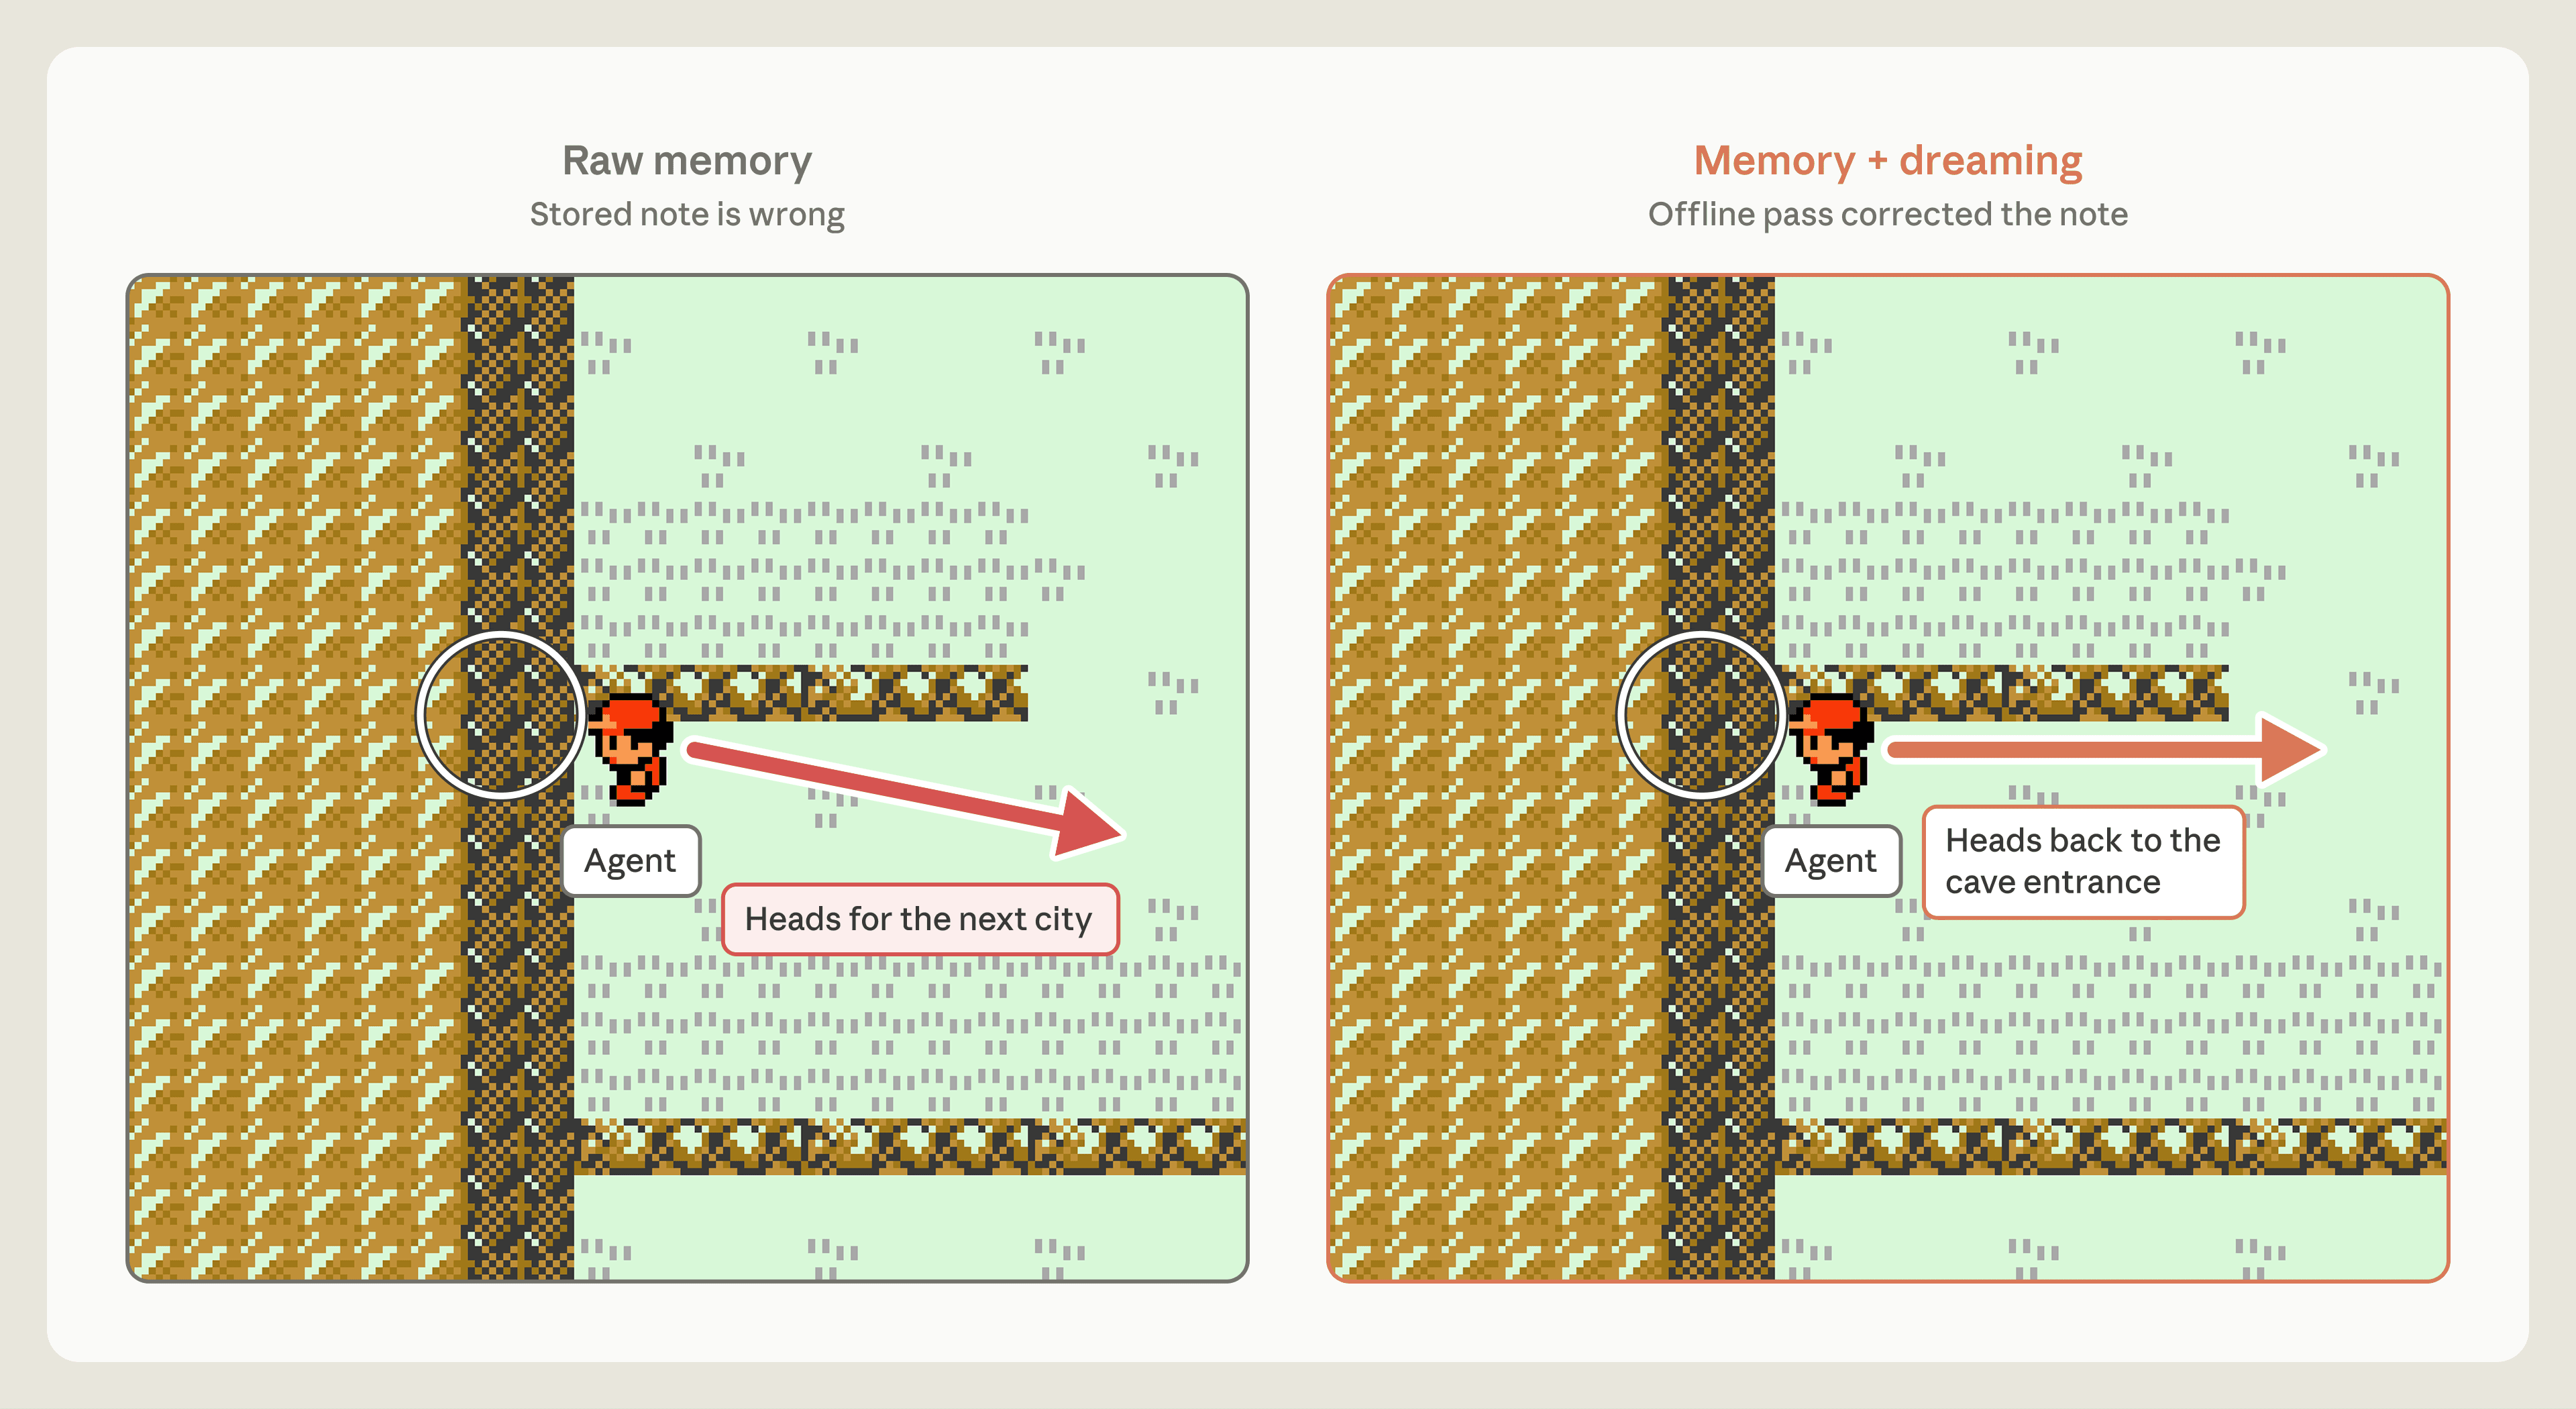
月见山的陷阱在于,宝可梦中心位于入口一侧,Claude 却把它记到了出口一侧。它从中心出来,以为山洞已经走完,于是越过单向台阶,掉回旧路;错误笔记还让它继续相信自己原来的判断。给它更多同样的记忆,并不能解决方向记反的问题。
这次运行在 Claude Managed Agents 上的实验,把原始会话记录留作核对依据。dreaming(“做梦”)在任务间隙读取记录,发现位置错误并改写笔记;重新接手任务的 Claude 才回到山洞入口,最终到达下一座城。它没有在这一过程中重新训练模型,改变的是下一次行动会读到的资料。
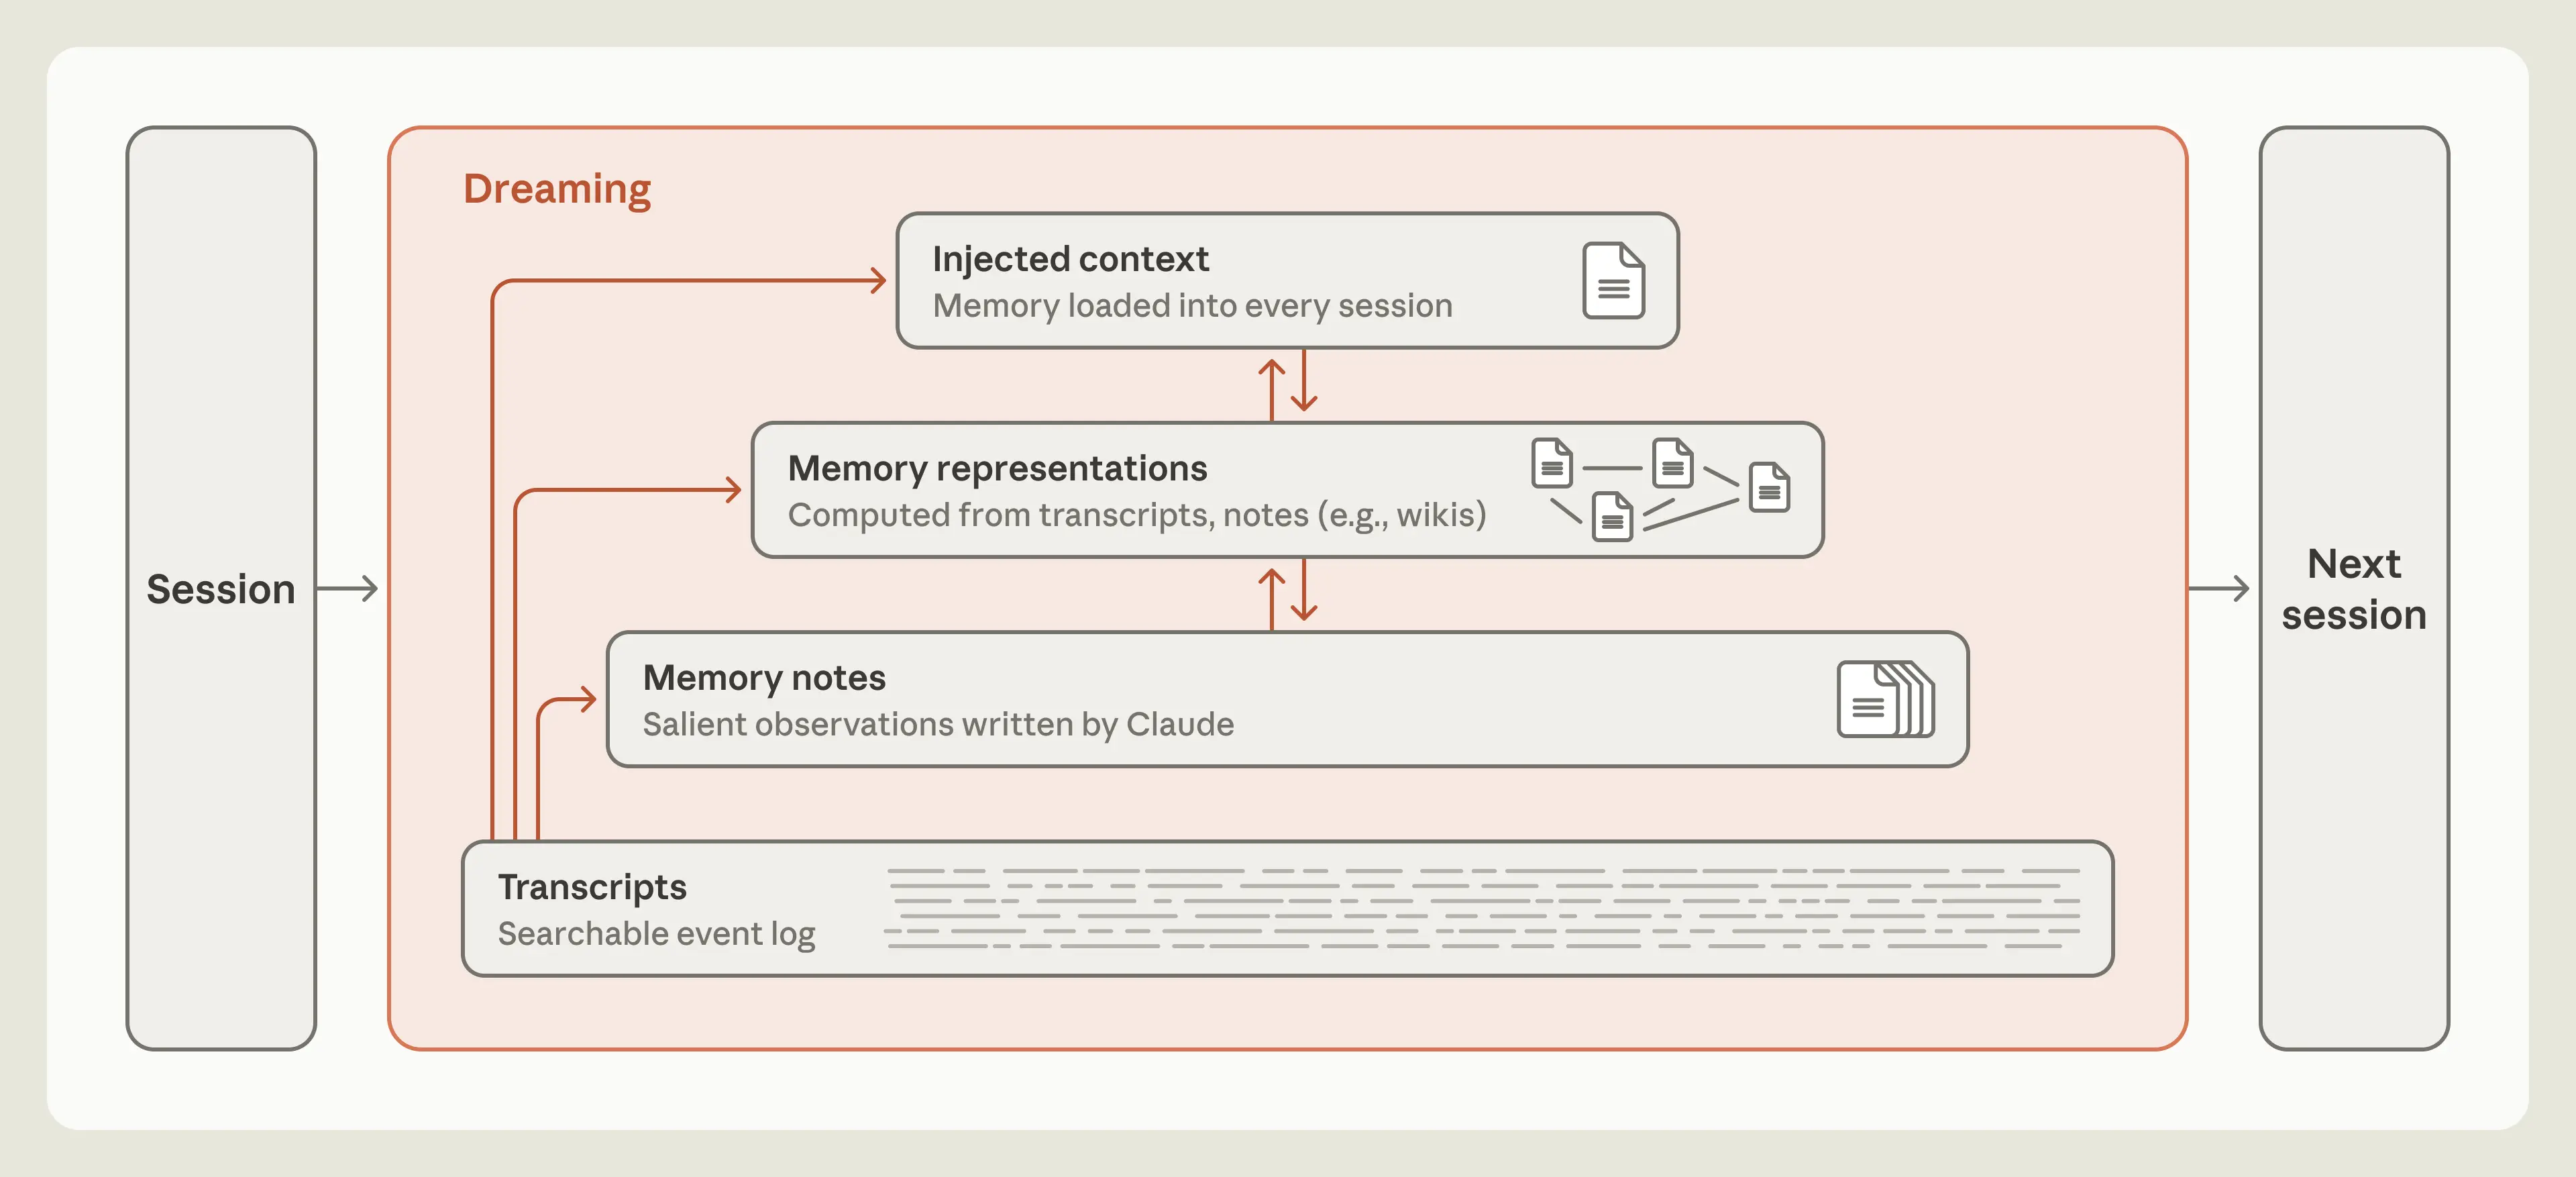
这个思路有明确来历。Letta 与 UC Berkeley 在 2025 年 4 月提出 sleep-time compute,让模型在用户发来下一道问题之前,先用空闲时间整理已有上下文。Anthropic 将这类工作用于记忆管理:检查笔记、归并重复内容、建立关联,或挑出下次开场就该读到的要点。“做梦”是对计算安排的比喻,不是 AI 在睡觉或产生意识。
整理成 wiki 后,为什么还要搜索
笔记多起来,还需要知道它们之间有什么关系。wiki 是一组围绕主题整理、彼此有链接的页面:某个项目的一页能指向它的约束、决策和相关讨论。模型不必每次从零翻遍文件,但仍可能需要回到原始文档找具体答案。
Anthropic 用 Stainless 约 35 万份内部文件、约 4.2 亿 token 的资料,构造了 25 道问题。token 是模型读写文字的计量单位。Opus 5 分多轮整理 wiki,每轮接着上一轮的结果补写、去重和核对;从 2 轮增加到 128 轮后,只靠 wiki 回答时,评分项得分率从 13% 升到 48%。
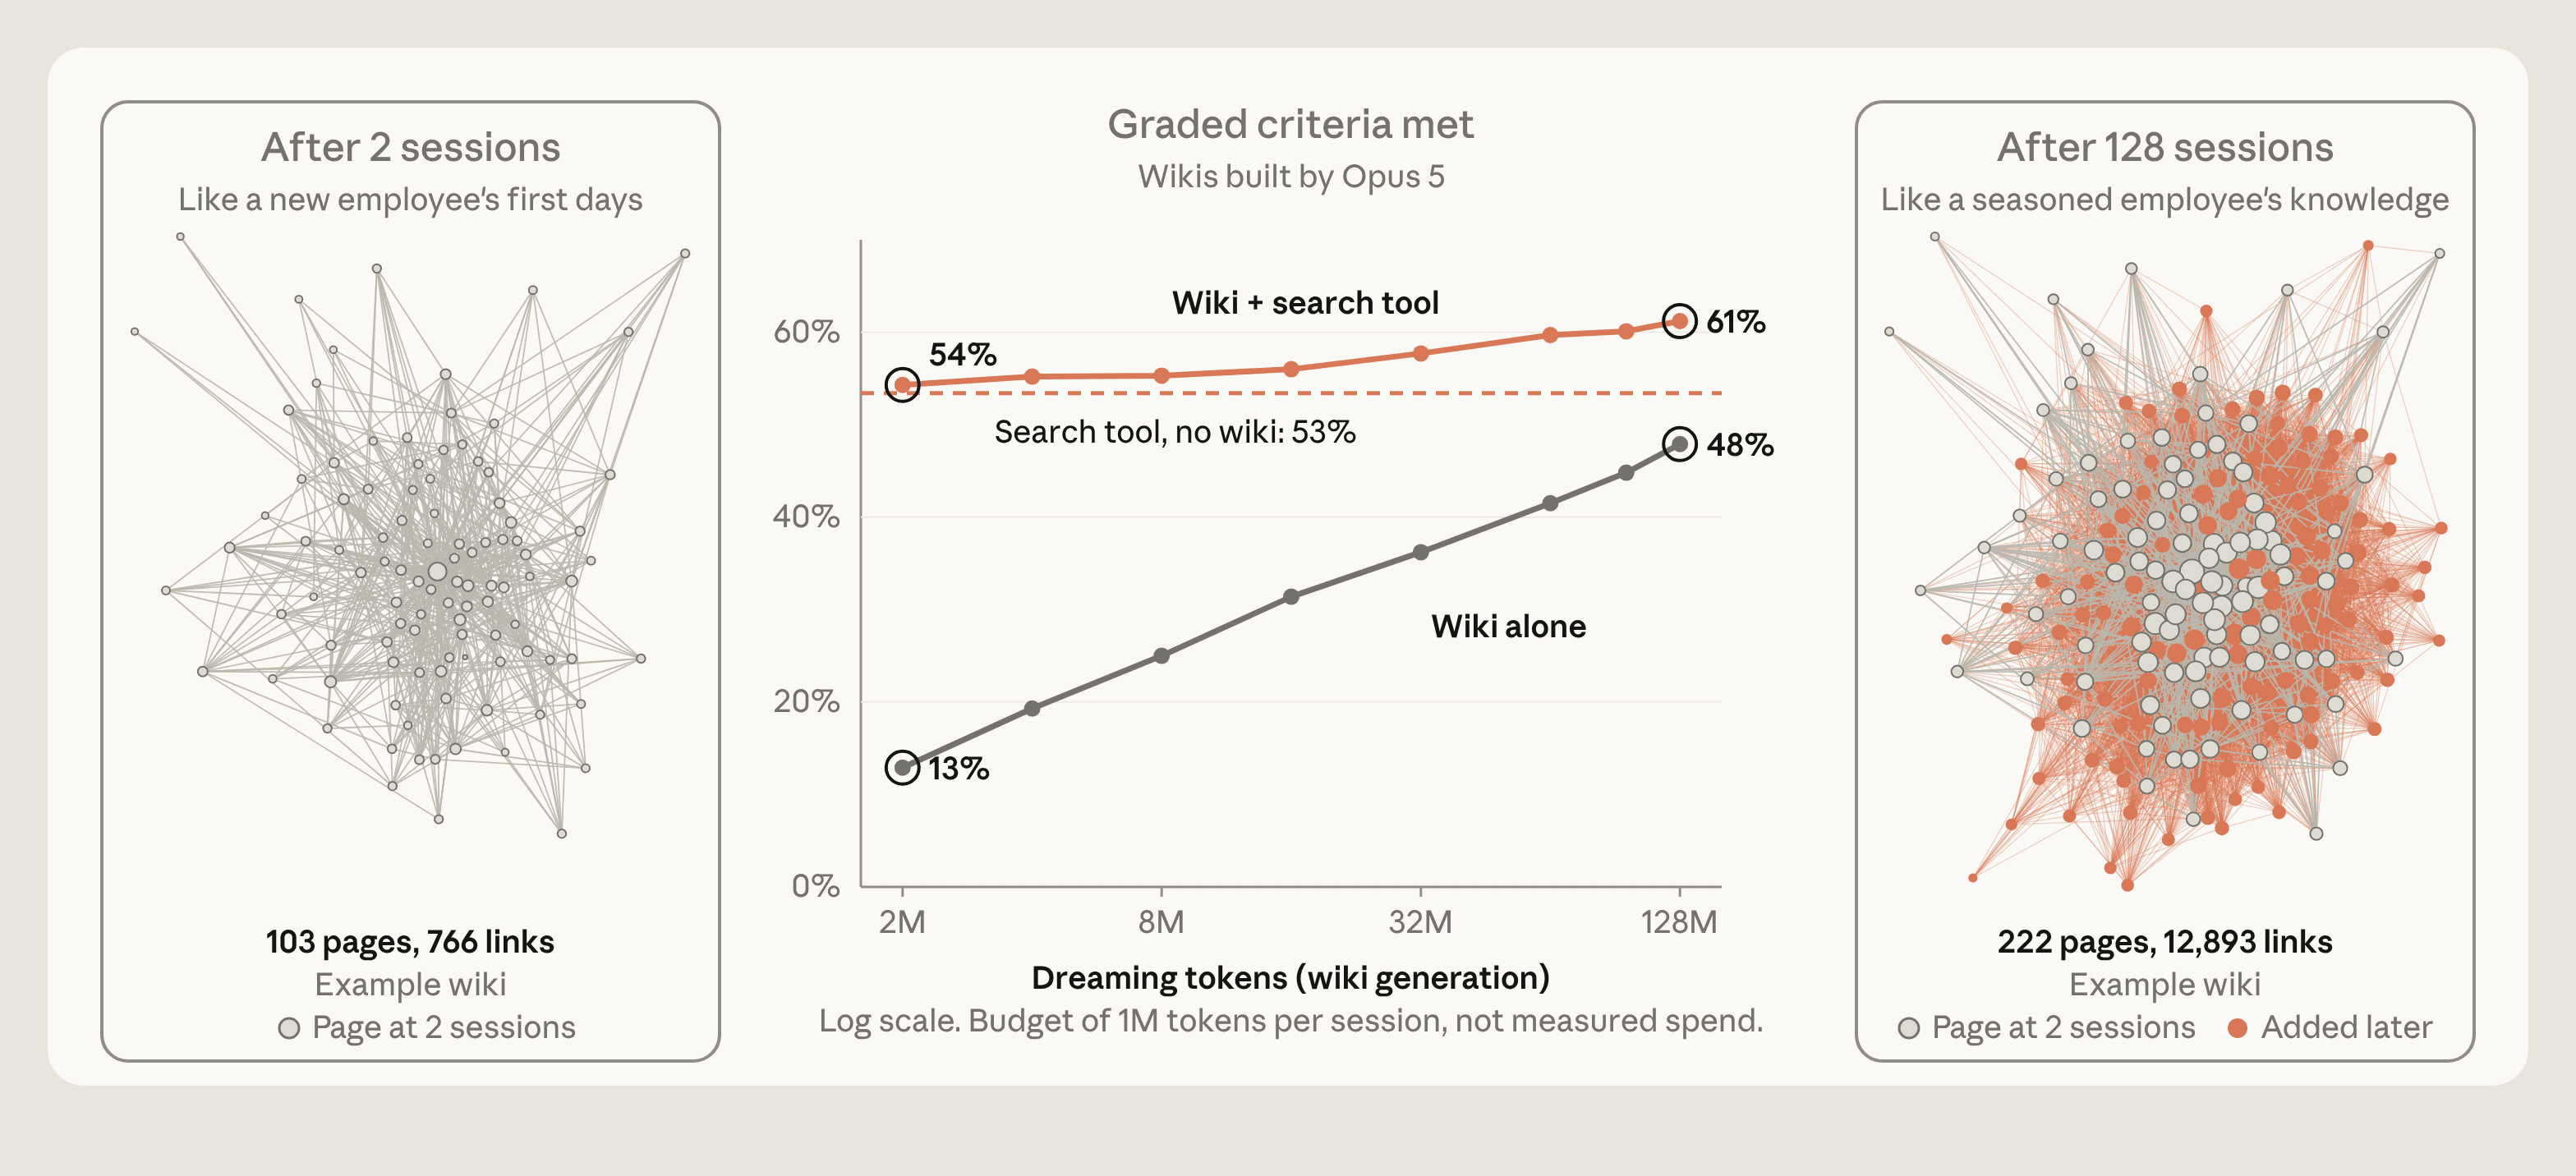
图里最关键的对照是那条搜索基线:只用搜索已有 53%,仍高于单用 wiki 的最好成绩。wiki 配合搜索才达到 61%,不能写成“做梦击败搜索”。 这组结果也不是答对题目的比例。原文还报告,组合方案每题少用约 2 万 token;这不等于总成本一定下降,前面 128 轮整理本身也要花算力。
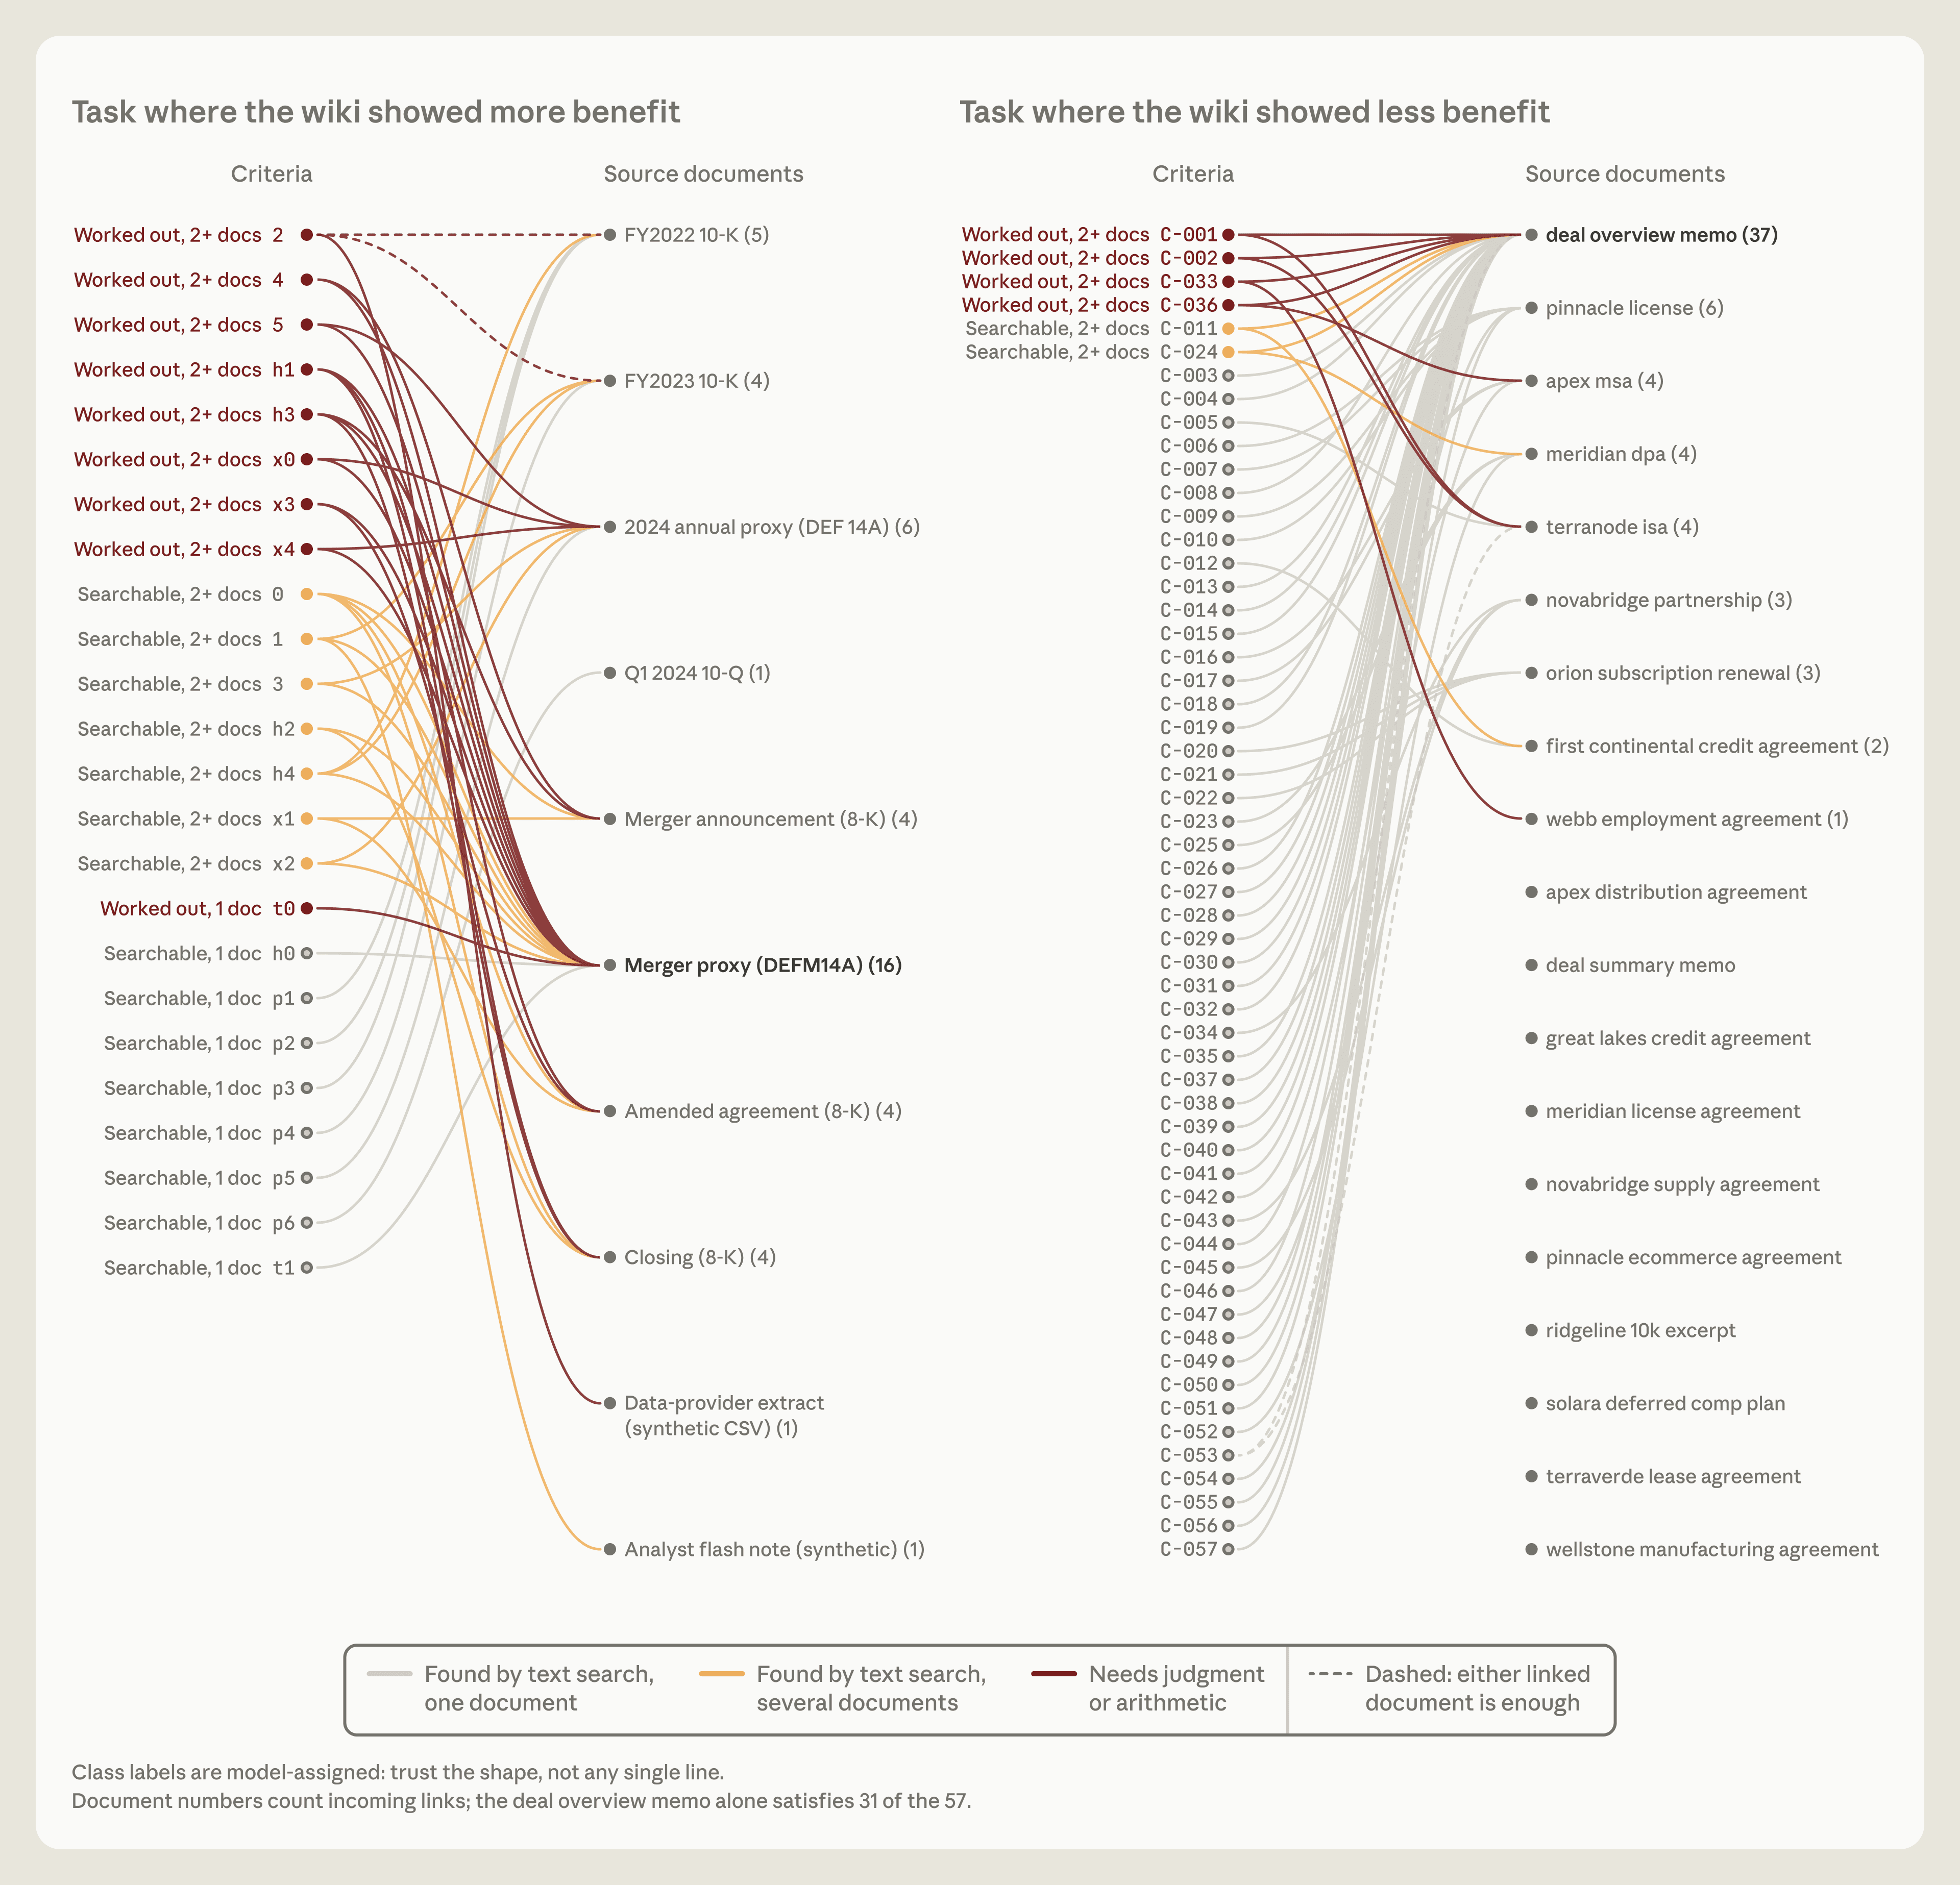
整理的价值与问题类型有关。另一组并购问答里,需要跨多份文档,或需要判断、计算的那部分题,查 wiki 得分 87%,只搜索是 73%;这不是全部 24 道题的总成绩。而在答案通常能从单份文档直接搜到的 LAB 任务中,wiki 没有显示出明确收益。
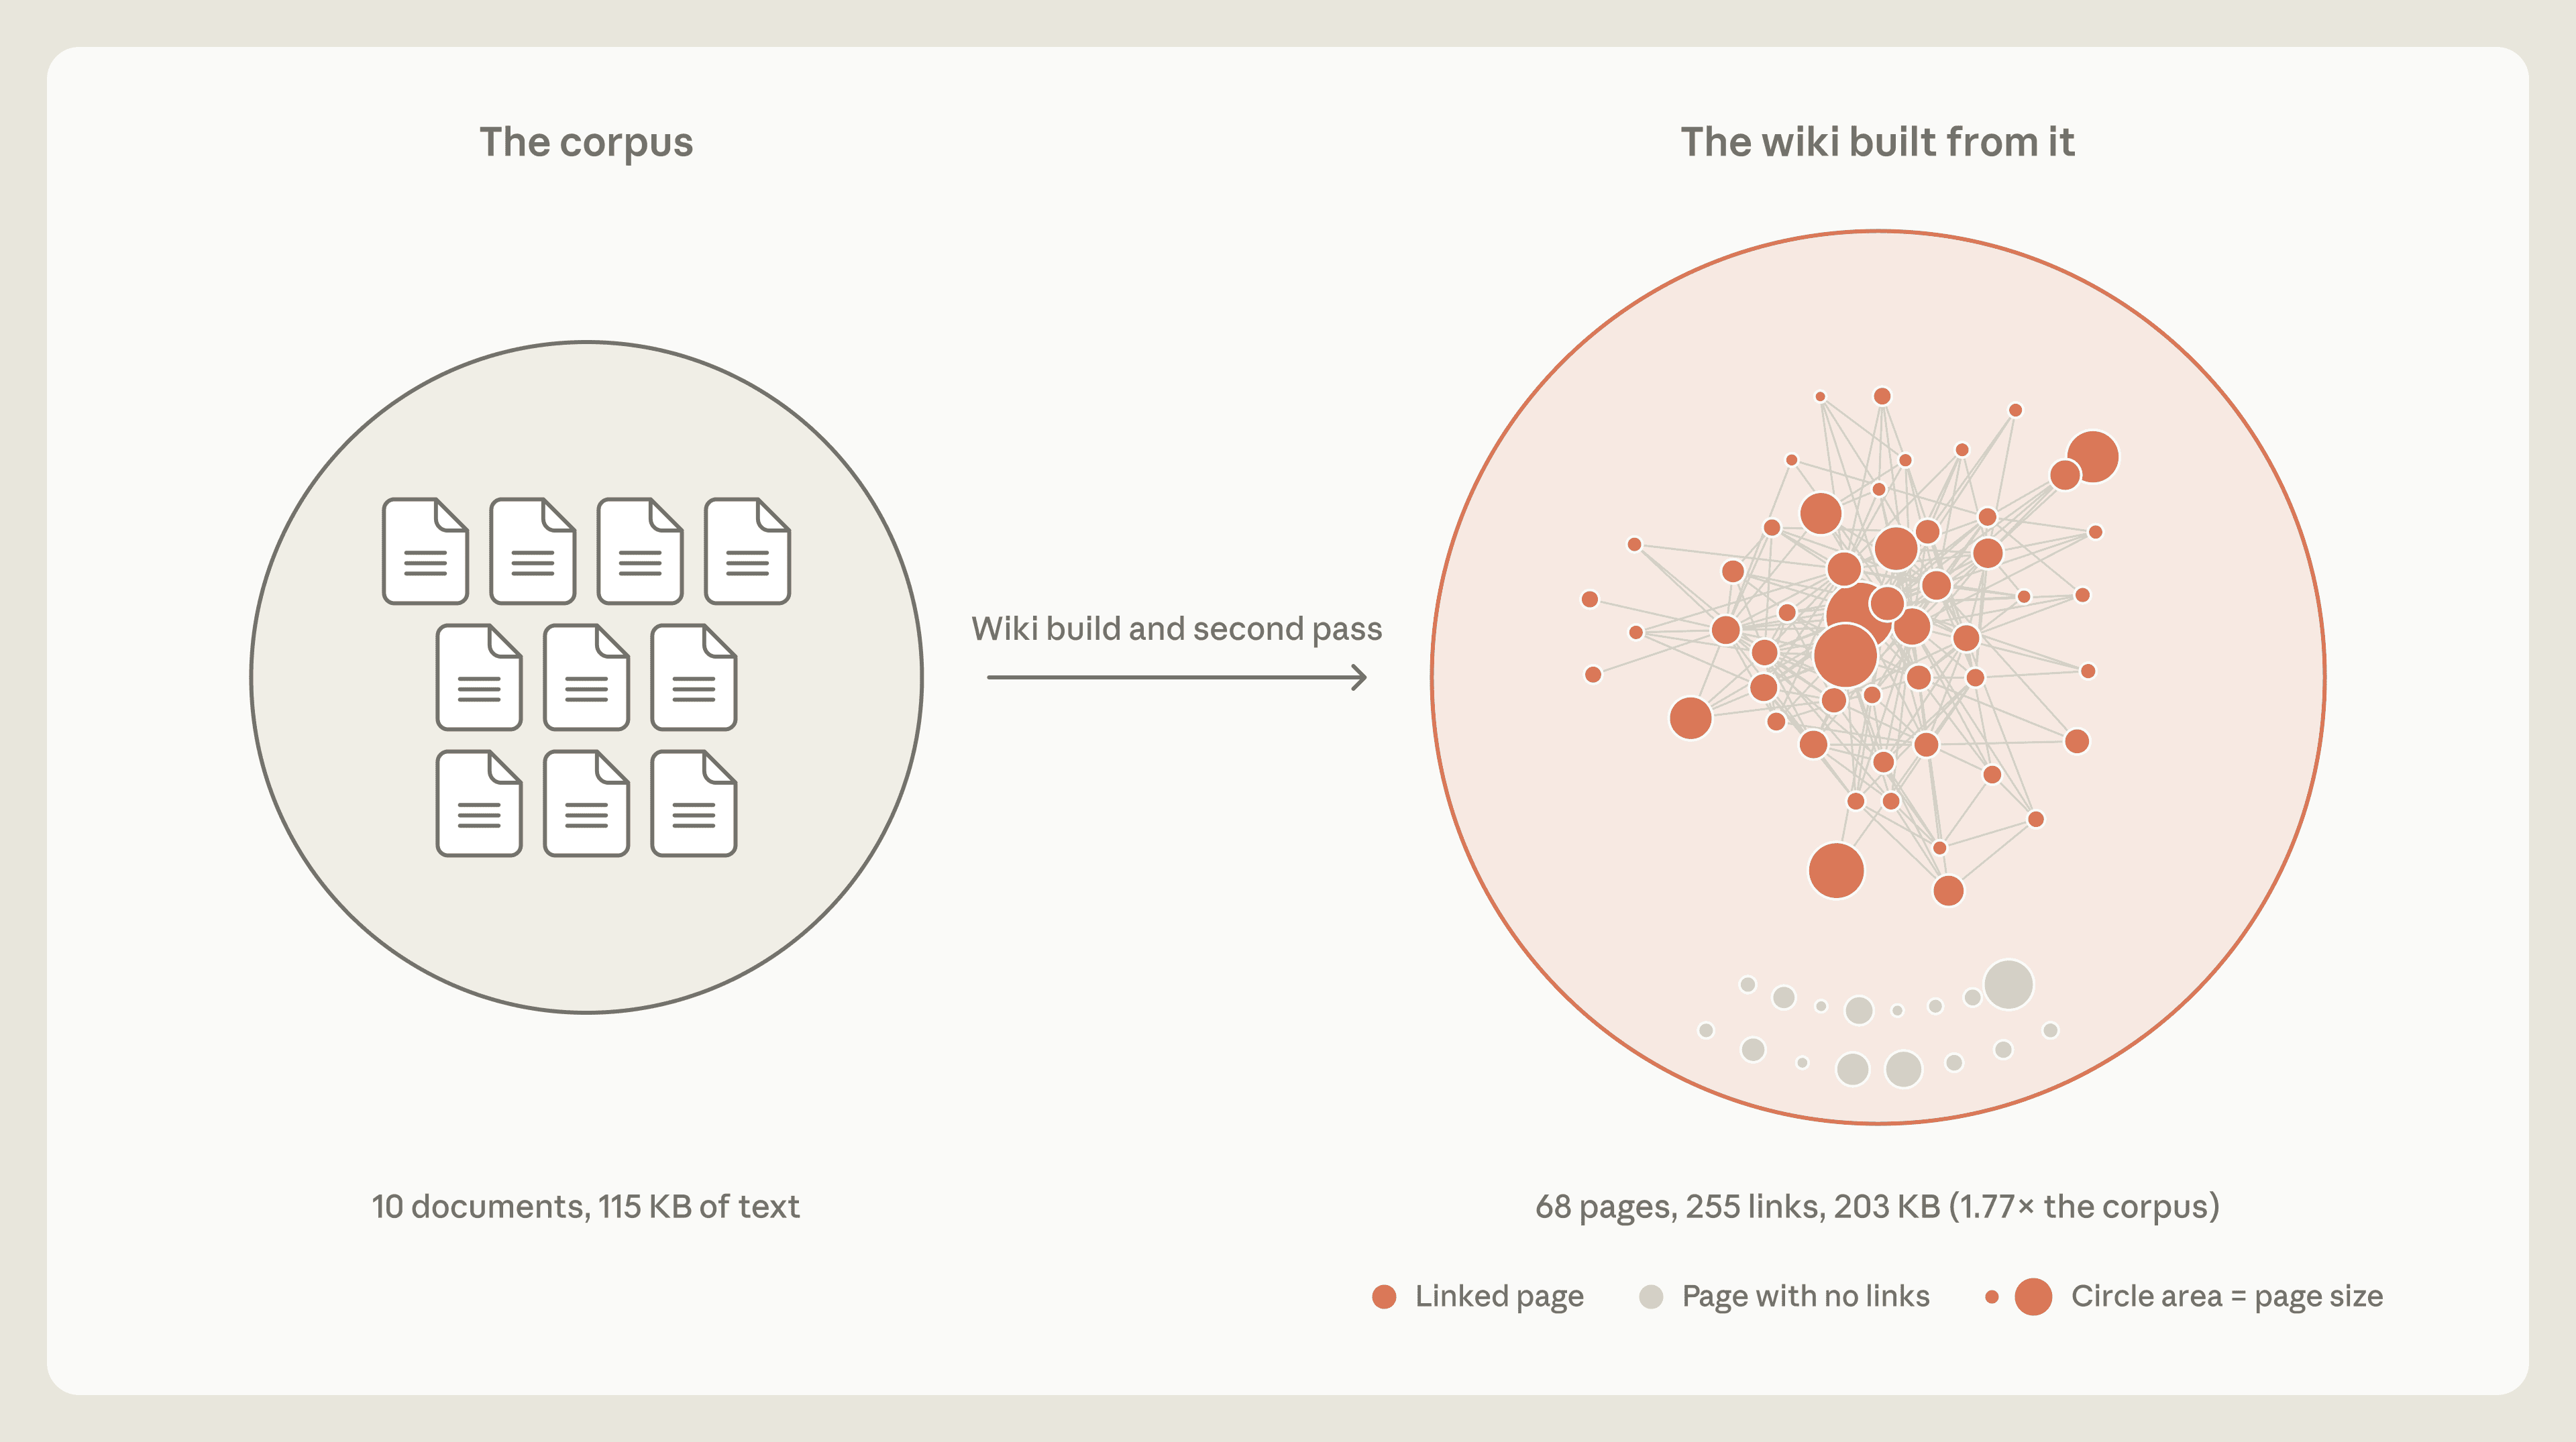
组织资料也可能过头。在另一项 LAB 任务里,Claude 建出的 wiki 比原始文件还大,几乎没有完成抽取重点这件事。它提醒我们,生成了目录、链接和页面,只能证明资料被重新排过,不能保证下一次查找更省力。
合同事实丢了,问题出在怎么写进去
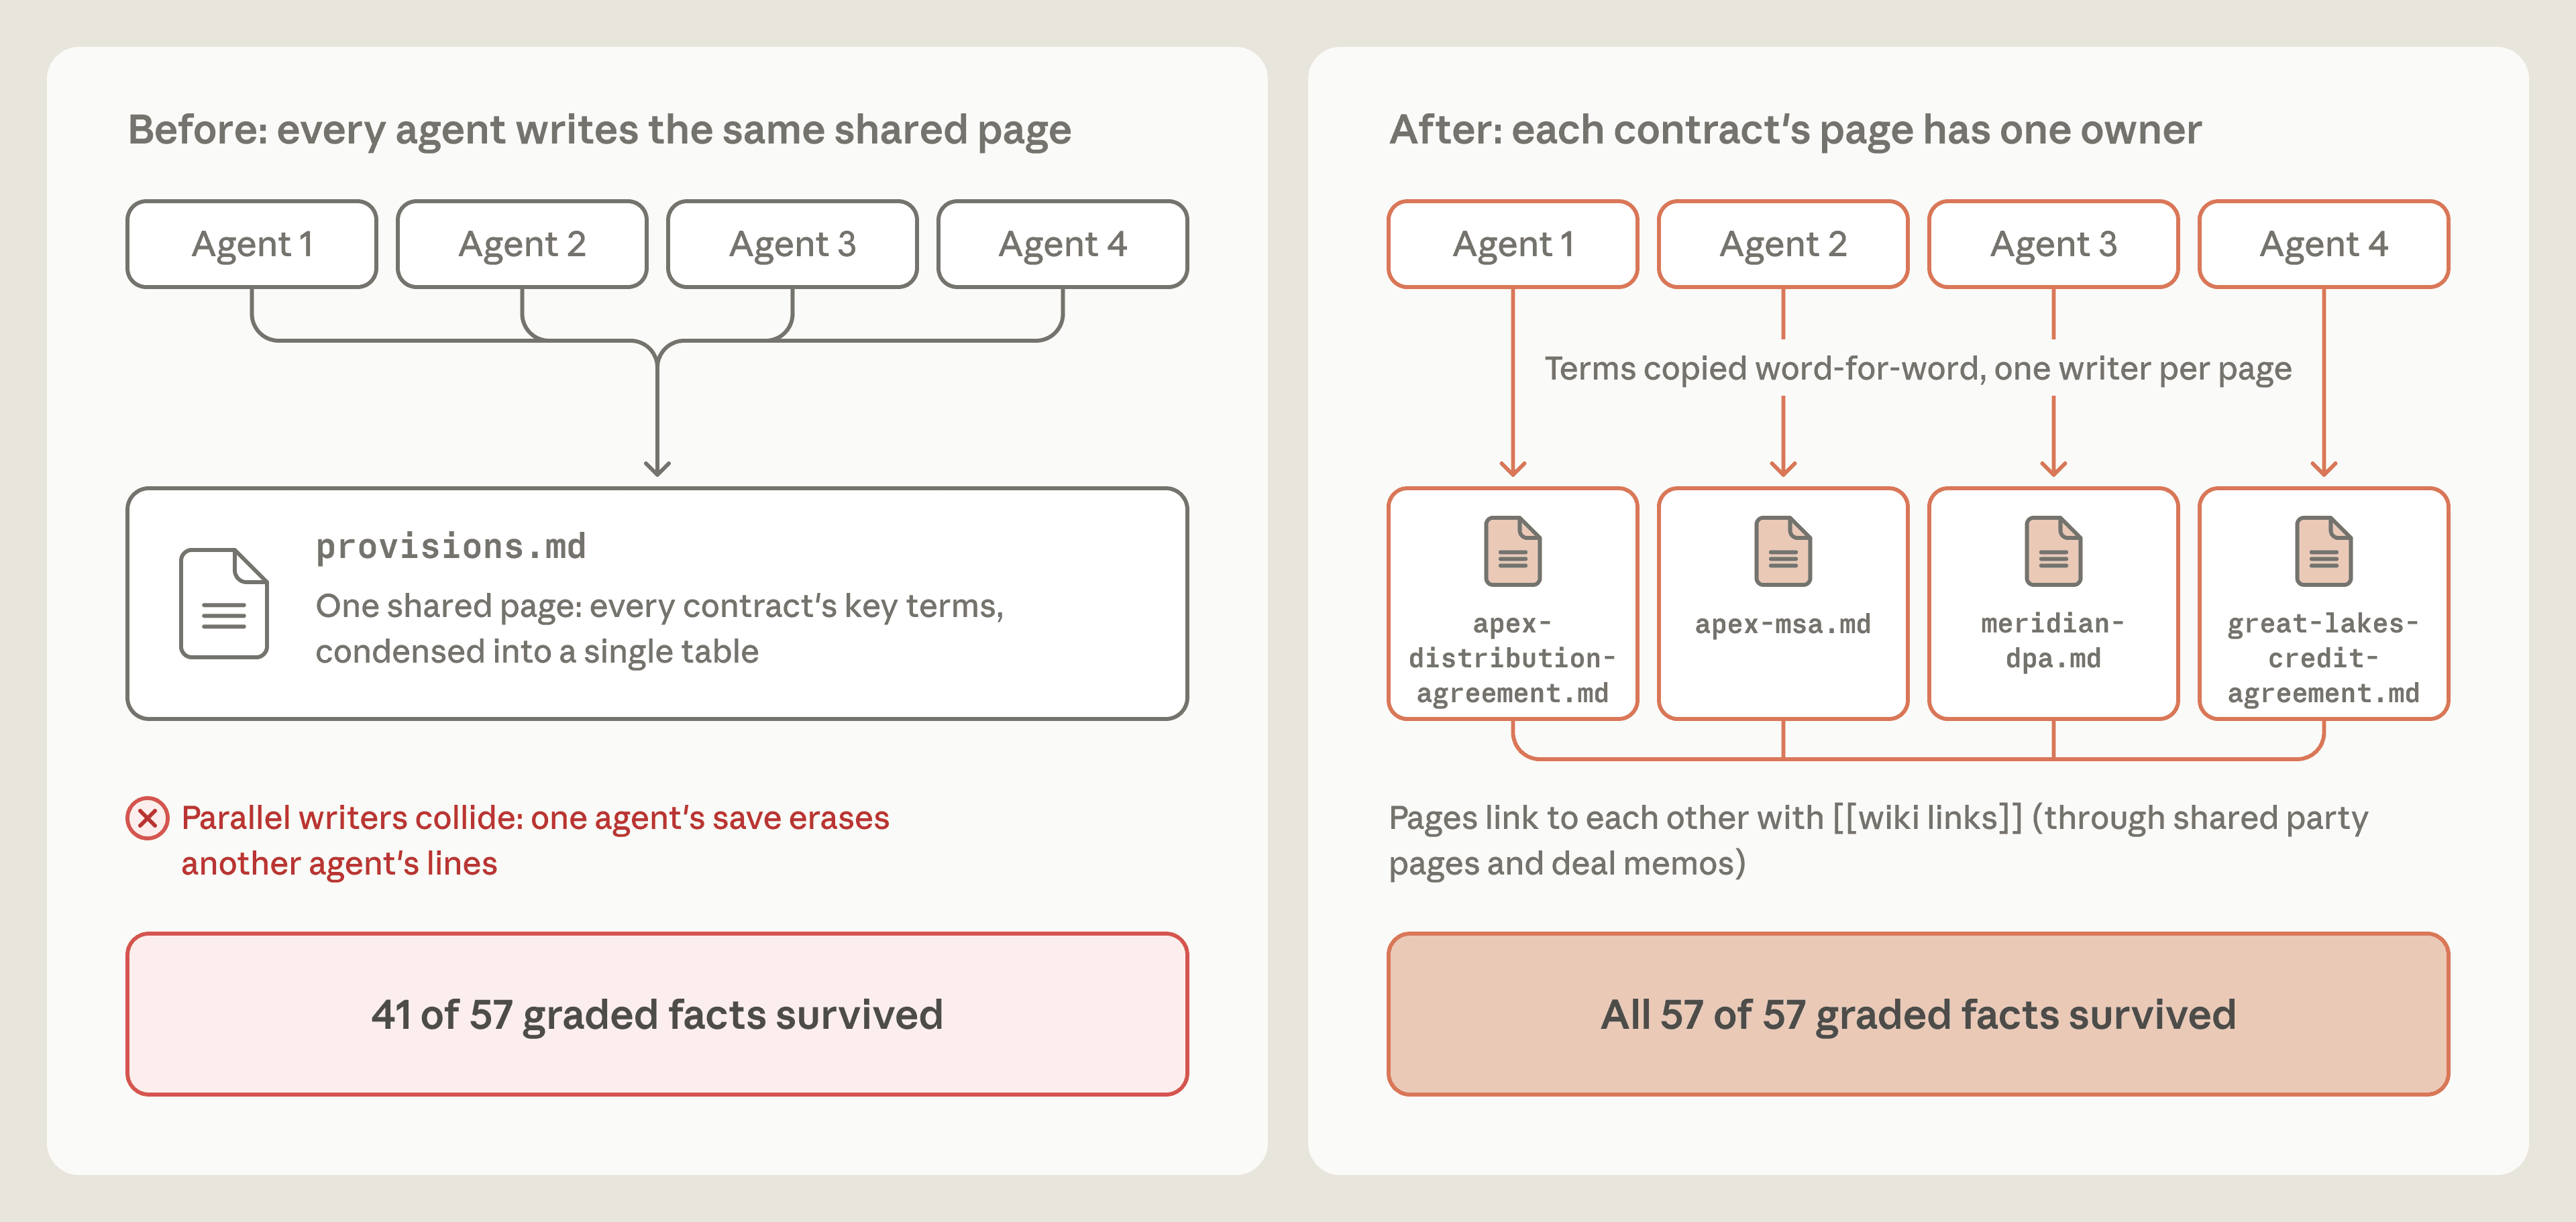
在另一项模拟公司收购的 LAB 任务中,Claude 要根据合同生成说明,评分看它有没有保住关键条款。最初几个 agent 同时往同一张共享表里写摘要,互相覆盖内容,结果只保住 57 项合同事实中的 41 项,约 72%。
研究团队让 Claude 回看失败、调整建 wiki 的要求并重建:每份合同由一个 agent 写到独立页面,条款逐字保留,不再挤到同一张摘要表里。改完后,生成说明可以满足全部 57 项评分要求。这里的 100% 仅限这项任务,不代表处理任何合同都不会漏。
它与“别规定只记失败”并不矛盾。机械限定只能记哪类经历,可能挡住有用信息;说明任务必须保留哪些事实,并修正会互相覆盖的写法,才是在解决已发现的缺陷。记忆策略应当接受任务结果的检验。
自己的记忆文件,先精简常驻的那一层
最上层的要点会在每次开场进入上下文,也就是模型当次能看到的文字。好处是不用先搜索就能想起规则,代价是每次都占空间;一条错误笔记还可能跟着进入每场会话。因此,把细节放到下层,顶层留简短索引,本身就是记忆维护的一部分。
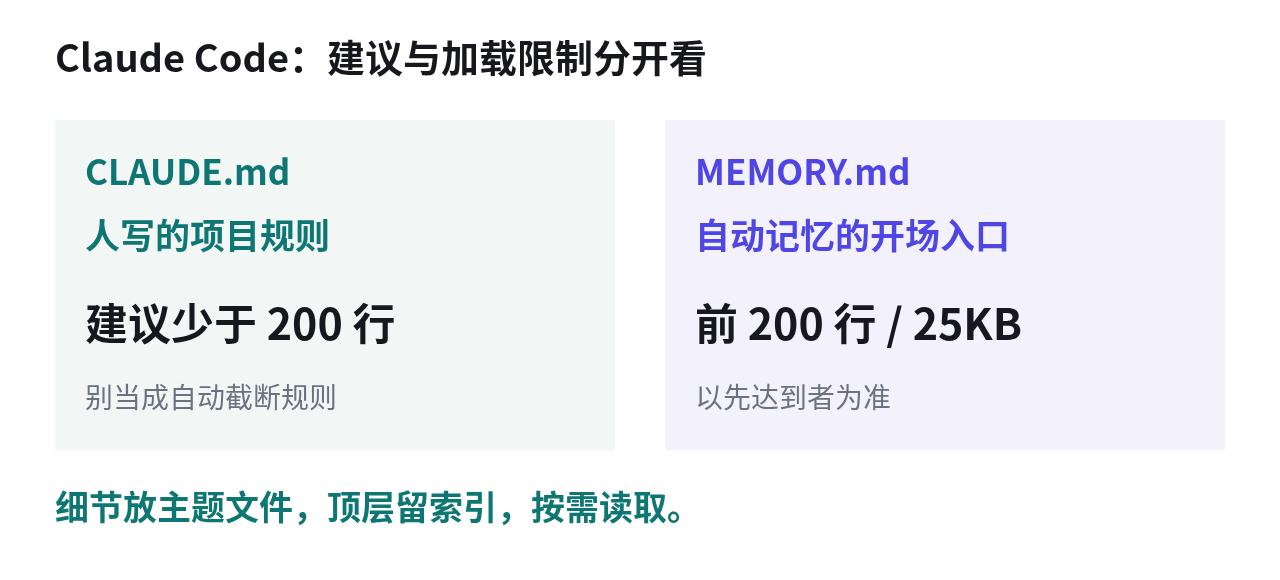
Claude Code 的官方文档提供了一个具体例子。人写的 CLAUDE.md 用来交代项目规则,建议每份少于 200 行;这是写作建议。自动记忆的 MEMORY.md 则只在会话开头加载前 200 行或前 25KB,以先达到者为准,其余主题文件按需读取。这是加载边界,两者不能混成同一种限制。
可以先检查三类内容:已经过时的状态、互相矛盾的要求,以及未经验证却写成定论的猜想。留下项目目标、稳定约束和已验证的规则,细节文件在索引里指明位置。Claude Code v2.1.283 及以上还可运行 /doctor prompt-audit 检查指令文件,它会提出修改建议,得到应用请求后才改文件;这项检查不等于自动审完所有记忆。
怎样选择复盘时机、哪些信息最容易过时、维护花费是否值得,原文都没有给出通用答案。对自己的助手,先拿一个它反复犯错的任务检验:旧笔记能否追溯到记录,修正以后是否真的少走弯路。文件变多很容易,值得留下的经验要靠结果判断。