摘要 DeepSeek把搜索、读链接和文件输入接入deepseek-flash,由服务端执行工具并拼接上下文。文件解析只收一次,引用仍算Token;工具与模型分别计费。前端展示、历史回传和安全责任仍由开发者接好。
一份财报上传后,用户先问正文里的经营变化,接着追问营收趋势图,还想补查网页上的新信息。要在自己的聊天应用里接住这些问题,过去除了调用模型,开发者还得接文件解析、搜索和抓取,再把结果整理给模型。DeepSeek这次开放应用API,正是把这段衔接工作交给服务端。
联网搜索:模型找资料,服务端接着往下做
11月13日,DeepSeek宣布开放“全家桶应用API”。API是供程序调用的接口;这次开放的重点,是把App里配合模型工作的搜索、文件输入、读链接等能力交给开发者。目前明确支持的是V4.1-Flash,模型名用 deepseek-flash,可通过Messages、Responses和Chat Completions三种接口协议调用。
公告写了“甚至 1:1 复刻出完整的 DeepSeek App”,随后又将能力表述为“使用上述接口,开发者即可实现与 DeepSeek App 基本一致的功能”。理解这两句话,要看开发者少做了哪一步:打开相应工具后,工具调用和上下文拼接都由服务端完成。 上下文就是模型当前作答时能看到的材料;开发者不必再手动把每份搜索结果、文件内容塞回对话。
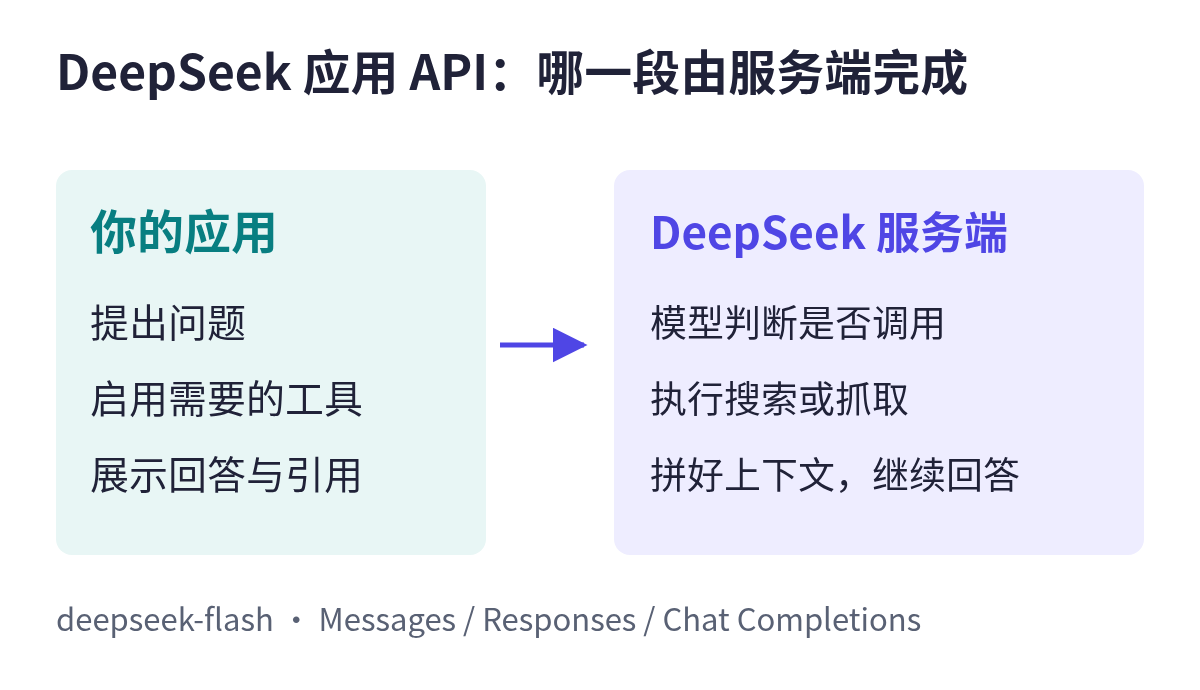
联网搜索的开关叫 deepseek_web_search。在非思考模式下,模型可按问题发起网页或图片搜索,再带引用回答;在思考模式下,它能分多步搜索、打开网页、在页面内查找,然后继续推理。打开工具代表允许模型使用,并不强制每个问题都搜索。用户直接贴来链接时,可启用 deepseek_read_url,让模型选择并读取消息中的网页;思考模式若同时启用联网搜索,本轮走深度搜索,不单独执行用户链接的阅读。
多轮对话还要分清材料会留下多久。搜索结果、深度搜索打开的网页和前轮思考过程不会作为这些中间材料带入下一轮,保留的是最终回答;独立读链接得到的网页正文会加密放进返回的 signature,原样回传后可恢复到后续上下文。客户端应保留完整内容块,不能只留下看得见的回答文字。
读文件:上传一次,后续提问仍要算用量
官方文档用一份带营收趋势图的财报说明解析方式的区别。选 text_recognition,模型只拿到文字,图表会被丢弃;选 rich_layout_recognition,解析器会裁出识别到的图,按原位置和文字一起交给模型。后者适合问“这张图说明了什么”,但不保证每张图都能被识别,裁出的图片也会占用输入Token。Token是模型处理文字、图片等内容并计费的单位。
调用分两步:先上传PDF、Word、幻灯片或图片,解析成功后得到 file_id,再在对话中引用这个文件编号。需解析的文档不能直接塞一个文件网址来代替上传;历史消息里引用的文档内容会完整留在多轮上下文中,超限会报错,不会悄悄截短。
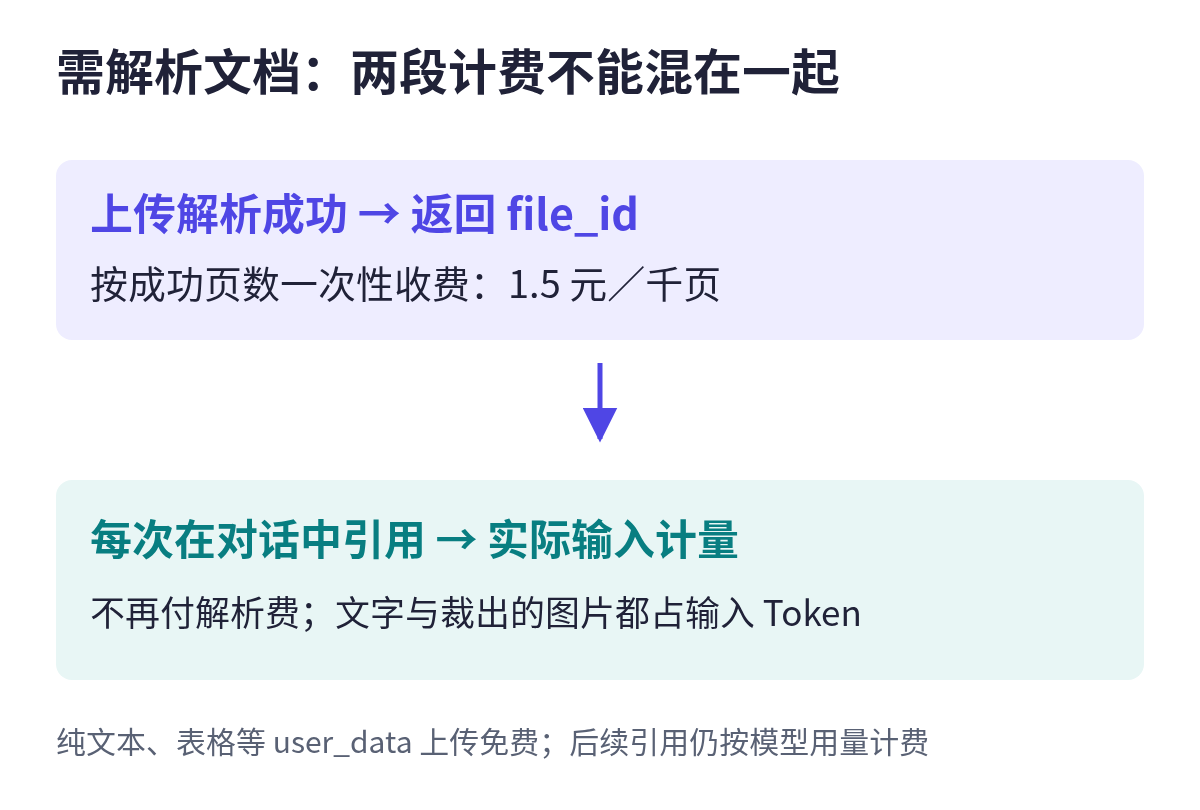
这里有两笔不同的钱:文件解析按成功页数一次性收取,价格是每千页1.5元;复用同一文件不再收解析费,但每次引用都按实际输入Token计费。 纯文本、表格与电子书另有 user_data 上传方式,这类上传不计费,不能把所有Office文件都算成付费解析。免费上传同样不等于后续让模型阅读免费。
算账:模型Token之外,还要加工具费
给一段问答加上搜索,账单会同时出现模型调用用量和工具调用用量。当前文字搜索、图片搜索与网页抓取的单价均为每千次5元;具体怎样算“一次”要看工具规则,例如文字搜索按成功返回结果的查询词组计数,一次工具调用带多个查询词组,可能计多次。深度搜索首次抓取网页收费,对已返回页面的重复打开、翻页和页内查找不另收抓取费。
deepseek-flash的Token单价还分时段。以人民币每百万Token计,高峰时输入缓存命中0.04元、未命中2元,输出8元;空闲时分别是0.02元、1元和4元。缓存命中指输入中的可复用部分被服务端缓存复用,不能把全部输入默认按最低价估算。
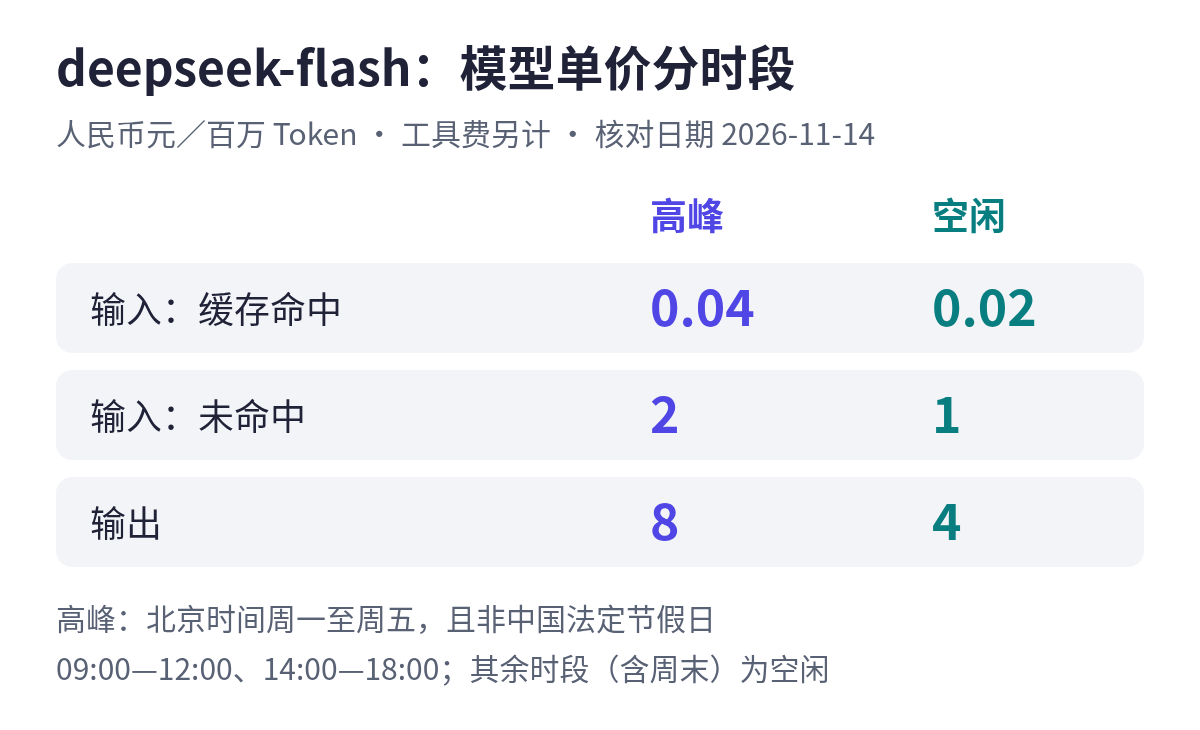
高峰是北京时间周一至周五且不含中国法定节假日的09:00—12:00、14:00—18:00,其余时段,包括周末和法定节假日全天,均为空闲。这一半价规则说的是模型Token单价,不能顺手套给搜索、抓取或文件解析费。旧名称 deepseek-v4-flash、deepseek-v4-flash-vision-exp 仍可调用,但对应旧模型已下线,请求实际由DeepSeek-V4.1-Flash-1017处理,按Flash价格计费。
除了随对话使用,Search搜索、Fetch抓取、OCR文字识别、ASR语音识别、TTS语音合成都有独立接口,可按自己的流程组合。独立Search目前不支持图片搜索;独立OCR返回识别结果,也不会自动把文件保存给对话使用。
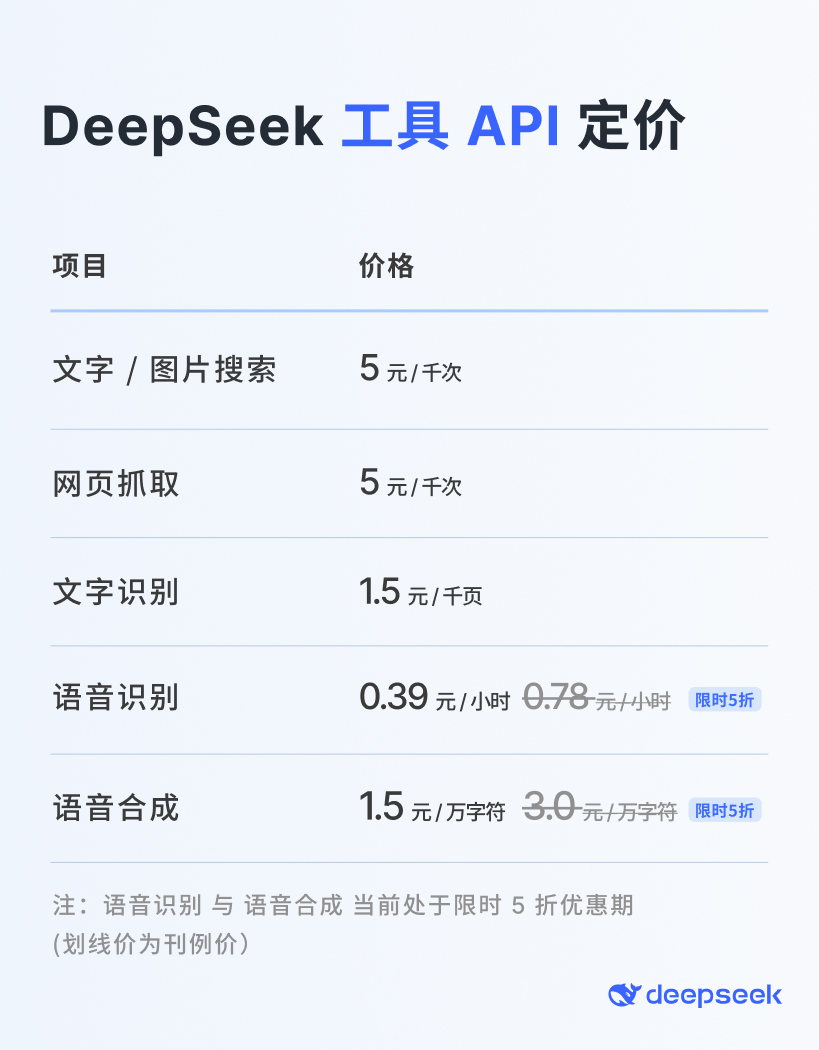
截至11月14日,TTS刊例价为每万计费字符3元,限时价1.5元;ASR刊例价为每小时音频0.78元,限时价0.39元,官方未写明这轮优惠的截止时间。TTS中一个汉字算两个计费字符;ASR的“每小时”是计价单位,当前单次音频上限为120秒。把这些口径与实际Token用量分开记录,才容易看清一个对话功能到底花在哪里。
做成应用:界面、历史和安全处理仍需接好
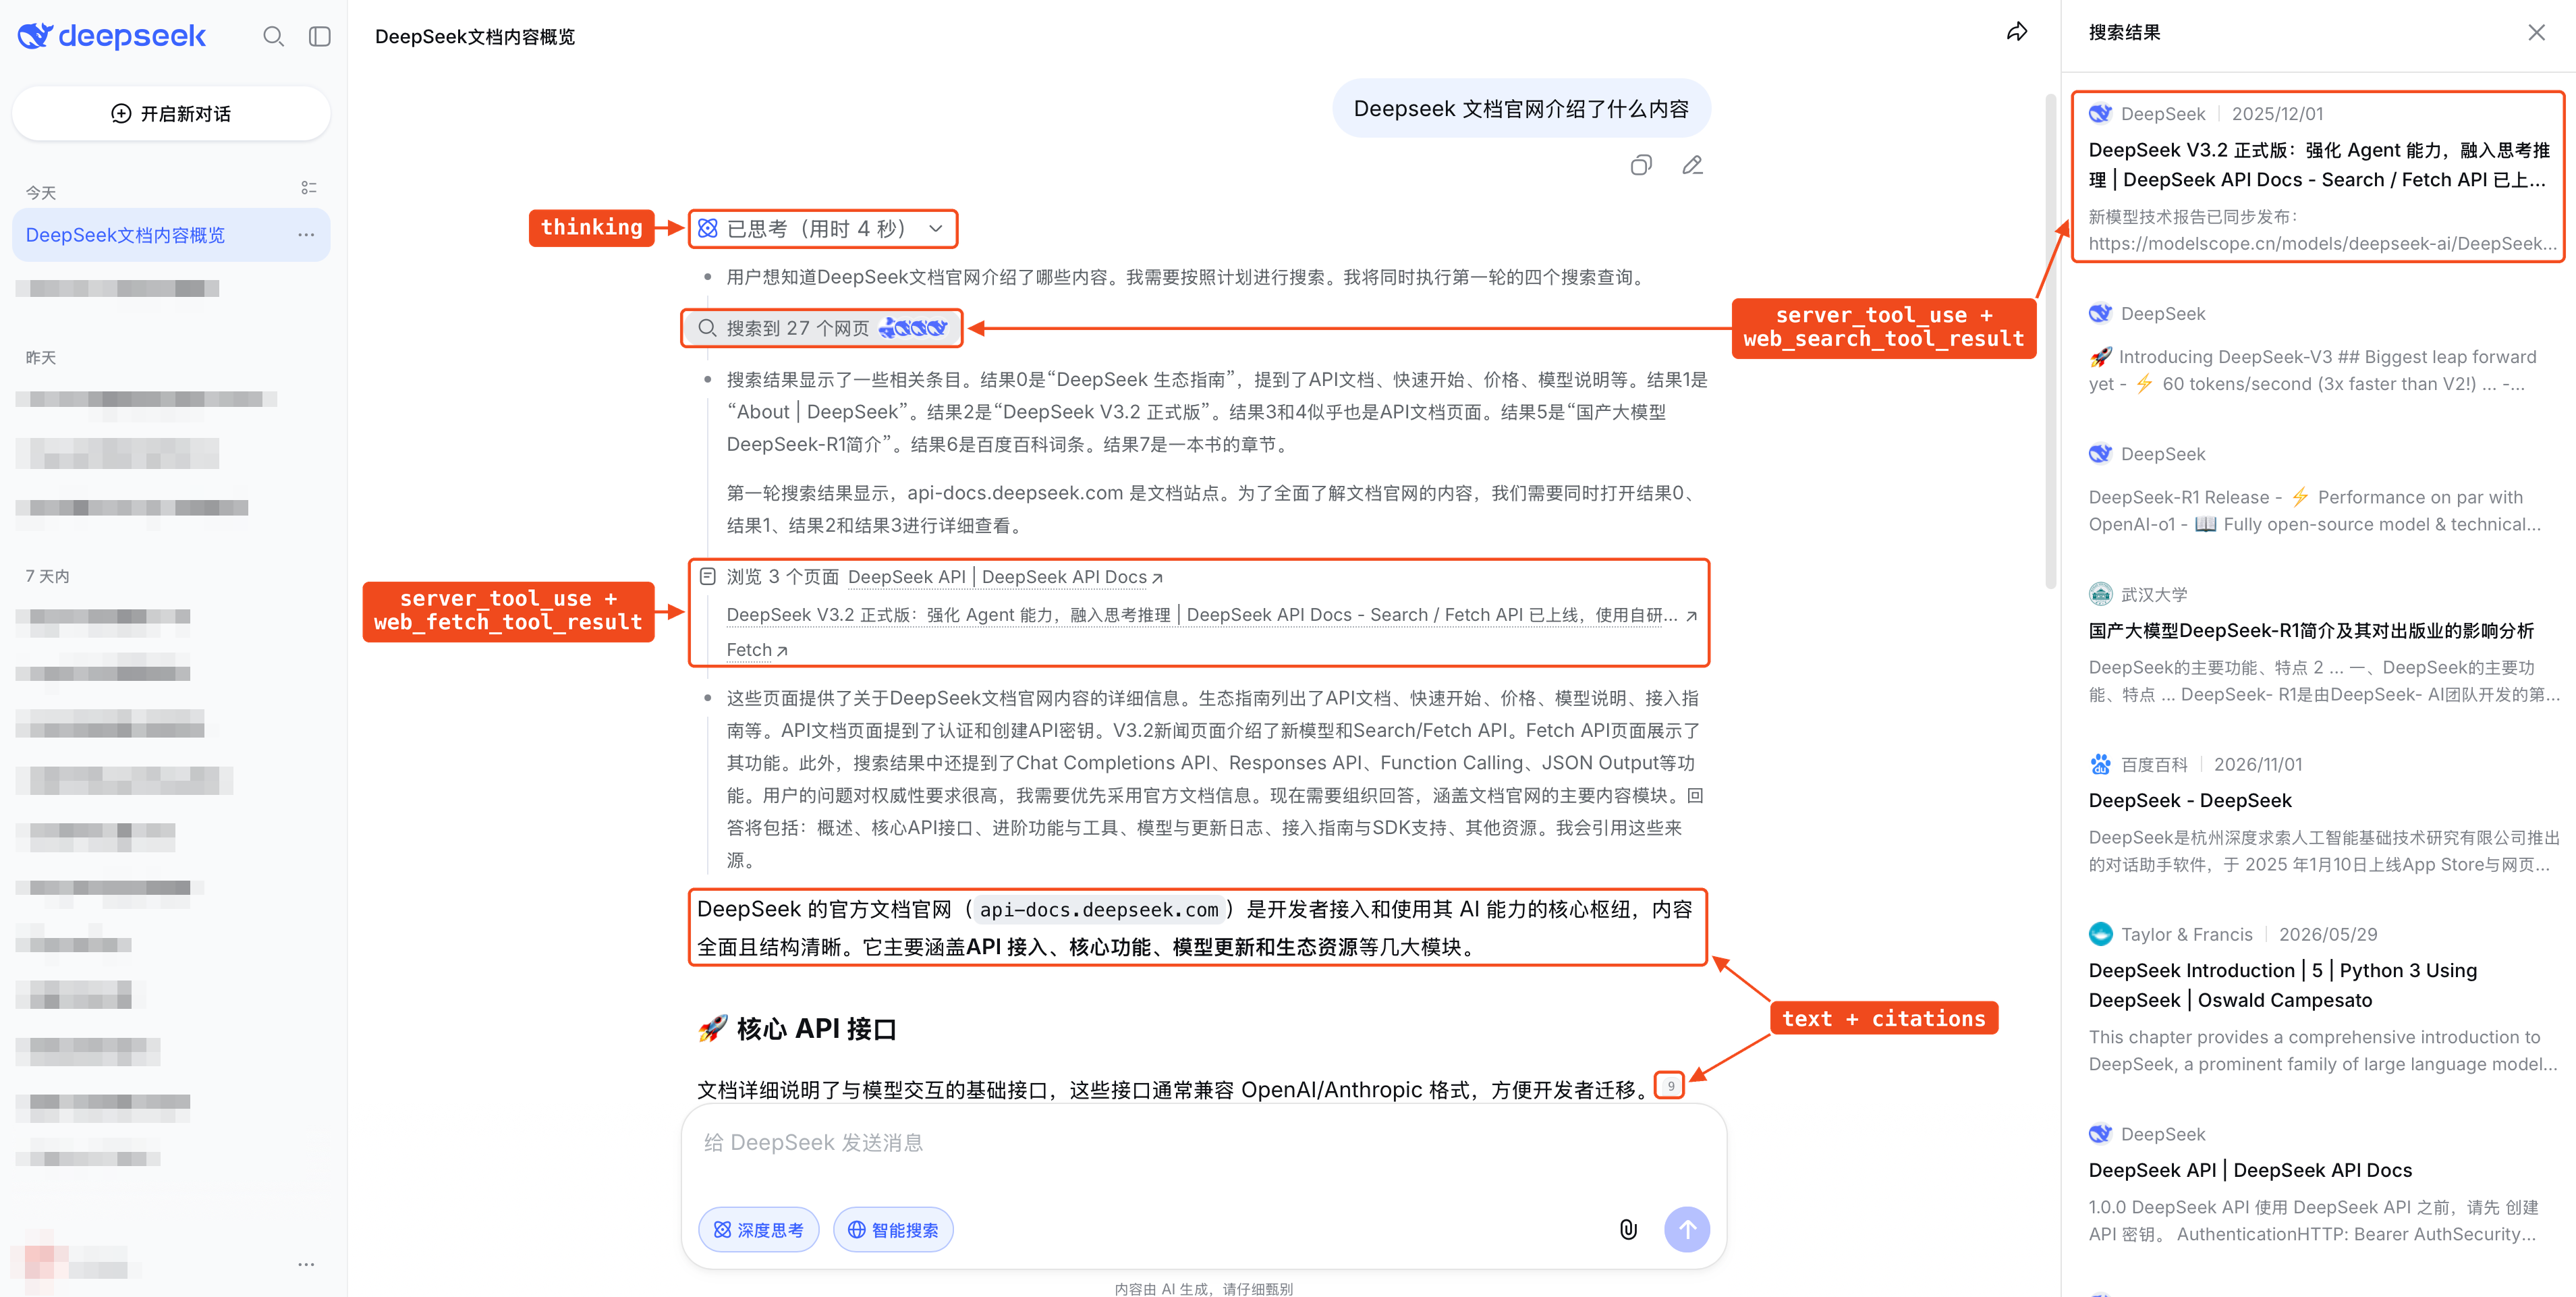
服务端把搜索和阅读接起来后,前端仍要理解返回的内容。官方Chatbot指南把思考、工具调用、搜索结果、回答和引用分别表示成内容块,界面可以据此显示“正在搜索”、展开资料并标注引用。下面这张官方示意图说明的是如何呈现内容块,并非本文对新版API的实测结果。
DeepSeek还宣布基于新版API构建并开源了一份轻量前端Demo,支持直接导入DeepSeek历史对话。公告给的是演示入口和示例代码;它能帮助理解这些接口如何配合,不能据此认定完整生产应用所需的工作已经完成。
对外提供应用服务时,官方要求开启 safety_check 的 high 档,提供输入输出的基础风控,并由开发者承担内容安全审核、大模型登记、AI标识等义务。low 档与不传该参数一样,不能当成已经开启这套增强校验。
这项责任会直接落到界面行为上:完整输出结束后,服务端还会审核,之前流式显示出来的文字可能最终被拒答。客户端需要删除已展示的回答,换成自己的拒答文案;安全审核产生的Token也按输出Token计费。接口减少了接外部工具和搬运材料的工作,开发者仍需把展示、历史回传、拒答与费用统计做完整,才能让这些能力在自己的产品里稳定配合。