摘要 Neon面向复杂而高频的代码与分析工作,Pro、Ultra和付费API已开始开放。官方称默认High档任务成本低于Carbon32%,但Neon单价仍高于Carbon当前促销价。第三方评测显示,速度、用量和完成质量也要分别看;Antigravity新增的双模型分工,提供了另一种控制成本的方式。
把项目里的旧依赖升级一遍,难处通常在两头:开头要判断哪些接口会受影响,结尾要确认改动没有把原来的功能弄坏,中间还夹着大量重复修改。Google给Gemini 4 Neon安排的位置,正是这类复杂、又要经常做的工作。它的发布公告强调“每项任务更省钱”,而价表显示,它现在的单价比促销中的Carbon更高。这两句话可以同时成立,关键要看算的是哪笔账。
付费用户开始拿到Neon,入口各有条件
北京时间11月19日05:00,Google发布Gemini 4 Neon,并开始逐步开放。它面向复杂、又需要经常做的编程、分析和企业工作:Carbon继续承接最难、周期最长的项目,Hydrogen负责快速日常执行,Neon试图在推理深度和完成速度之间取得平衡。
已有Google AI Pro或Ultra订阅的用户,可以在Gemini应用的模型下拉框选择Neon,也可在AI Studio直接试用;Antigravity的桌面应用、CLI命令行和IDE扩展同步开始开放。开发者可通过AI Studio、Android Studio使用付费Gemini API,调用型号为gemini-4-neon;企业入口是Gemini for business的API或模型下拉框。开始开放不代表每个账号立刻可见。 使用还需具备访问Google服务的条件,公告没有宣布中国内地独立入口。
免费API档没有Neon。在当前定价页列出的Carbon、Argon、Neon和Hydrogen这组Gemini 4模型中,只有Hydrogen提供免费档。订阅内的试用与API按量付费也应分开理解,不能把Pro、Ultra可选模型理解为获得无限API调用。
在Gemini应用里,Google强调它能读取表格、PDF、图片,结合网页和Gmail、Docs等材料整理报告;Tasks也开始支持Neon。官方说这有助于让额度更耐用,但没有给每个用户一项任务固定扣多少额度的承诺。
Neon单价高于Carbon促销价,低于其标准价
Token是模型处理内容的计量单位,不等于中文字数。单价回答“每处理一份内容收多少钱”,任务成本回答“把整件事做完一共花多少钱”。Neon当前Standard标准档每百万Token输入3美元、输出15美元,输出价包含思考Token;隐式缓存命中的输入为0.15美元,是普通输入价的5%。隐式缓存由服务识别可复用内容,Neon不支持显式创建缓存。
Carbon和Argon的促销到11月30日结束,当前输入、输出、缓存价分别为2、10、0.10美元;12月1日起变为4、20、0.20美元。按当前促销价比较,Neon的输入和输出单价更高。 相比促销结束后的Carbon标准价,Neon这两项才低25%,这是按价表计算的结果。
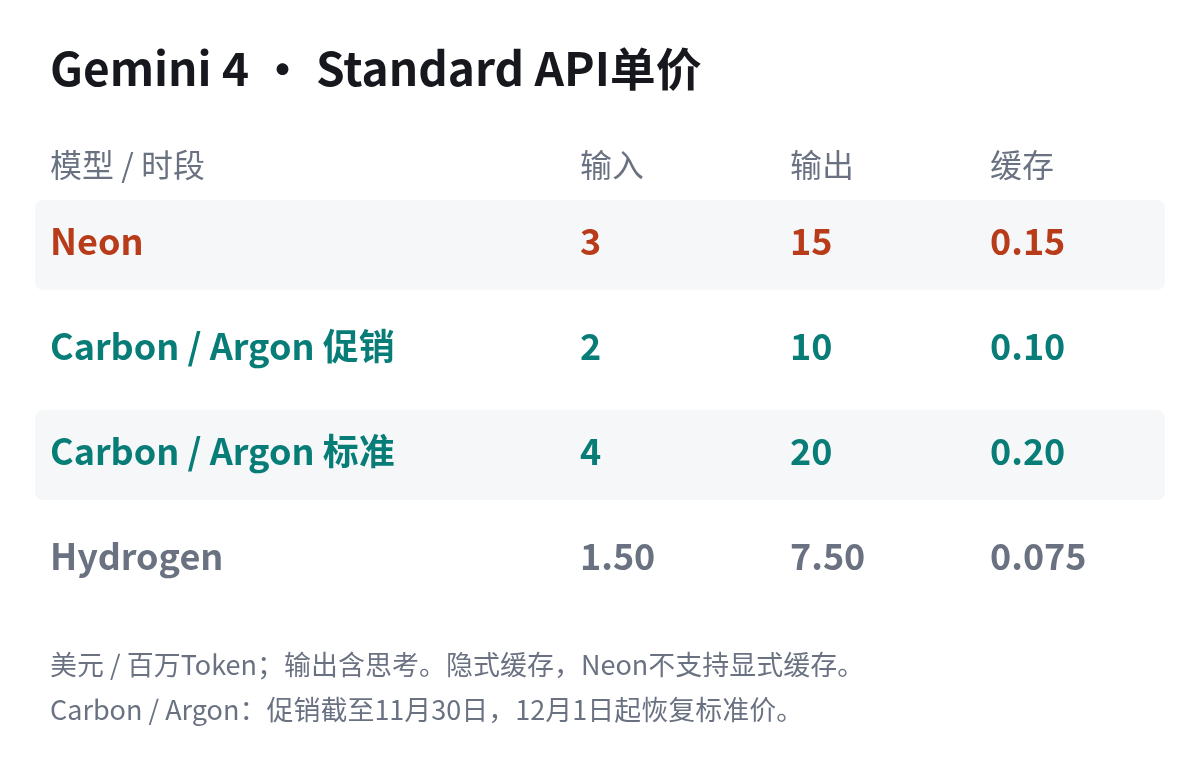
假设一次请求输入10万Token、计费输出1万Token,没有缓存和工具费,Neon收0.45美元,当前促销中的Carbon收0.30美元,Carbon恢复标准价后则是0.60美元。这笔假设账只比较同样用量;实际任务中,推理长短、工具返回内容和重试次数会改变用量。
以上是Gemini Developer API的Standard价格,不能直接套到企业平台或订阅额度。当前Neon专属价表也已列出Batch批处理档:输入1.50、输出7.50、缓存0.075美元/百万Token。它是另一档明确列出的价格,比较账单时要同时写明所用档位。
官方32%与第三方17%,比较的条件不同
Google的发布公告称,Neon在默认High思考档,单任务成本比Carbon低32%。思考档决定模型愿意花多少推理预算;Neon提供从Low到Extra High的四档,最高档也写作xhigh。官方这句32%带有默认档位和评测条件,不能拿来当作API单价降幅。
第三方Artificial Analysis(下称AA)的智能指数把多项任务汇总成分数,并统计这组任务的成本。Neon用xhigh时得61分,Carbon用high时得60分;每项任务分别为6.44和7.76美元,约低17%。这里的Carbon按4、20美元的非促销标准价计算。Neon改用high,智能指数同为60分,任务成本是3.74美元,不到Carbon标准价口径的一半。
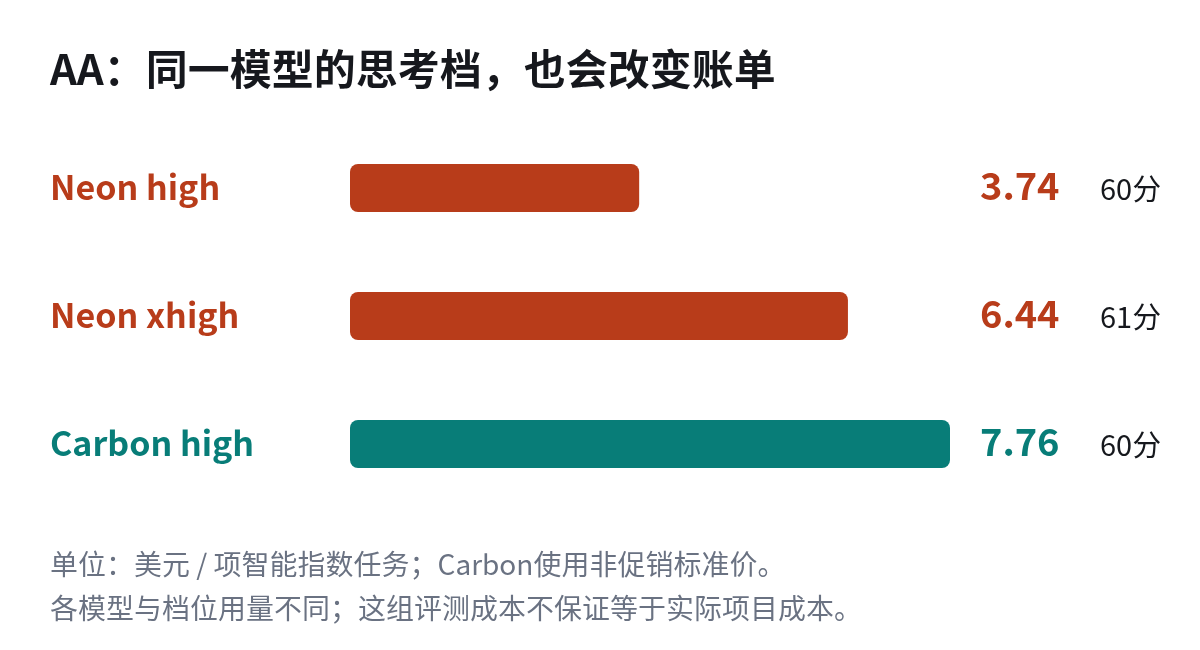
因此,官方32%、AA的xhigh约17%、AA的high不到一半,要各自保留比较条件,不能拼成一个统一折扣。AA还给出GPT-6.2 Astra在max档每项任务4美元,Neon xhigh约为其1.6倍;“比Carbon低”也没有证明它比所有模型便宜。
速度同样值得拆开。AA发布帖称,Neon xhigh的输出速度约为110 Token/秒,Carbon high约57 Token/秒;前者每项评测任务的输出Token反而多约15%。输出更快,不等于少用Token,也不能保证换成你的项目还能省相同比例。
在Antigravity里,把规划与常规执行交给不同模型
以升级项目依赖为例,需要判断哪些接口受影响,也需要逐项改代码、更新包和跑测试。这是理解分工的一个场景示意:并非每一步都需要同样深的推理。Antigravity这次让Orchestrator(任务调度器)在同一会话里配对Neon和Hydrogen,前者做规划、架构判断和复杂推理,后者接手常规代码修改、包更新与测试运行。
关键在于遇阻后的交接。Hydrogen执行不顺时,会把状态交回Neon;Neon检查当前结果、修订计划,再让执行继续。用户不用在中途手工切换模型。它可能把较贵的判断用在真正需要的环节,把重复操作交给更快的模型,但最终是否节省,仍要看交回的结果和总用量。
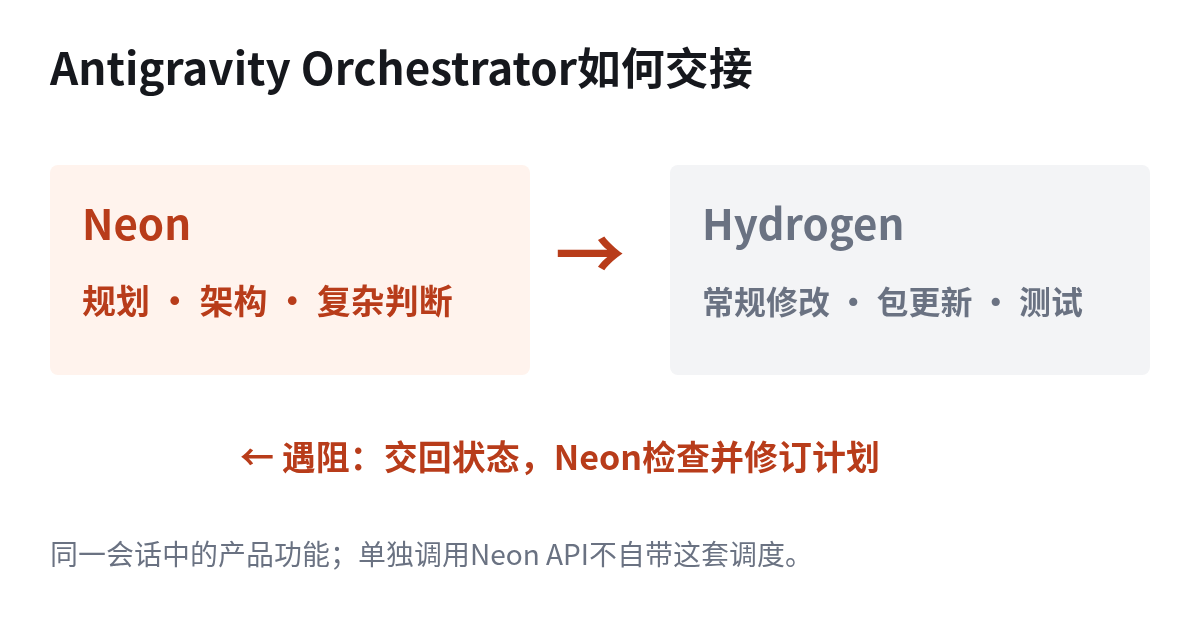
这套自动交接属于Antigravity,不能推及所有Gemini产品,更不意味着单独调用Neon API就自带调度器。讨论编程成绩时,也要带上harness,即围绕模型提供工具、管理上下文、执行与检查结果的运行框架。AA公布的Neon xhigh编程智能体指数约59分,使用的是Antigravity CLI;更换框架后,不能直接照搬这个分数。
官方还展示了Neon通过Antigravity驱动Blender制作三维实验台,以及用大量表格公式重建图像的例子。它们能说明模型如何连续使用工具完成交付,属于官方演示,不是本文独立实测。
长上下文有亮点,代码与网页成绩仍有短板
Neon的提升不是所有榜单同时领先。发布时Arena的智能体榜中,Neon high以1336分排第二,Carbon high为1303分、第四;文本榜却是Neon high以1518分排第三,仍在Carbon的1526分和Argon的1521分之后。WebDev网页开发榜上,Neon high以1764分排第七,比第六名Carbon低5分。它们测的任务和用户判断不同,不能互相替代。
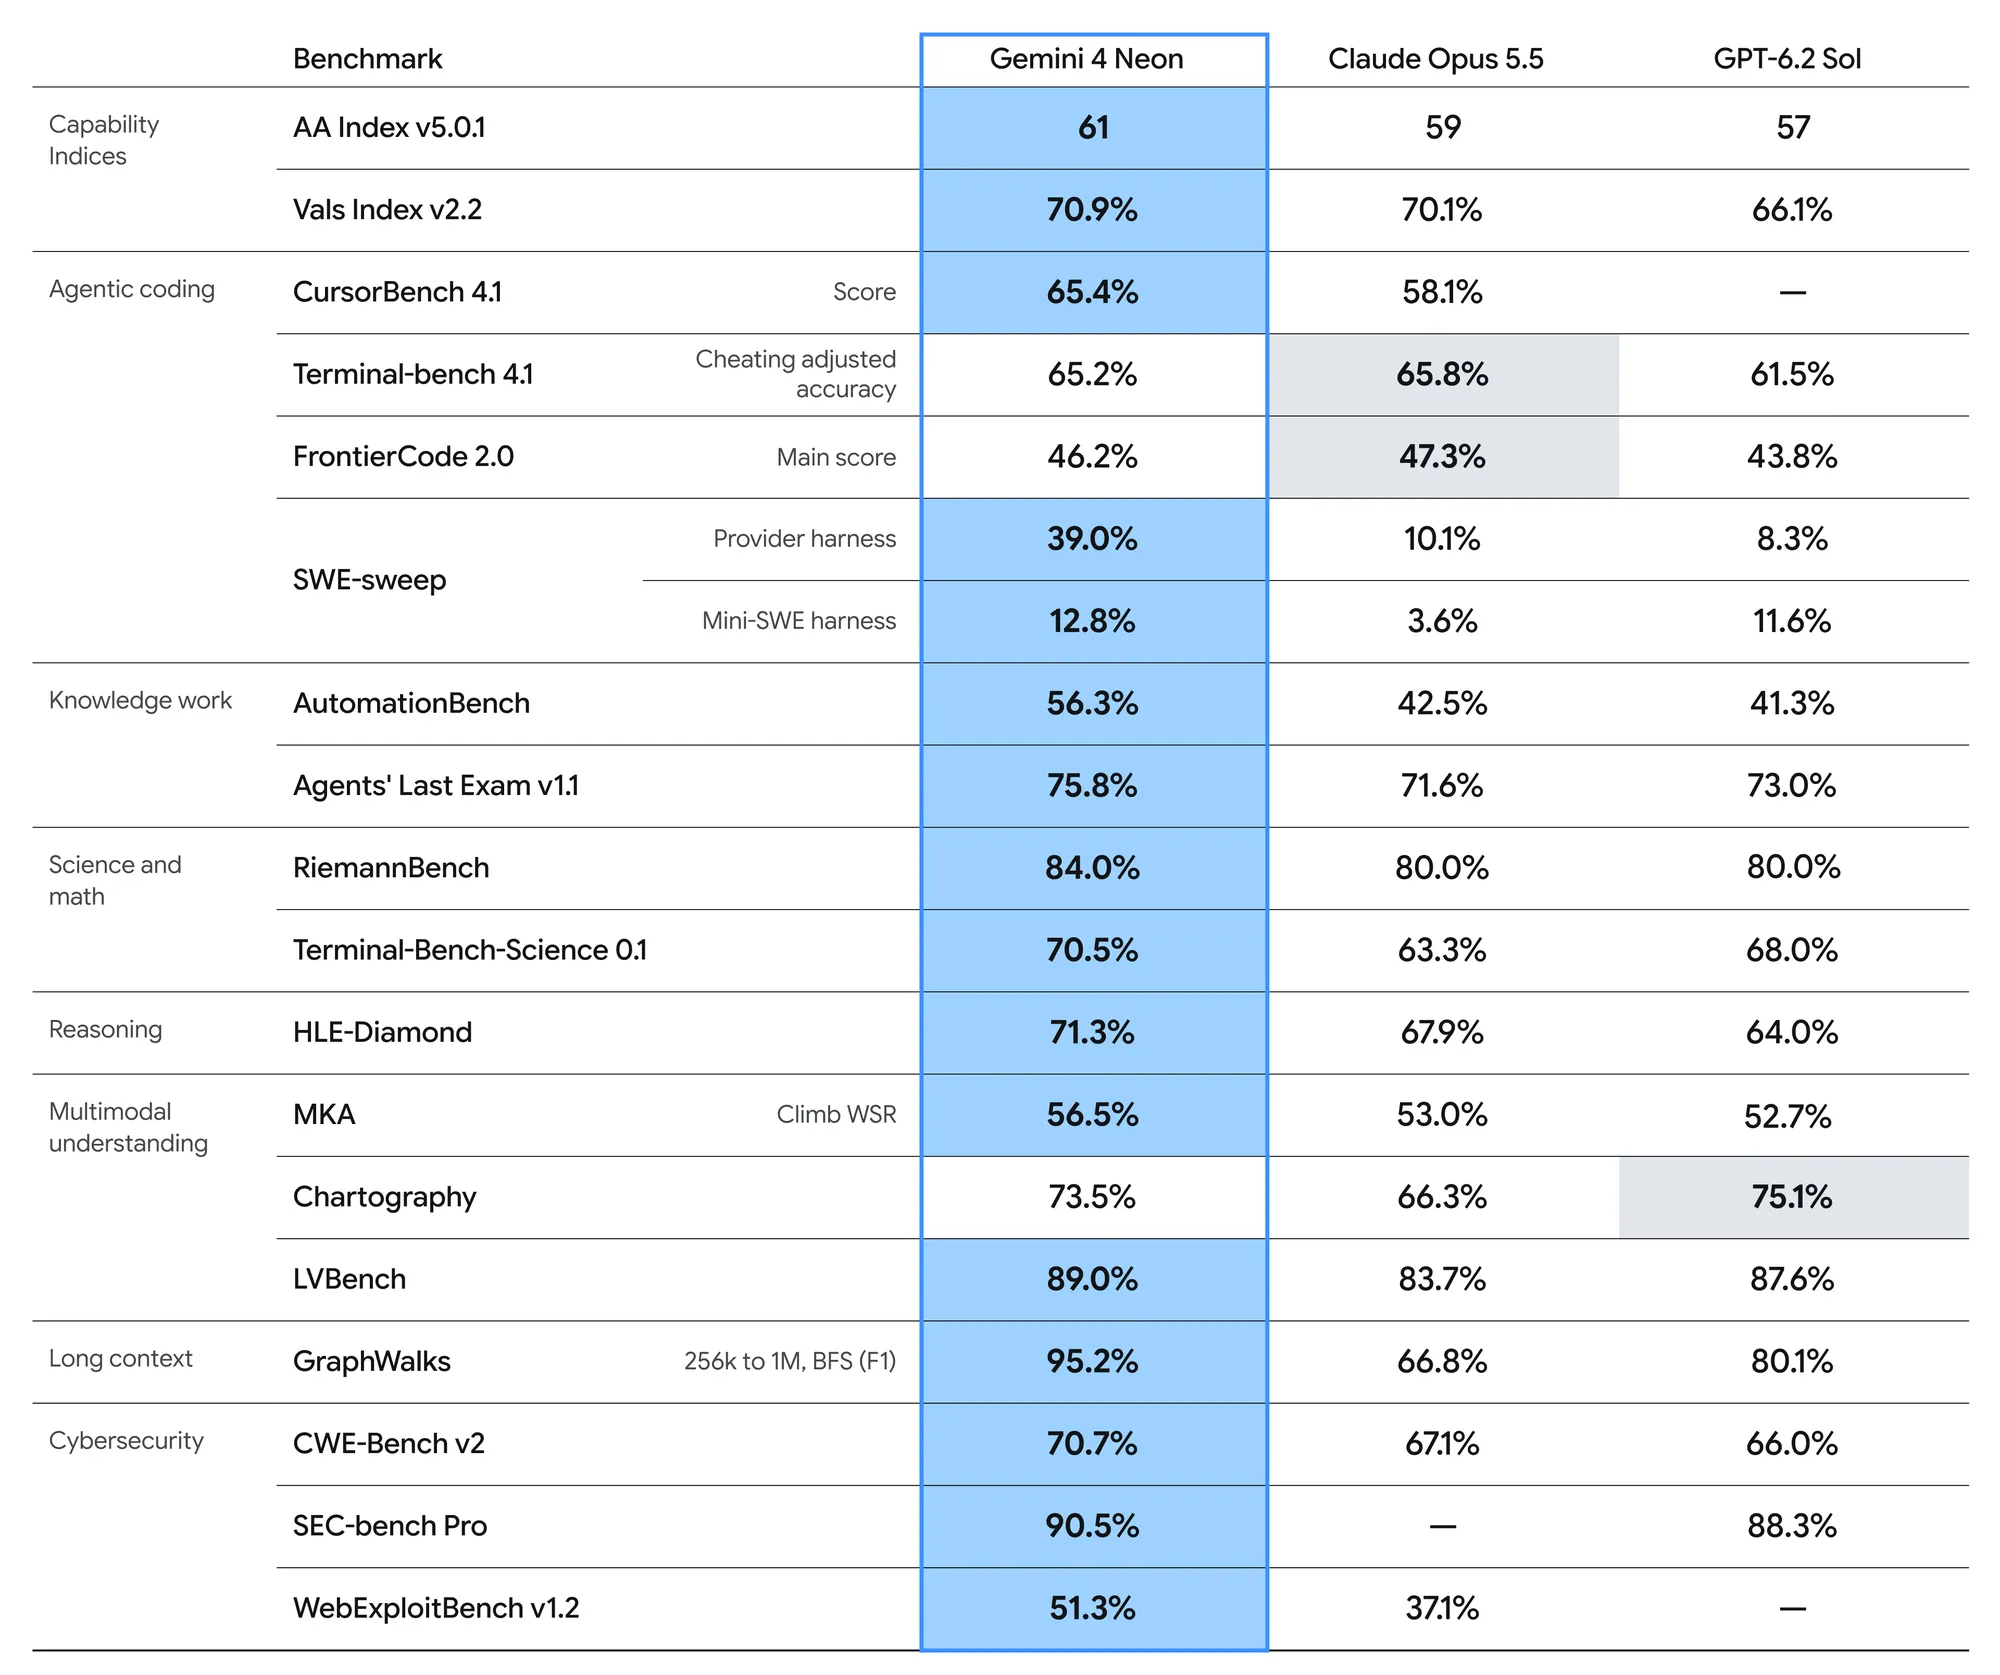
Google模型卡中的长上下文成绩较突出:GraphWalks在256K到1M Token范围,考察按广度优先搜索查找图中节点,Neon的F1分数为95.2%,对照的Opus 5.5为66.8%、GPT-6.2 Sol为80.1%。F1综合衡量找得全不全、找得准不准;这能说明该项长材料关系查找能力,不能保证任何百万Token文档都能无遗漏地理解。
同一张表也留下了反例。Terminal-Bench 4.1考察在终端完成任务,Neon为65.2%,略低于Opus 5.5的65.8%;FrontierCode 2.0中,两者分别为46.2%和47.3%。看得下更多材料、某项能力更强,与每种工程任务都做得更好,是不同结论。
Vals的Code Migration代码迁移测试更直接:Neon平均每项任务160轮,Carbon为234轮,Hydrogen为574轮,但Neon得分低于后两者。少走几轮,需要和最终完成质量一起看。 如果把依赖改了、测试却没有过,较短的执行过程还不能算一次成功的节省。
百万上下文、缓存与搜索,还有各自的账
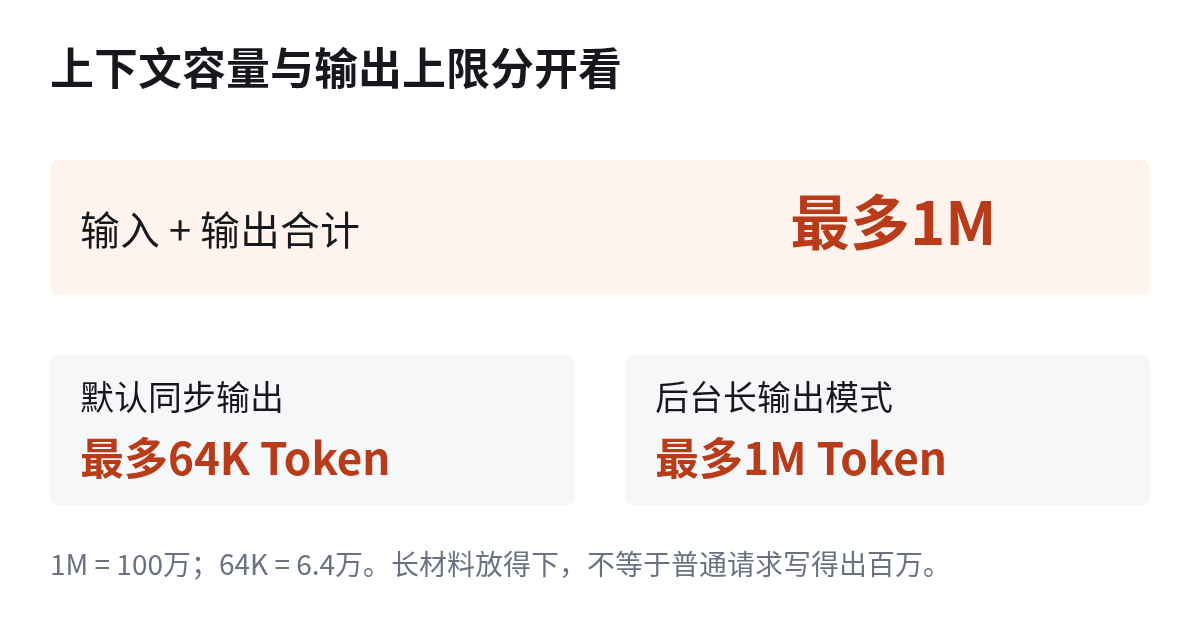
Neon接受文字、图片、音频和视频输入,提供输入与输出合计最多1M Token的上下文窗口。它能容纳长材料,不等于普通请求能一次输出百万Token:模型卡明确,同步请求默认最多输出64K Token,后台长输出模式才可到1M。模型知识截止于2026年3月,涉及此后的价格和新闻,需要结合当前资料。
Developer API当前使用统一的1M上下文价表,没有另列长上下文第二档;不过,模型处理的Token都计费,包括思考,以及使用grounding时内部工具的系统指令和函数定义。Grounding指借助搜索等外部信息核实、补充回答,不能只数最终显示给用户的文字。
搜索工具还有独立费用。Google Search和Maps各列每月5000次免费额度,分别与所有Gemini 3及更新模型共享,超出后每1000次14美元;Search另有每项目每天默认1500次的上限,按太平洋时间午夜重置,冬令时对应北京时间16:00。一次提问可能触发多次搜索查询,并逐次收费,所以“免费额度”不等于无限查资料。
拿正在做的项目试,验收结果后再谈换模型
安全评测也有使用条件。Google报告Neon在Gray Swan间接提示注入测试中达到0%攻击成功率,前提是开启实时防护并使用最高思考档;这只覆盖该组测试,不能推成不会被网页或文件中的恶意指令影响。
完整Safety & Security Report仍待公布。模型卡说明,这次做了重大能力变化评估,变化未超过其阈值,因而没有重跑完整的关键能力评估,相关风险判定沿用Argon;其中网络安全和生物领域的部分关键能力阈值仍属“无法排除”。面向防御工作的Neon for cyber又是独立入口,将在随后几天向Fairwind计划的合格成员开放,普通Pro或Ultra订阅不等于获得这项资格。
对已有Gemini或Antigravity订阅的人,最有用的试法是选一个正在推进、可以验收的项目,从默认High开始,记录完成时间、人工返工和结果质量。API用户再记下实际档位、输入输出、缓存和工具账单;需要更深推理时,再拿同样任务比较xhigh。Neon值得试的地方,是复杂工作能否更快交付。只有交付达标,单价与用量合起来的那笔账,才是有意义的任务成本。