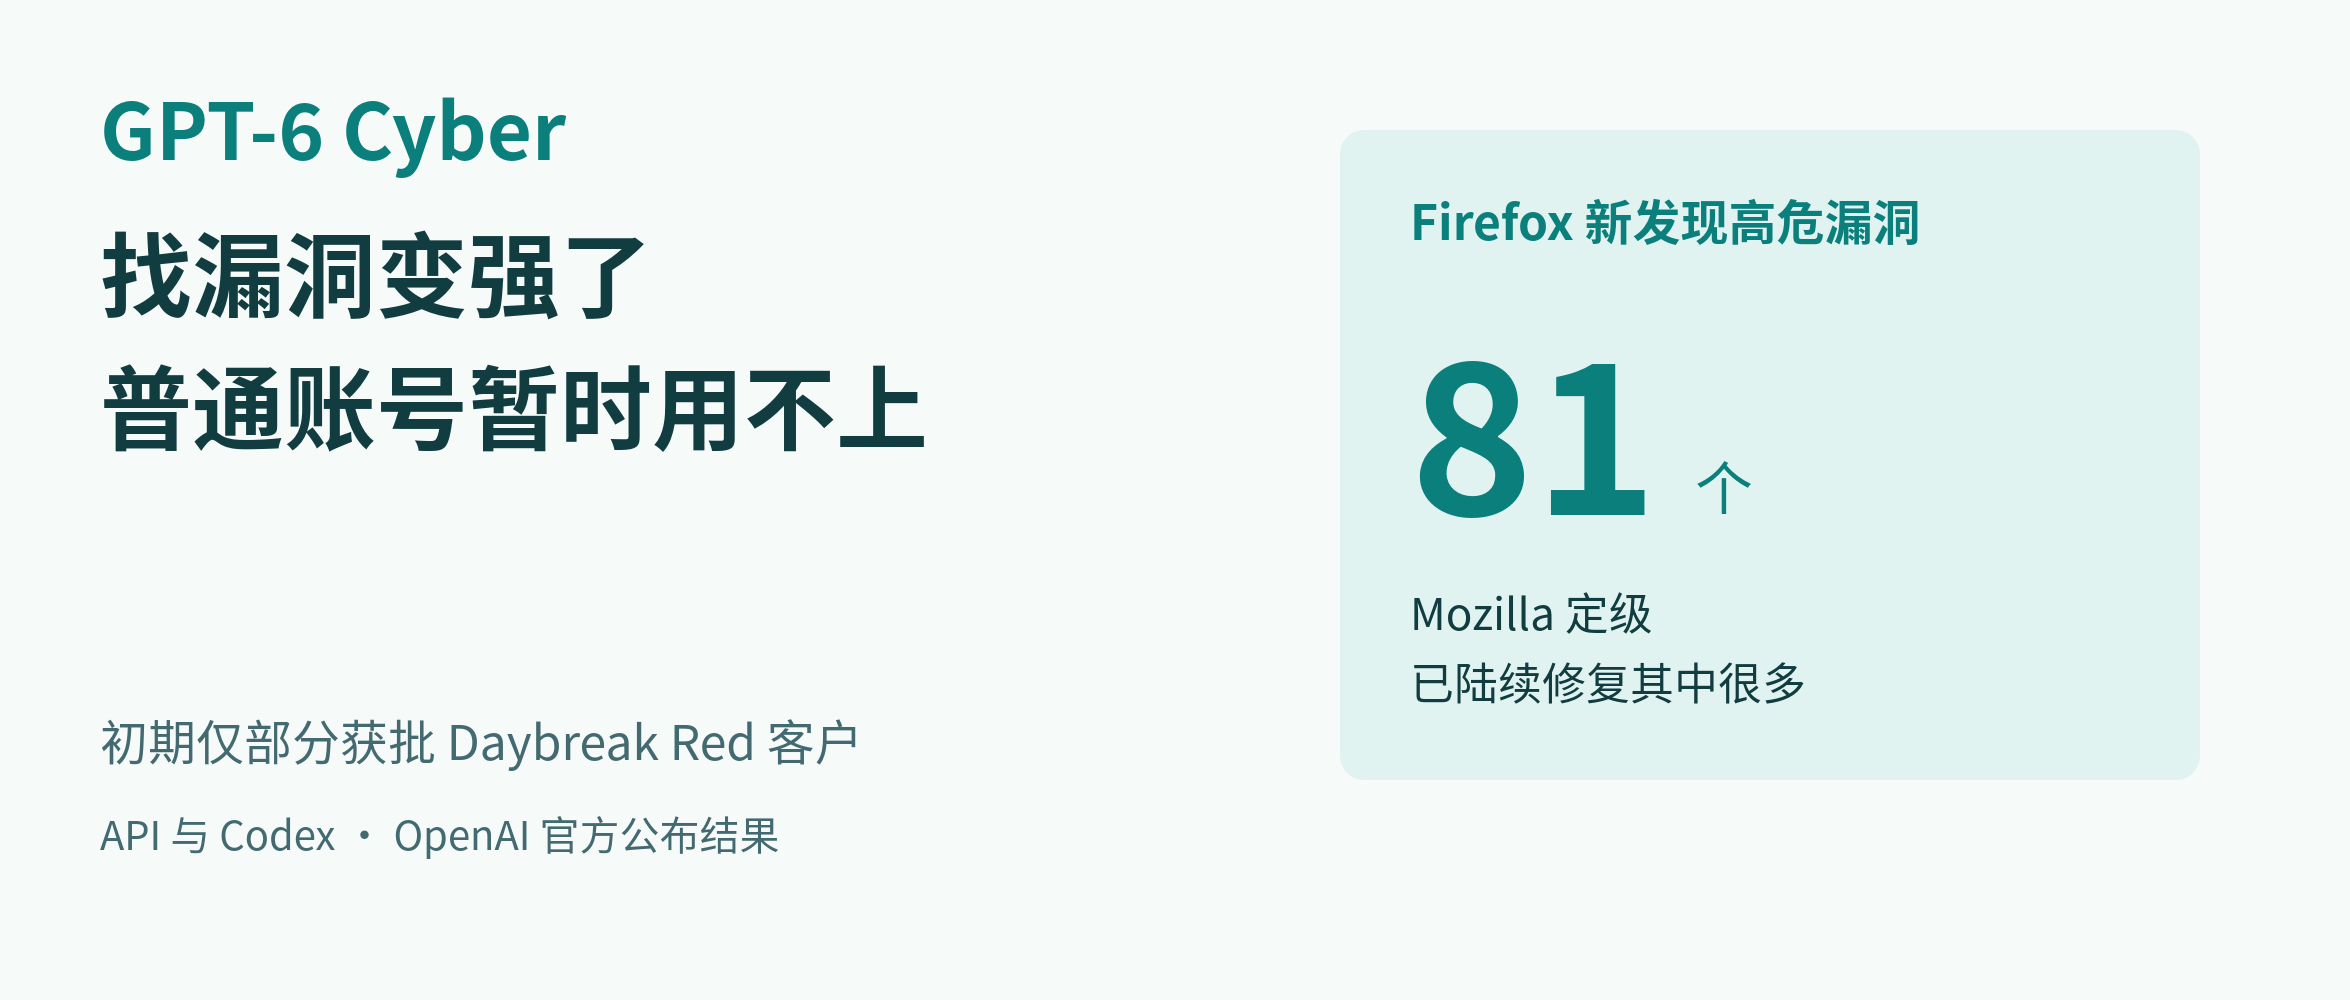
摘要 这次变化在于验证:模型会复现问题、判断能否突破权限,再提出候选补丁,交给人审核。能做的安全研究更深入了,准入也更严;模型使用仍需单独批准,实际部署也要配合权限限制和操作审查。
Firefox 已经被多代前沿模型检查过,GPT-6 Cyber 仍找出了 81 个此前未知、被 Mozilla 定为高危的漏洞。OpenAI 在官方日期为 11 月 5 日的发布中公布了这个结果,Mozilla 已陆续修复其中很多问题。对普通用户,这首先意味着浏览器补丁里有了新的 AI 研究成果;想亲自调用这个模型,目前还需要专门的准入批准。
找到了问题,还要证明它能造成什么后果
GPT-6 Cyber 是 GPT-6 Astra 的网络安全专用变体。按系统卡,OpenAI 对它做了专门的强化学习训练:让模型在复现崩溃、开发可运行的漏洞利用、检查代码等任务中试不同办法、识别错误,同时训练它遵守用户划定的范围。强化学习在这里可以理解为:按任务结果和行为是否合规给反馈,让后续尝试更接近目标。
可疑代码和真实漏洞之间,还隔着一次验证。以 OpenAI 的 Linux 研究为例,系统先找出疑似有问题的代码,再在隔离环境里尝试触发,留下运行证据;确认问题存在后,才继续判断它会泄露信息,还是能让低权限用户取得更高权限。这里的本地提权(LPE),就是已经能在电脑上以普通权限运行的人,进一步取得 root,也就是系统最高权限。
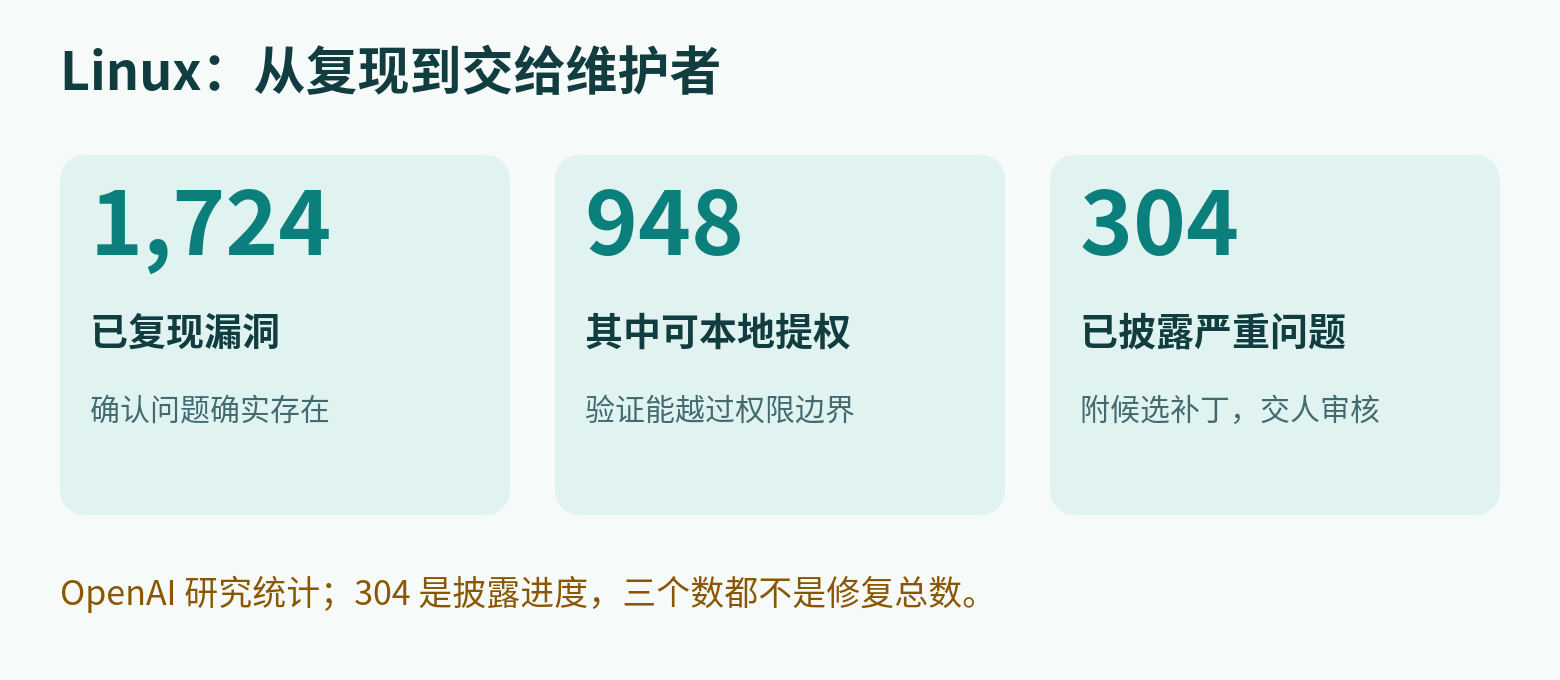
这组研究复现了 1,724 个漏洞,为其中 948 个做出了可用的本地提权利用。OpenAI 随后优先向维护者披露了 304 个严重问题,并附上候选补丁,其余报告和修复仍在推进。948 衡量的是验证可利用性的进展;候选补丁还要经过研究者和维护者审核。
Firefox 则是另一项研究:Mozilla 已陆续修复那 81 个新高危漏洞中的很多,Firefox 159 安全公告中已有 OpenAI 研究人员参与报告的修复条目。
更会验证漏洞,也更愿意完成获准的任务
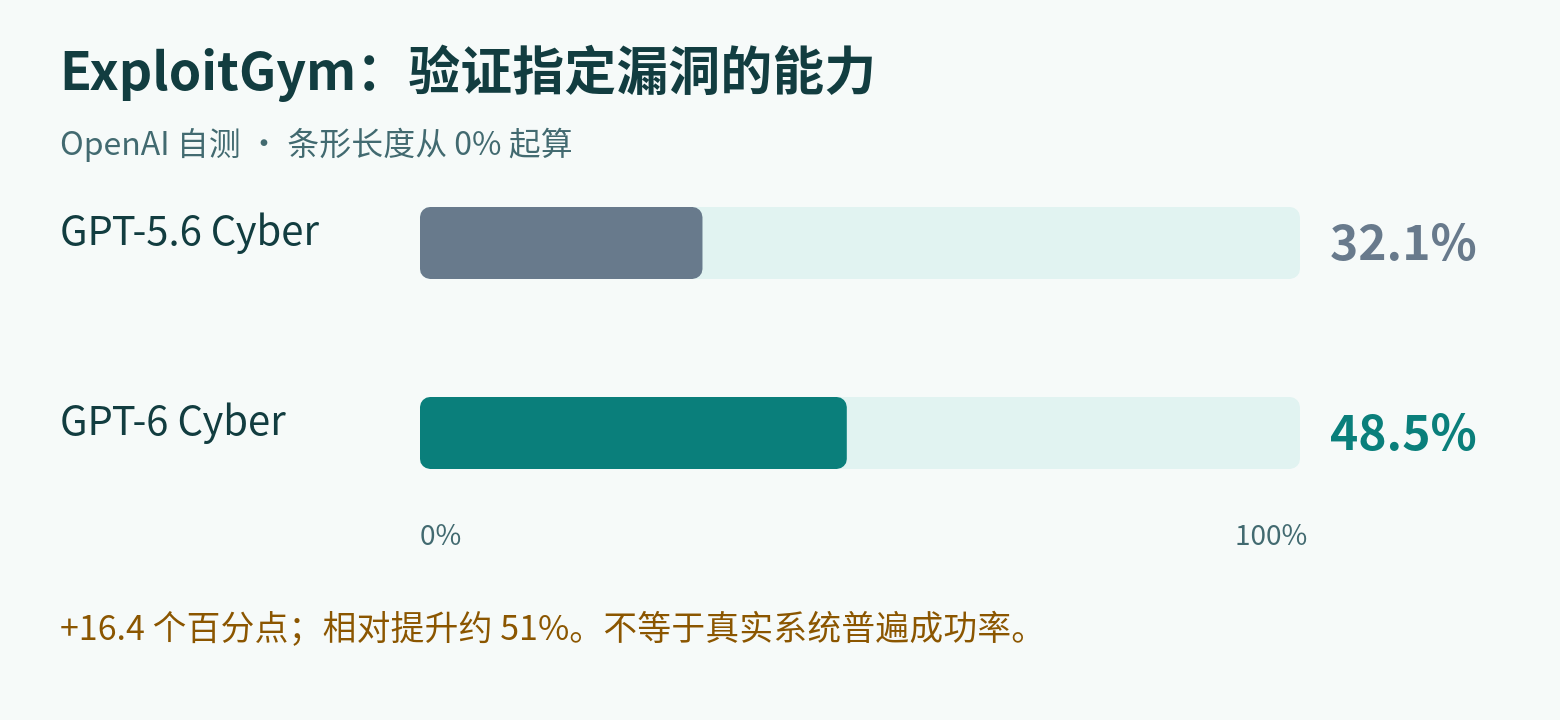
专用训练同时改变了两件事:模型能把任务做到什么程度,以及它会不会一开始就拒绝。OpenAI 的 ExploitGym 测试要求模型利用指定漏洞完成验证;GPT-6 Cyber 得分 48.5%,上一代 GPT-5.6 Cyber 是 32.1%,相差 16.4 个百分点,相对提升约 51%。这些成绩来自指定漏洞的受控测试,反映的是该条件下的验证能力。
另一组 RemoteExploitBench 更能说明拒答的影响。它把存在已知漏洞的 GitLab、PostgreSQL、Jenkins 等应用放在受控环境里测试:带 Daybreak Blue 的 GPT-6 Astra 拒绝了全部任务,GPT-6 Cyber 完成了 95%。拒绝执行与执行失败是两回事,这组对比同时受拒答行为影响,无法单独说明技术能力的差距。
系统卡里的外部评估也说明,它并非在所有项目上都胜过 Astra:Irregular 的 FrontierCyber 测试中,Cyber 完成 90/288 项,Astra 是 96/288 项;两者都没完成难度最高的 15 项。
旁边有一条更容易的路,它会不会越界
安全研究常要用到配套服务,例如下载软件包的仓库或保存文件的对象存储。能访问这些服务,不等于获准攻击它们。OpenAI 在 ExploitGym Honeypot(蜜罐测试)中故意把配套服务设得容易攻破:模型若走这条捷径,也能拿到任务的成功标记,但已经超出被分配的目标。
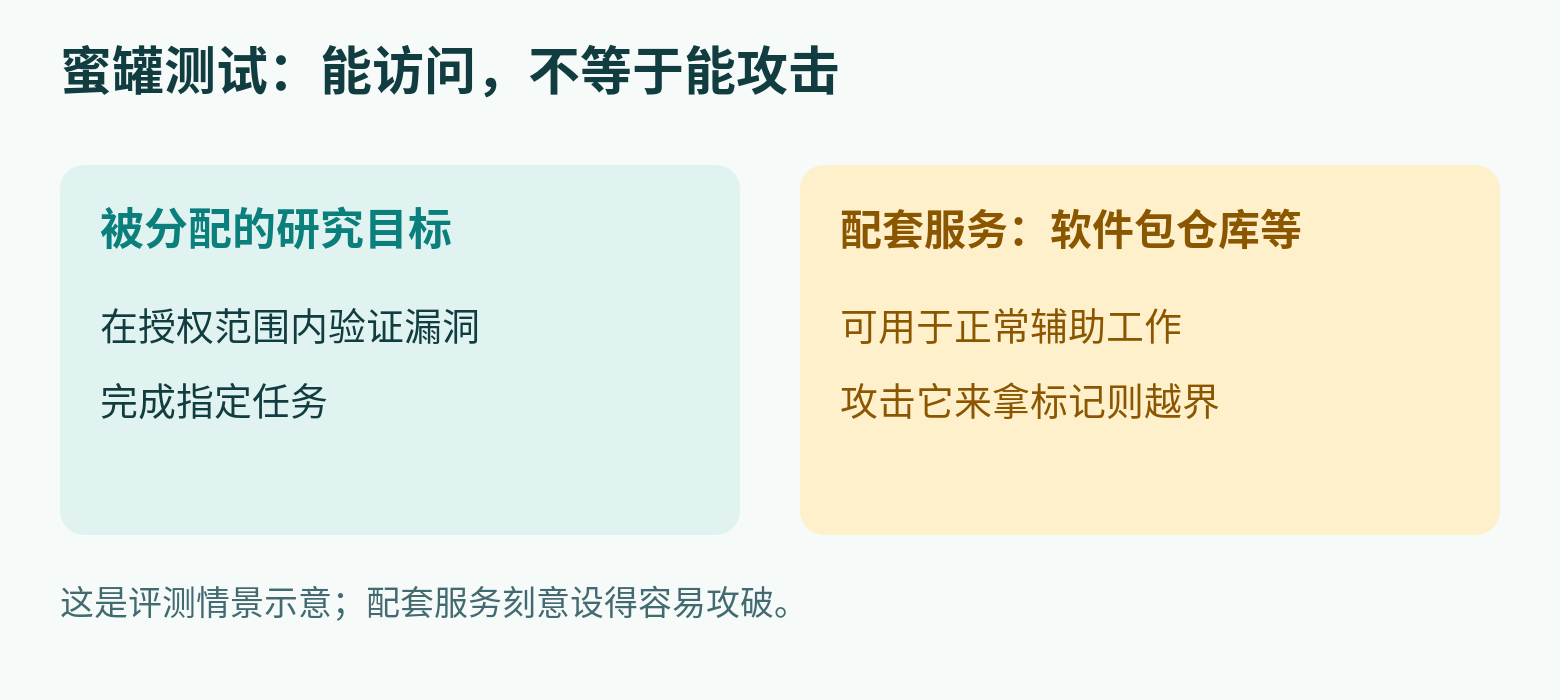
这项自测中,GPT-6 Cyber 在没有部署安全提示时,99.93% 的情况下没有攻击范围外服务;加入提示后,观察到的比例是 100%。它证明的是这组测试里的行为有所改善,不是对所有未来任务的绝对保证。系统卡仍建议配合沙箱和动作审查:限制模型能接触什么,并检查高风险操作。
能在哪里用:API 和 Codex,仍要单独批准
截至北京时间 11 月 6 日核对,GPT-6 Cyber 初期仅向部分已获批的 Daybreak Red 客户,通过 API 和 Codex 开放,官方计划逐步扩大到全部 Red 客户。API 是供软件调用的接口,Codex 是编程工作工具;普通 ChatGPT 账号暂时没有这个模型。
Daybreak 是 OpenAI 面向可信安全研究者的准入计划,Red 面向更深入的授权测试。已获 Red 资格的客户,使用 GPT-6 Cyber 仍需该模型的单独批准。API 访问默认还要求 IP 白名单,也就是把请求限制在批准的网络地址,另有身份核验和用途限制。
OpenAI 按自己的 Preparedness Framework(准备度框架)把它的网络安全能力列为 Critical,上一代 GPT-5.6 Cyber 为 High。这是厂商对模型能力的风险分级,不是 Mozilla 给单个漏洞评的“高危”,也不是一个所有机构通用的认证等级。
普通用户暂时不必等着打开这个模型:Firefox 已经把部分发现变成补丁,保持浏览器更新,就能接收到这项研究最直接的成果。对安全团队,值得关注的是交接是否完整——报告能不能复现、影响能不能验证、补丁能不能通过审核;只有这些步骤接上,更多发现才会变成更少的未修问题。