摘要 月之暗面北京时间 10 月 24 日凌晨发布 Kimi K3.1 Pro。它没换底座,是在 K3 上加大强化学习后训练的版本,权重承诺 11 月 4 日前放出。独立评测机构 Artificial Analysis 给它 55 分,在 215 个模型里排第四;涨幅集中在 Agent 任务,Terminal-Bench 4.0 从 13% 升到 67%,知识推理只从 47% 升到 52%。官方 47 项成绩里它拿下 16 项第一,最难的推理题仍落后闭源旗舰二三十分。API 价格比 K3 降约三分之一。
Kimi K3.1 Pro 的底座还是 7 月发布的 K3,参数规模一点没变,变的是后训练:月之暗面把更多算力花在强化学习上,让模型在几百个领域里反复做任务、按结果拿奖励。这样练出来的提升很不均匀,哪类评测涨得多、哪类几乎没动,正好能看出这次的算力花在了哪里。下面先讲它改了什么,再看第三方和官方成绩各说明了什么,最后算价格、权重和发布前做的一项安全处理。
同一个 K3 底座,后训练加码
K3.1 Pro 是新的 K3.1 系列里的第一个模型。按官方发布帖,它是混合专家模型(MoE,模型里有很多组“专家”参数,每次只调用其中几组):总参数 2.8 万亿,每个 token(模型读写文字的计量单位,也是 API 计费的单位)只激活 1040 亿,和 K3 相同;上下文(模型一次能看到的全部文字)100 万 token,能读文字和图片。同时上线的 K3.1 Pro Highspeed 智能水平一样,输出速度约为标准版的 2 到 3 倍。
官方博客对它的定位只有一句:K3 的后训练版本,后训练算力大幅增加。后训练指预训练之后的阶段,模型已经学会了语言和知识,这一步教它按要求把事做完。月之暗面押的是强化学习(RL):让模型在模拟环境里自己完成任务,按结果打分,做对的路子被强化。为了在数百个下游领域同时做联合 RL,团队逐层改造了 RL 框架、长上下文推理、训练效率、沙箱(把程序关在隔离环境里运行的保护)和任务调度,还专门做了一个检查训练环境质量的共享平台,目标是“确保每一份新增的 RL 算力都能转化为稳定、高效的回报”。
环境质量要单独查,是因为 RL 的分数来自环境里的测试和评分规则,规则有漏洞,模型就会学会钻空子拿分,而不是学会做事。环境多到几百个,靠人逐个检查不现实,这块基础设施和算力一样要紧。
第三方 AA:55 分排第四,Agent 任务涨得最多
Artificial Analysis(下称 AA)是独立评测机构,它的智能指数由自己跑的 10 项评测加权得出,覆盖 Agent 知识工作、编程、终端操作、科学推理、长文档和知识准确度。K3.1 Pro 得 55 分,在 215 个模型里排第四,前面是 Claude Opus 5.5(约 58 分)、Claude Sonnet 5.5 和 Muse Wonder Full(都约 56 分);GPT-6 Astra、Claude Fable 5.1 约 53 分,排在它后面。
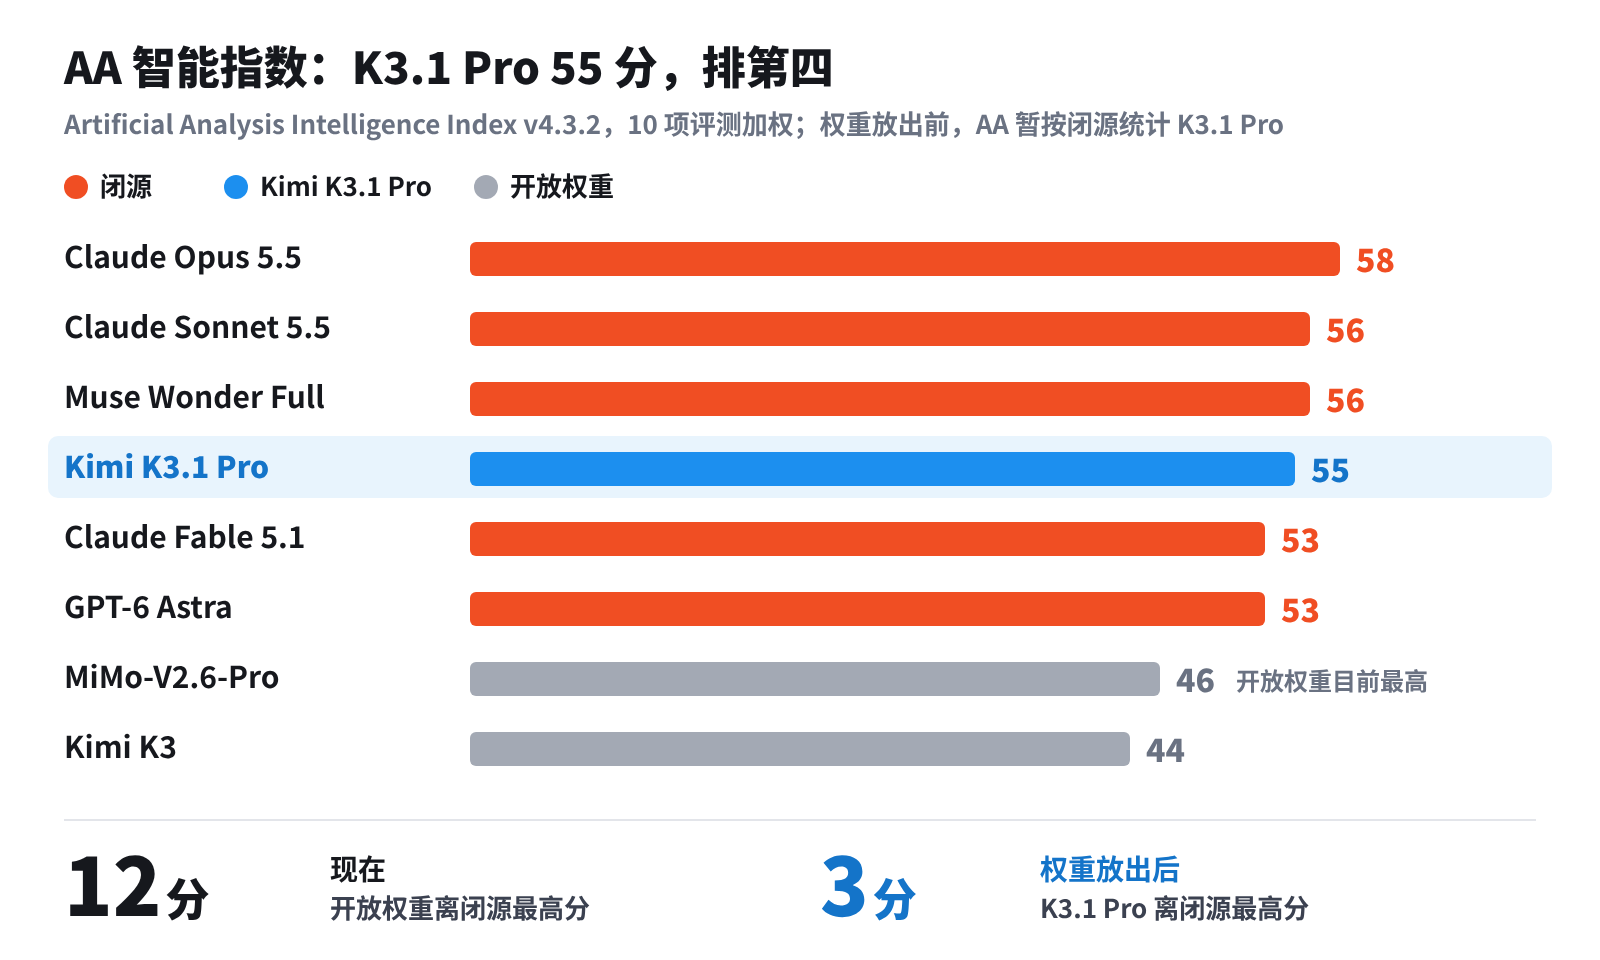
权重还没发,AA 目前按闭源模型统计它。AA 的判断是,权重放出后 K3.1 Pro 将是得分最高的开放权重模型(权重公开、谁都能下载部署的模型),开放权重和闭源模型的最高分差距会从 12 分缩到 3 分。按 AA 现在的数据,开放权重里最高的是 MiMo-V2.6-Pro,46 分。
拆开分项看,涨幅集中在 Agent 任务(模型自己调用工具、一步步把活干完):
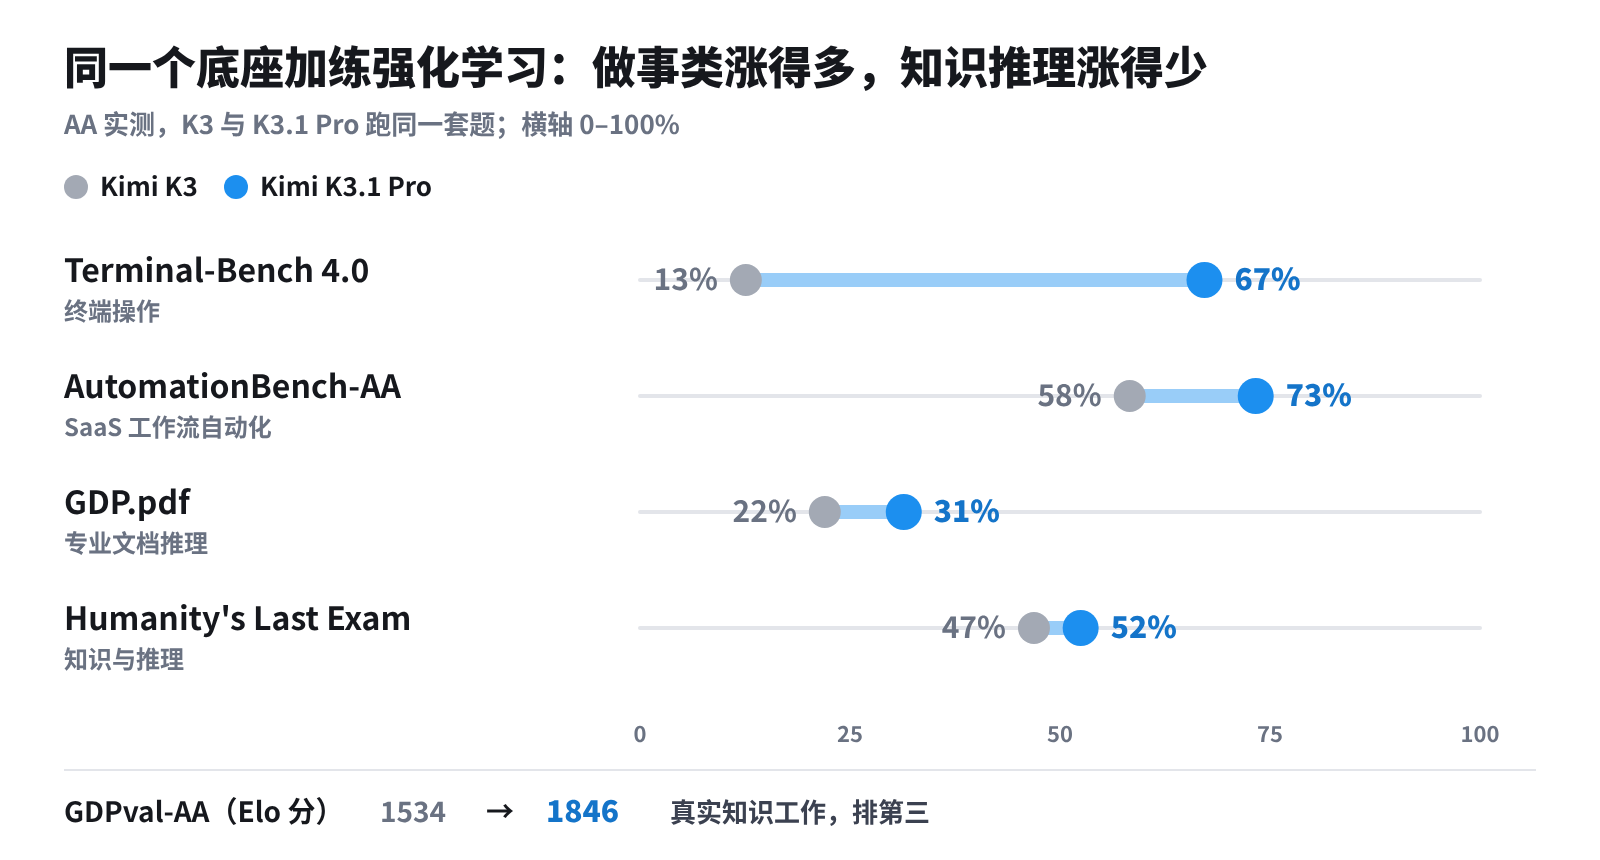
Terminal-Bench 4.0 让模型在真实终端里完成编程和运维任务,K3 只有 13%,K3.1 Pro 拿到 67%,是 AA 测过的模型里最高的,GPT-6 Astra 和 Opus 5.5 都约 60%。考真实知识工作的 GDPval-AA 用 Elo 分(两两比较算出的相对强弱分)计,从 1534 升到 1846,排第三;考 SaaS 工作流自动化的 AutomationBench-AA 从 58% 升到 73%。知识推理类涨得少,Humanity's Last Exam 只从 47% 升到 52%。RL 环境练的是做事,分数也涨在做事上。
AA 也记下了两个代价。跑完一整套智能指数,K3.1 Pro 输出了 1.5 亿个 token,同档模型的中位数是 8700 万,话偏多;输出速度每秒约 73 个 token,低于同档平均。按 AA 的算法,每道题平均花 2.11 美元。
官方成绩表:47 项拿下 16 项第一,短板也在表里
月之暗面自己公布了一张 47 项的成绩表,对手是 Claude Fable 5.1、GPT-6 Astra、Claude Opus 5.5、DeepSeek-V4.1-Flash-1017 和 GLM-5.3。K3.1 Pro 有 16 项是表中最高,其中 3 项是月之暗面的内部评测。这些都是厂商自报:K3.1 Pro 的编程项目多用 Claude Code 这类 harness(套在模型外面、负责调用工具和管理上下文的执行框架)测,对手的分数不少取自各家报告或排行榜。
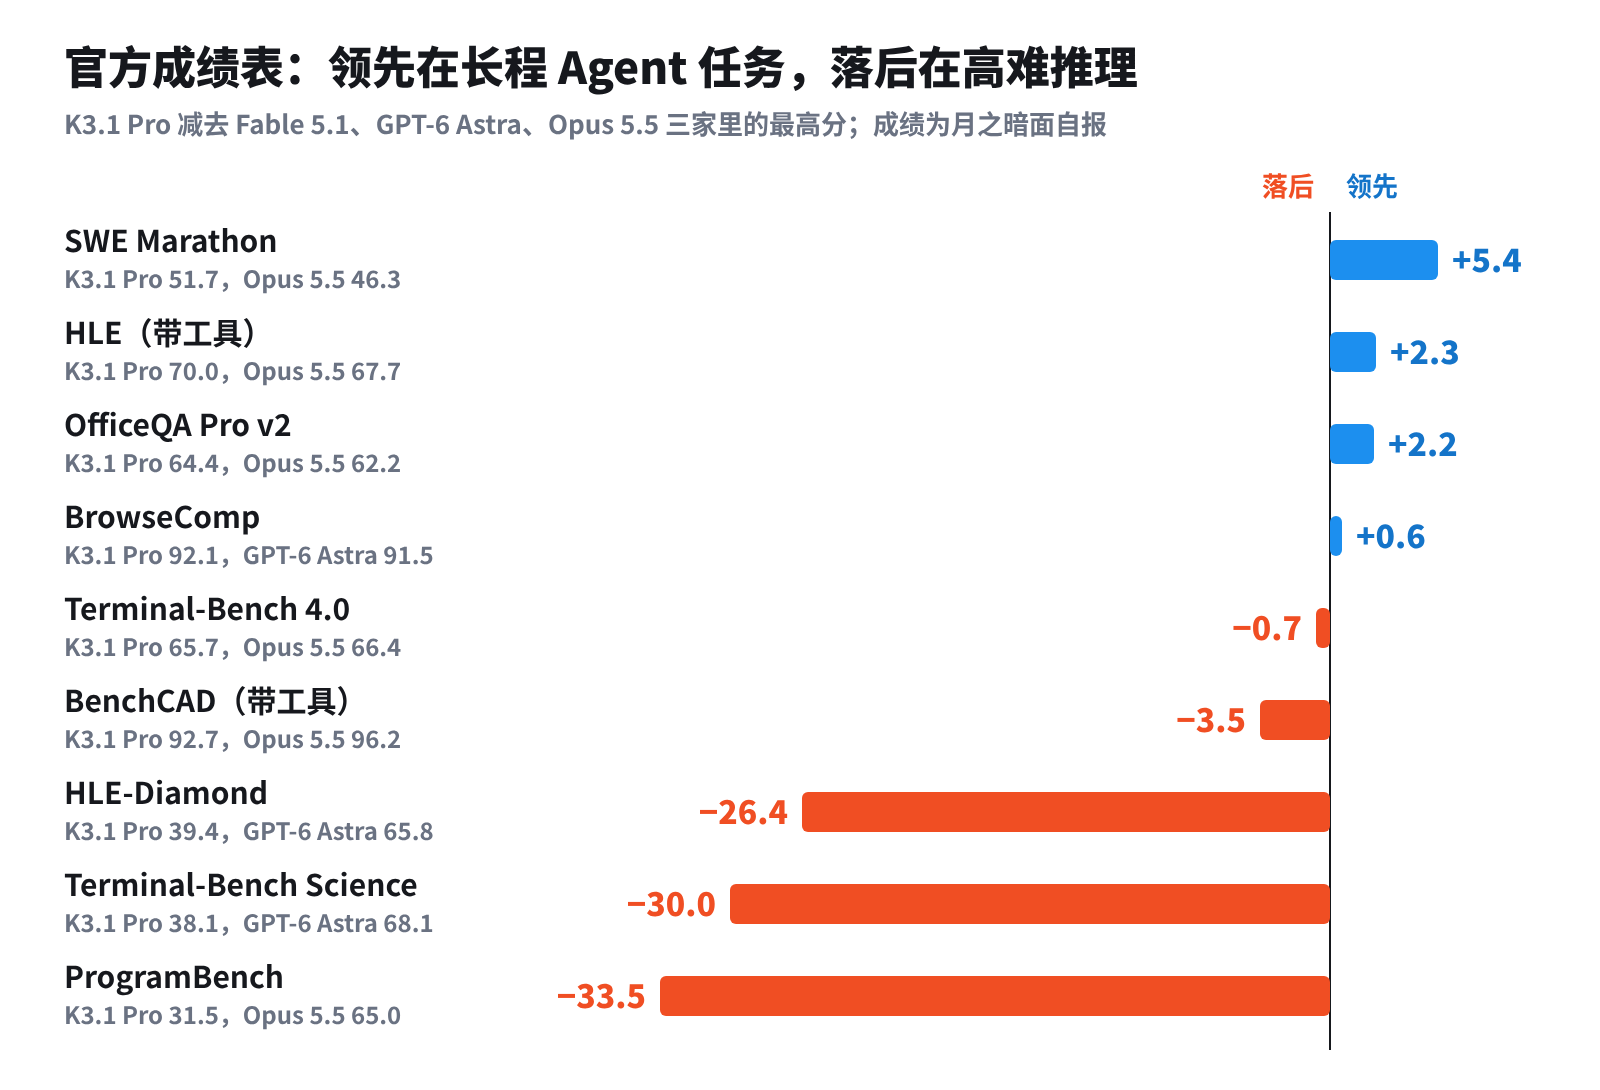
领先的项目集中在长程 Agent 任务。考长时间软件工程的 SWE Marathon,K3.1 Pro 51.7 分,比第二的 Opus 5.5 高 5 分多;带工具的 HLE 70.0、考上网查难找信息的 BrowseComp 92.1,都是表中最高。
最受关注的 Terminal-Bench 4.0,官方测得 65.7%,高于 GPT-6 Astra 的 58.2%,比 Opus 5.5 的 66.4% 低 0.7 个百分点。官方还按每道题花的钱画了一张图:
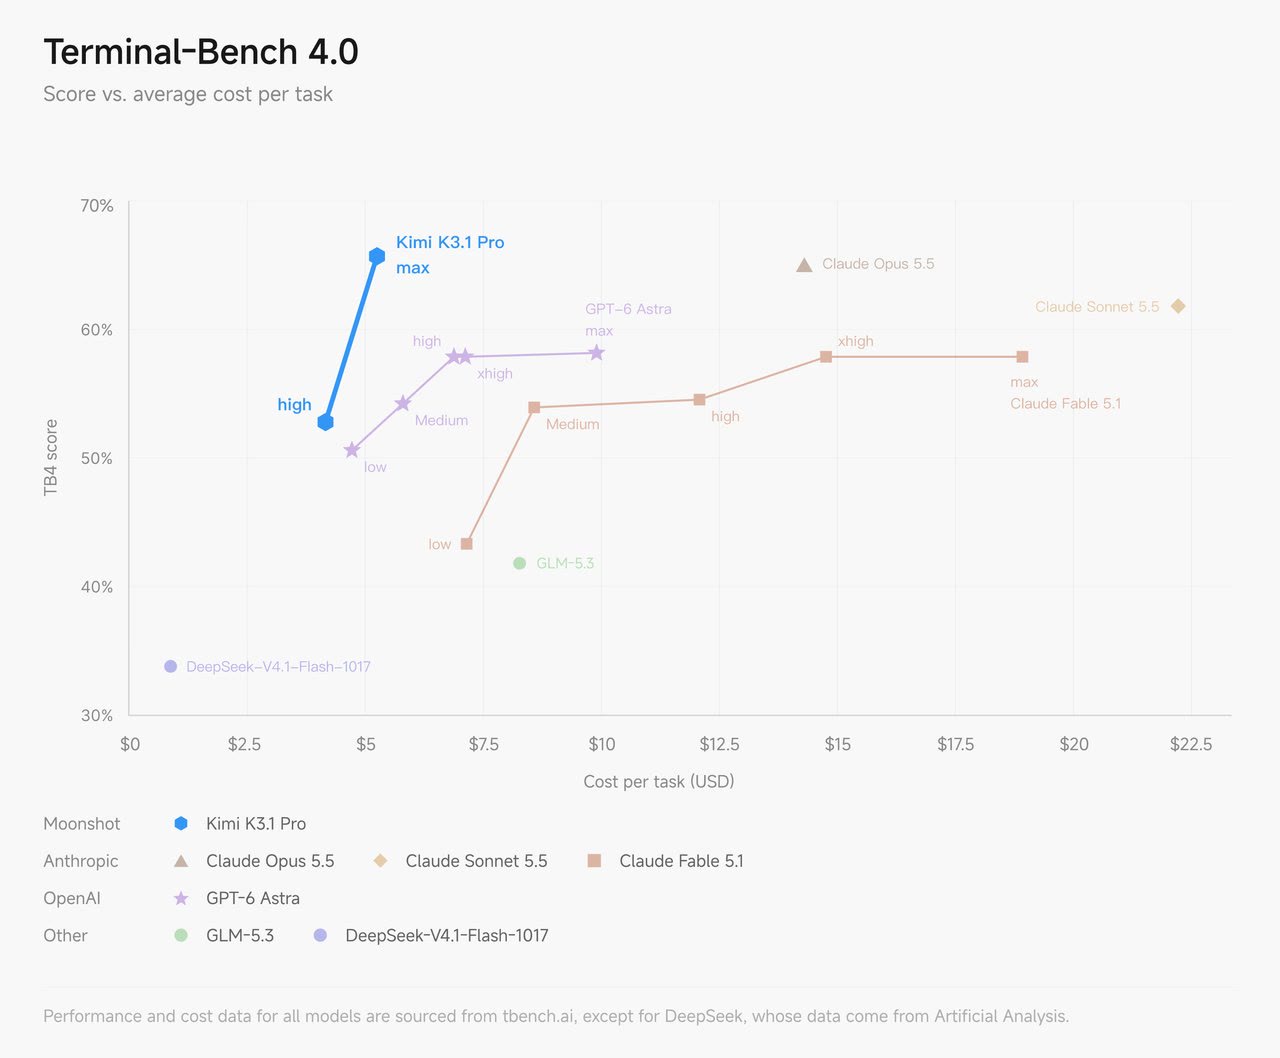
图里 K3.1 Pro 的 high 和 max 两档推理强度(答题前想多久)都在最左上:按图估读,max 档每题约 5 美元拿到约 66%,Opus 5.5 要花约 14 美元拿到相近的分数。月之暗面据此说它落在帕累托前沿,意思是同样的花费拿不到更高分,同样的分数也花不了更少的钱。
落后的项目也写在同一张表里。考高难推理的 HLE-Diamond(1000 道题),K3.1 Pro 39.4,GPT-6 Astra 65.8;ProgramBench 考程序复现,单题复现度到 95% 才算通过,它 31.5,Opus 5.5 65.0;Terminal-Bench Science 考终端里的科研流程,它 38.1,Astra 68.1。高难推理和精确复现,闭源旗舰仍领先二三十分。
3D 和游戏:一句需求,交付能跑的工程
这次升级的另一个重点是前端和 3D 创作。官方说法是,K3.1 Pro 能用 Unity、Unreal Engine、Godot 这些游戏引擎,结合网络搜索和 3D 生成做出完整的交互作品,产出的前端页面、Three.js 场景和 3D 资产在构图、排版和动效上都比前代好。
3D 能力有一个硬指标 BenchCAD:给模型几张不同角度的渲染图,让它写 CAD 代码(工程建模软件用的建模指令)把物体重建出来,按体素重合度(把模型切成小方块后比较重合了多少)打分。带工具时 K3.1 Pro 92.7%,Opus 5.5 96.2%,GPT-6 Astra 95.9%;不带工具时 72.8%,和 Opus 5.5 的 73.0% 几乎持平。
它擅长参数化建模(尺寸、数量写成参数,改一个数整体跟着变),从机械零件、建筑到可配置的产品和定制家具都能做。做法不靠 MCP 连接器(让模型调用外部软件的标准接口),而是直接写 Blender、FreeCAD 这些专业软件的脚本并运行,能单独改一个部件,调几何、材质和场景布局。
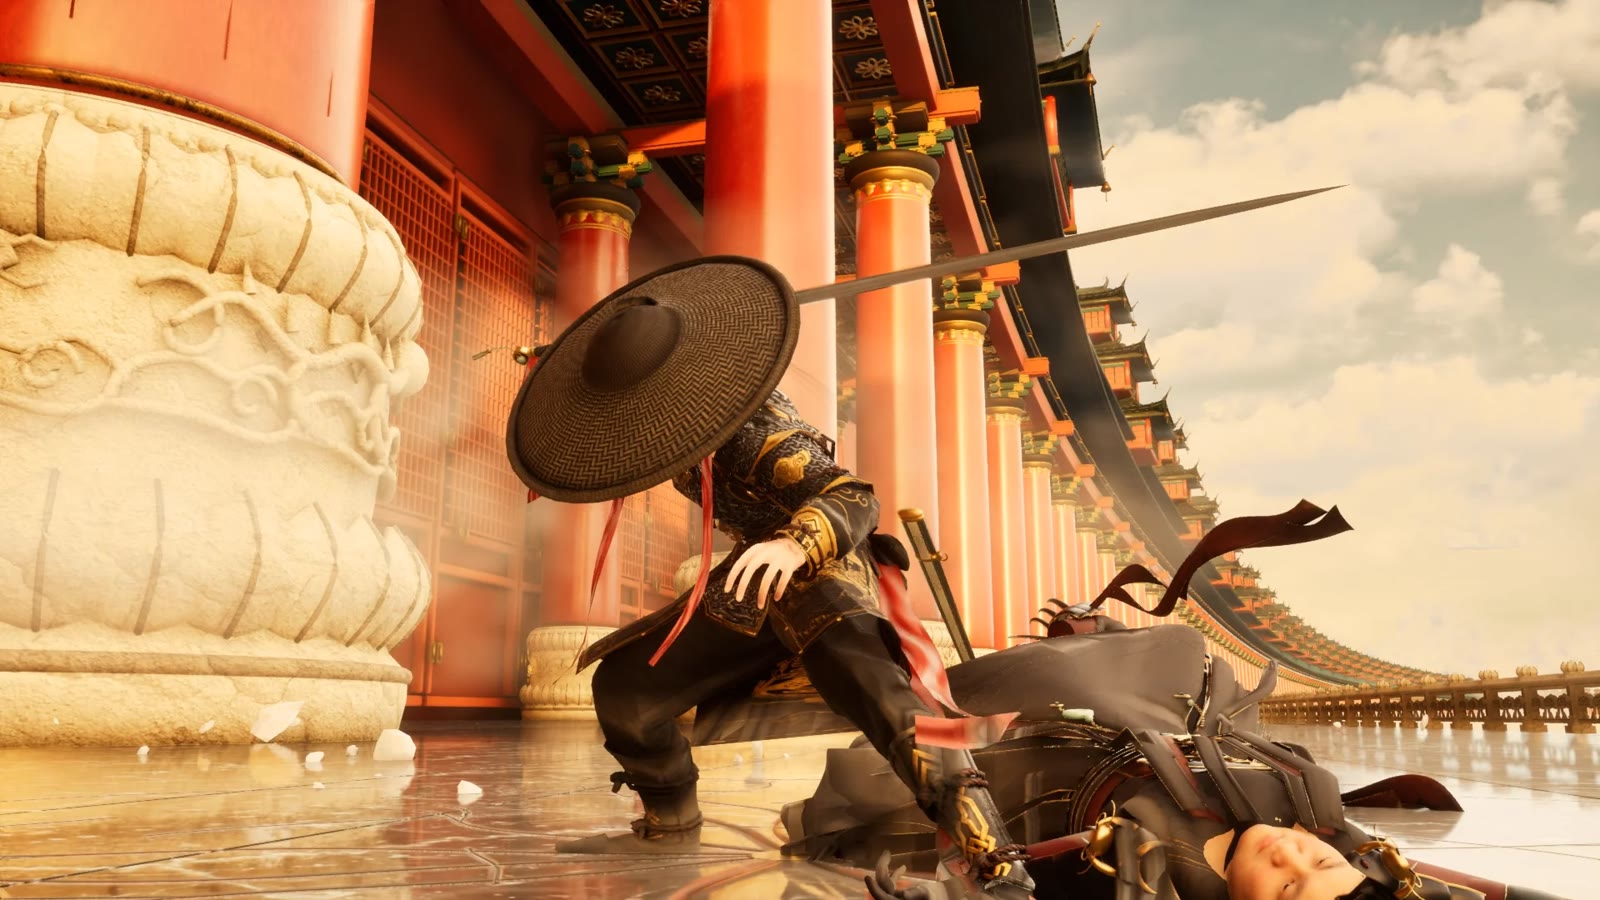
官方给了几个从头做到尾的案例:在虚幻引擎 5.8 里搭一座天宫,柱廊半径 1750 米、36 个柱间,场景有 3600 万个源三角形;用 Godot 4.7.2 做一款 3D 动作冒险游戏,有五个可探索区域、两阶段 Boss 战和昼夜循环;在 FreeCAD 里用 2100 个实体拼出一台能分步装配的涡扇发动机。配套上线的 3D Make 能在 kimi.com 和 App 里预览、编辑模型,导出去 3D 打印。
机器之心也上手试了几题:游戏手柄骑克苏鲁、克苏鲁骑大象、大象骑鹈鹕、鹈鹕骑自行车的五层 SVG 动画,交付了一个 41 KB 的文件,各层动作没乱;用 Godot 4 做雨夜小猫跳屋顶的 2.5D 小游戏,交付了带启动脚本的工程包,过了 20 多项渲染测试;在 Blender 里重建天坛祈年殿,交付了可编辑的工程、脚本和网页版。这些都是单次演示,说明它能把一个完整项目从头跑通,不说明每次都能。
最值得看的案例:调不好手臂,它去查仿真器
官方博客里有个内部测试,最能说明“长程任务”难在哪。月之暗面让 K3.1 Pro 基于开源人体解剖模型 human-atlas(296 个骨骼组件、402 个肌肉组件),搭一套带训练和评估流程的人类行走动力学仿真器,再训练出行走控制器(决定每块肌肉何时用多大力的程序)。
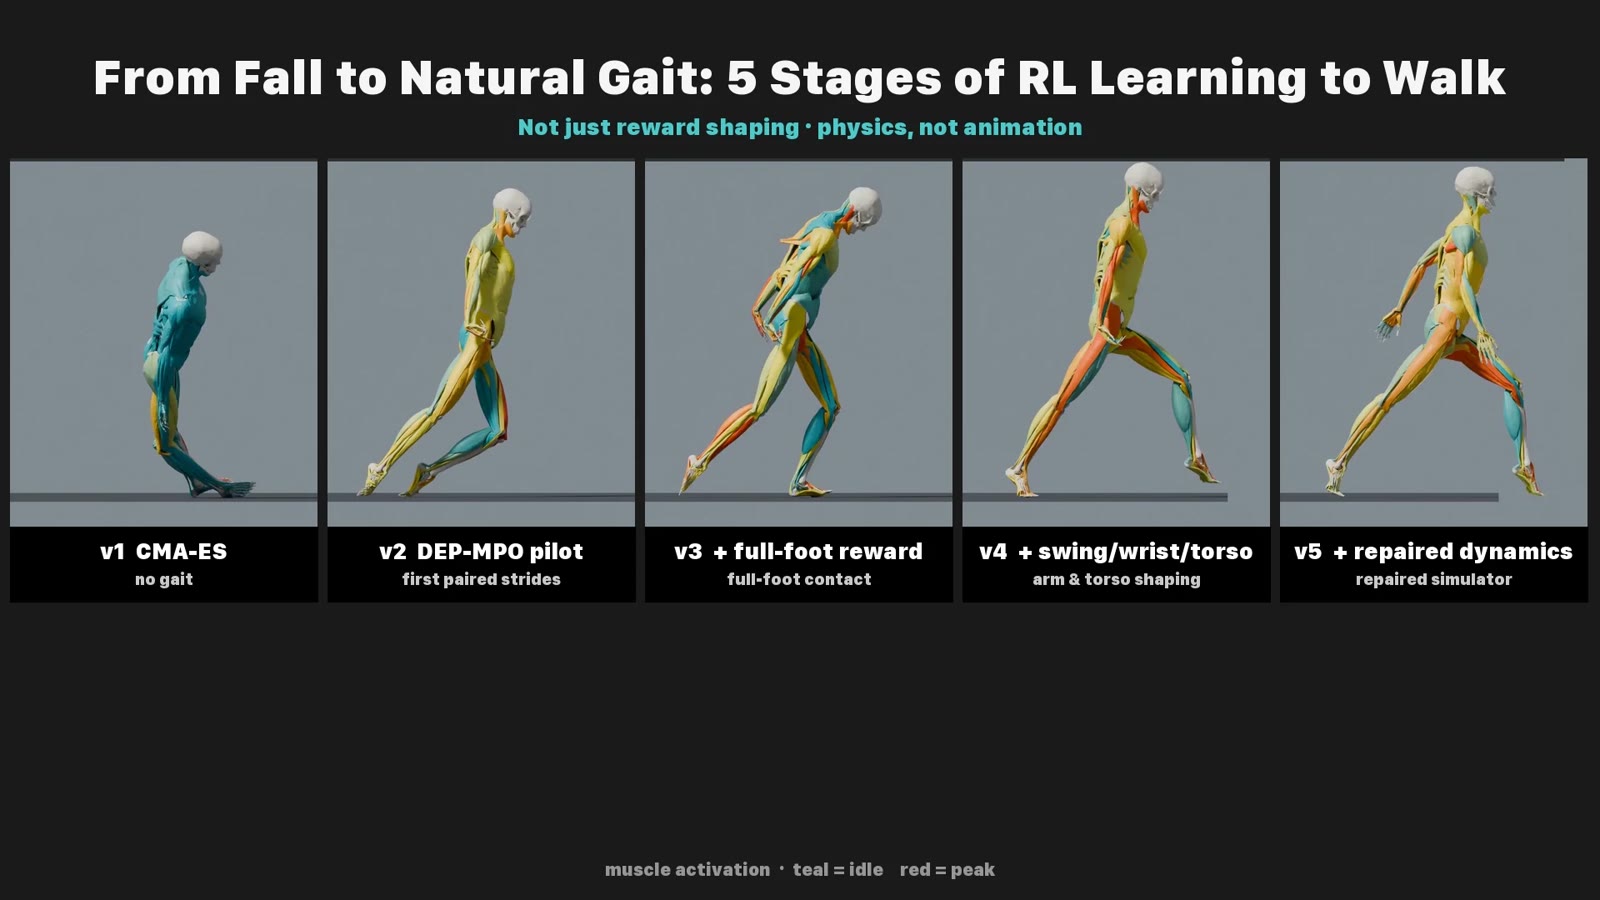
整个过程跨 167 项任务、420 次独立评审,K3.1 Pro 一轮轮分析实验结果、定位问题、改控制器。仿真出来的人起初几秒内就摔倒,最后学会交替迈步,连续走了 11.2 秒。中间有个转折:手臂动作怎么调奖励都不见好,它没有继续改奖励,而是对仿真器的动力学做开环探测(绕开控制器的反馈,直接给仿真器输入,看它怎么反应),查出肩部肌肉力臂(肌肉拉力绕关节转动的杠杆长度)计算里的 36 处错误,修好后再重新训练。
它怀疑的对象从奖励换成了仿真器本身。结果不对时先弄清是哪一层错了,而不是在同一层里反复试,这在长程任务里比写出第一版更难。
金融:数字要对得上,少编
金融是这次重点宣传的另一个行业,要求数字能对上原文、公式牵一发动全身、结论经得起复核。外部评测 OfficeQA Pro v2 考在真实财务文档里检索、跨文档核对和多步计算,PDF 全部以图片形式给出,K3.1 Pro 64.4 分,表中最高,Opus 5.5 62.2;覆盖从选股到盈利分析全流程的 Frontier Finance,它 58.6,比 K3 高,但低于 Fable 5.1 的 60.8。内部评测里,财务建模比 K3 高 7.2 分,可核验的研究报告高 11.6 分,模拟经营的得分约为 K3 的 4.2 倍。
金融最怕模型编数字,所以官方专门压了幻觉(说得有鼻子有眼、事实却是错的内容):
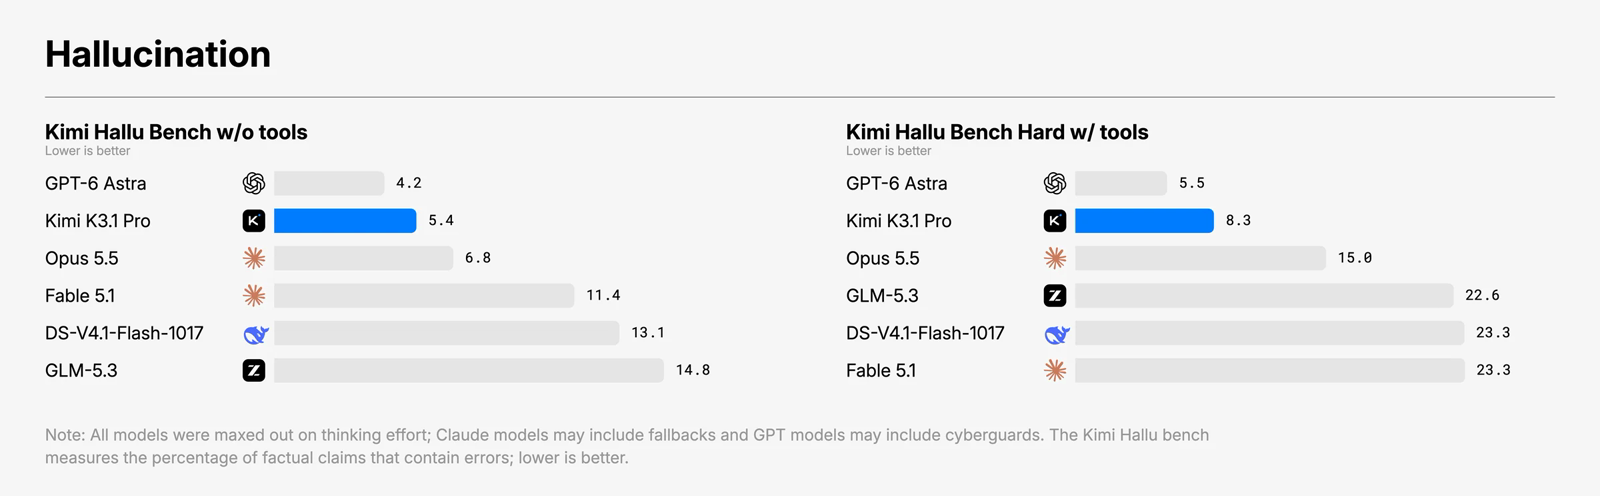
右边的 Kimi Hallu Bench Hard 是月之暗面专挑易错场景出的内部压力测试,允许用工具,按单条事实陈述算错误率:K3 是 23.4%,K3.1 Pro 降到 8.3%,Opus 5.5 是 15.0%,GPT-6 Astra 最低,5.5%。官方注明这是刻意刁难的测试,不代表日常使用的错误率。第三方数据方向一致:在 AA 的知识准确度评测 AA-Omniscience 里,K3.1 Pro 的幻觉率从 K3 的 53% 降到 44%。
价格、权重和发布前的一道安全闸
API 模型名是 kimi-k3.1-pro,每百万 token 输入 13 元(命中缓存 1.3 元)、输出 68 元;K3 是 20 元、2 元、100 元,三项都降了约三分之一。Highspeed 版输入、输出都是标准版的两倍,缓存命中价相同。美元价是输入 2 美元、输出 10 美元,和 Claude Sonnet 5.5、GPT-6.1 Sol 一样,是 Opus 5.5 的一半、GPT-6 Astra 的五分之一。
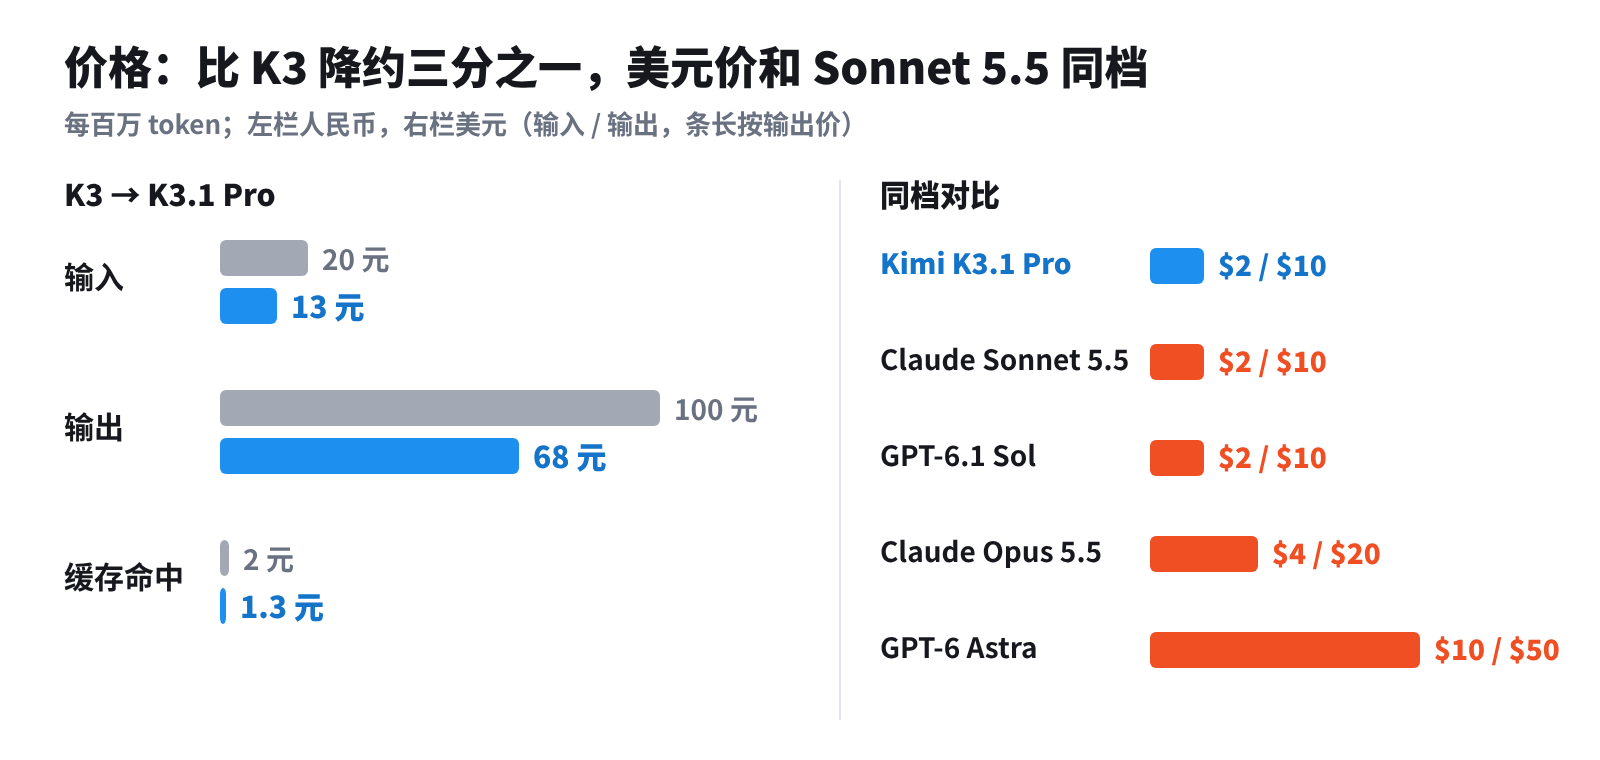
同价位里,K3.1 Pro 多出来的筹码是开放权重:官方承诺 11 月 4 日前放出完整权重,之后企业可以把它部署在自己的机房,数据不出域,还能按需微调。不过这要等权重真正发布才算数,在那之前它就是一个闭源 API。
开放权重之前,月之暗面还做了一件机器之心没提的事:删掉网络攻防训练数据。官方博客说,后训练规模越大,模型的漏洞研究能力涨得越快,追下去发现中期训练的通用语料和 RL 环境里本来就混着攻防内容。为了开放权重版本,团队从这两个阶段识别并移除了相关数据,保留通用编程任务。
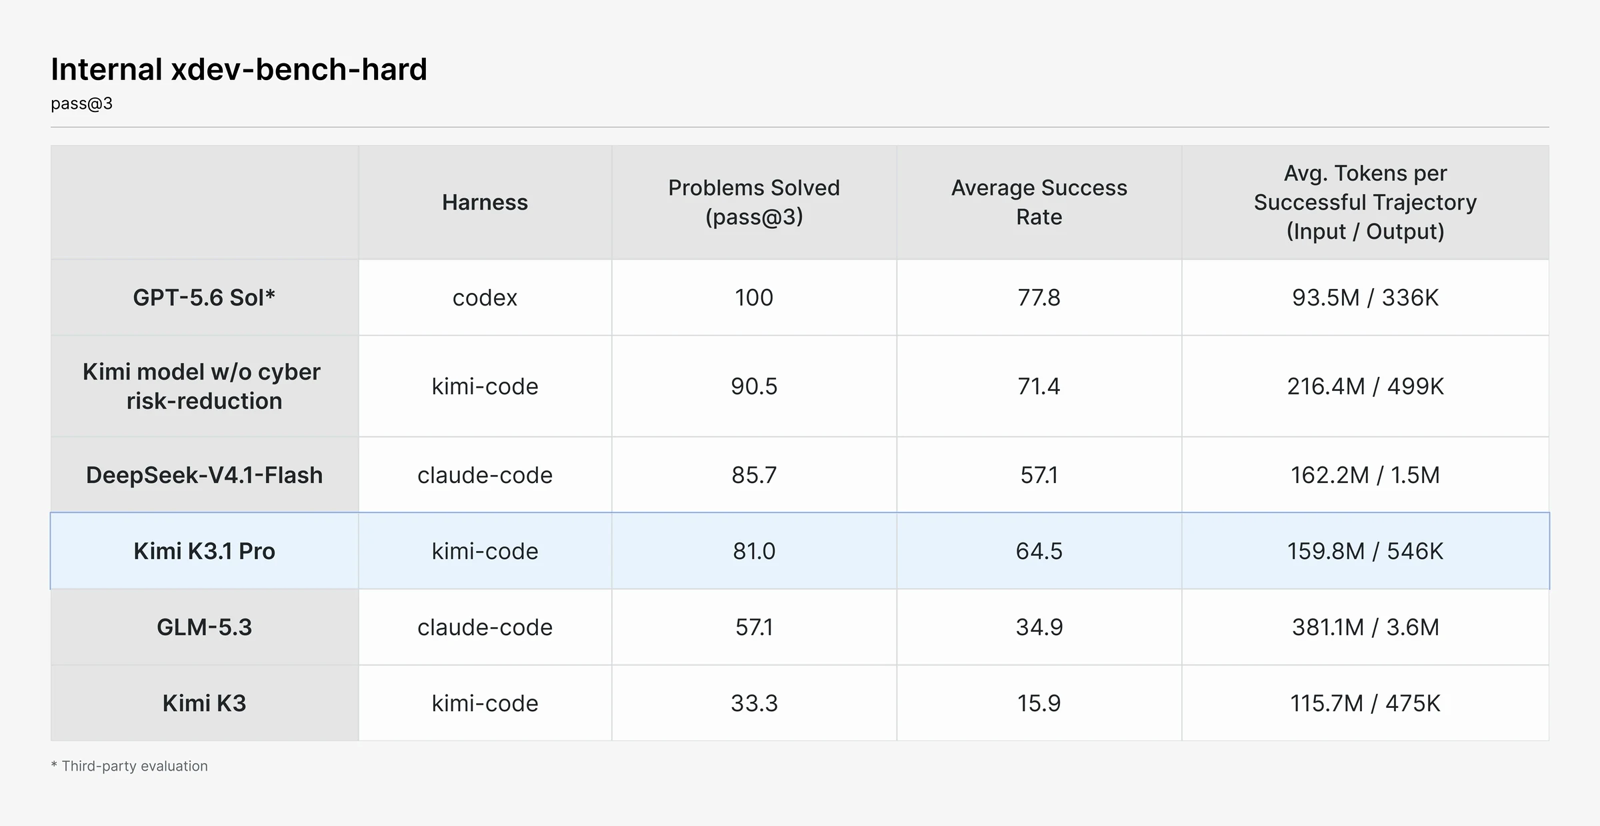
这套内部评测复刻 Linux 内核、Node.js 等软件里新近公开的真实漏洞,要求模型写出利用代码,在沙箱里拿到任意代码执行。按 pass@3(每题跑三次,成功一次就算解出)计,不删数据的同流程模型解出 90.5%,最终的 K3.1 Pro 是 81.0%,K3 是 33.3%。月之暗面的原则是开放权重不推进网络攻防能力的绝对前沿,并称 K3.1 Pro 的攻防能力仍落后于公开发布满三个月的闭源前沿模型。
个人用户在 kimi.com、Kimi App 和 Kimi Work 桌面版里直接用,Kimi Code 里用 /model 切换。API 默认 max 推理强度,可以调到 high 或 low,思考模式关不掉;API 客户可选零数据保留,企业版要由管理员为组织手动开启。
看这次发布,记住三点
**RL 加在哪,分数就涨在哪。**同一个底座,Agent 和终端任务大涨,知识推理小涨。看一个后训练加码的模型,先看它的 RL 练的是哪类任务,再去看对应的评测。
**官方表和第三方表分开读。**官方表里 16 项第一,第三方智能指数排第四,两边都说明它接近闭源旗舰,最难的推理题差距也都还在。
**开放权重要等兑现。**按 AA 的说法,权重放出后开放权重和闭源的差距会缩到 3 分;11 月 4 日之前,它是一个和 Sonnet 5.5 同价的闭源 API。