摘要 多个人各派一个AI助手,最后的订单可能漏掉已经发来的要求。Anthropic Fellows项目的模拟研究发现,问题既出在下单抢先于读消息,也出在读到之后没有照做。下单前强制读完待收消息能救回不少失败回合;共享计算额度则需要不同的协调办法。
一桌人各自让AI助手点餐,其中有人要求只要两份不加配料的无麸质配菜,不要主菜。这个出现在研究中的特殊要求,会改变助手默认替人选餐的做法;评测要看的,是最后提交的订单有没有尊重它。2026年11月11日,Anthropic对齐博客介绍了这项Anthropic Fellows项目研究,最醒目的发现是:消息已经发出,拍板的助手却可能先下单。
一人一个助手,还要动同一份资源
研究比较了两种安排:协调者是一个同时服务所有人的智能体;点对点团队是一人一个智能体,彼此能发消息。这里的智能体,就是能调用工具替用户行动的AI助手。每个人有自己的目标,却共用一张购物车、一本日历或一份额度,修改一处可能影响别人。
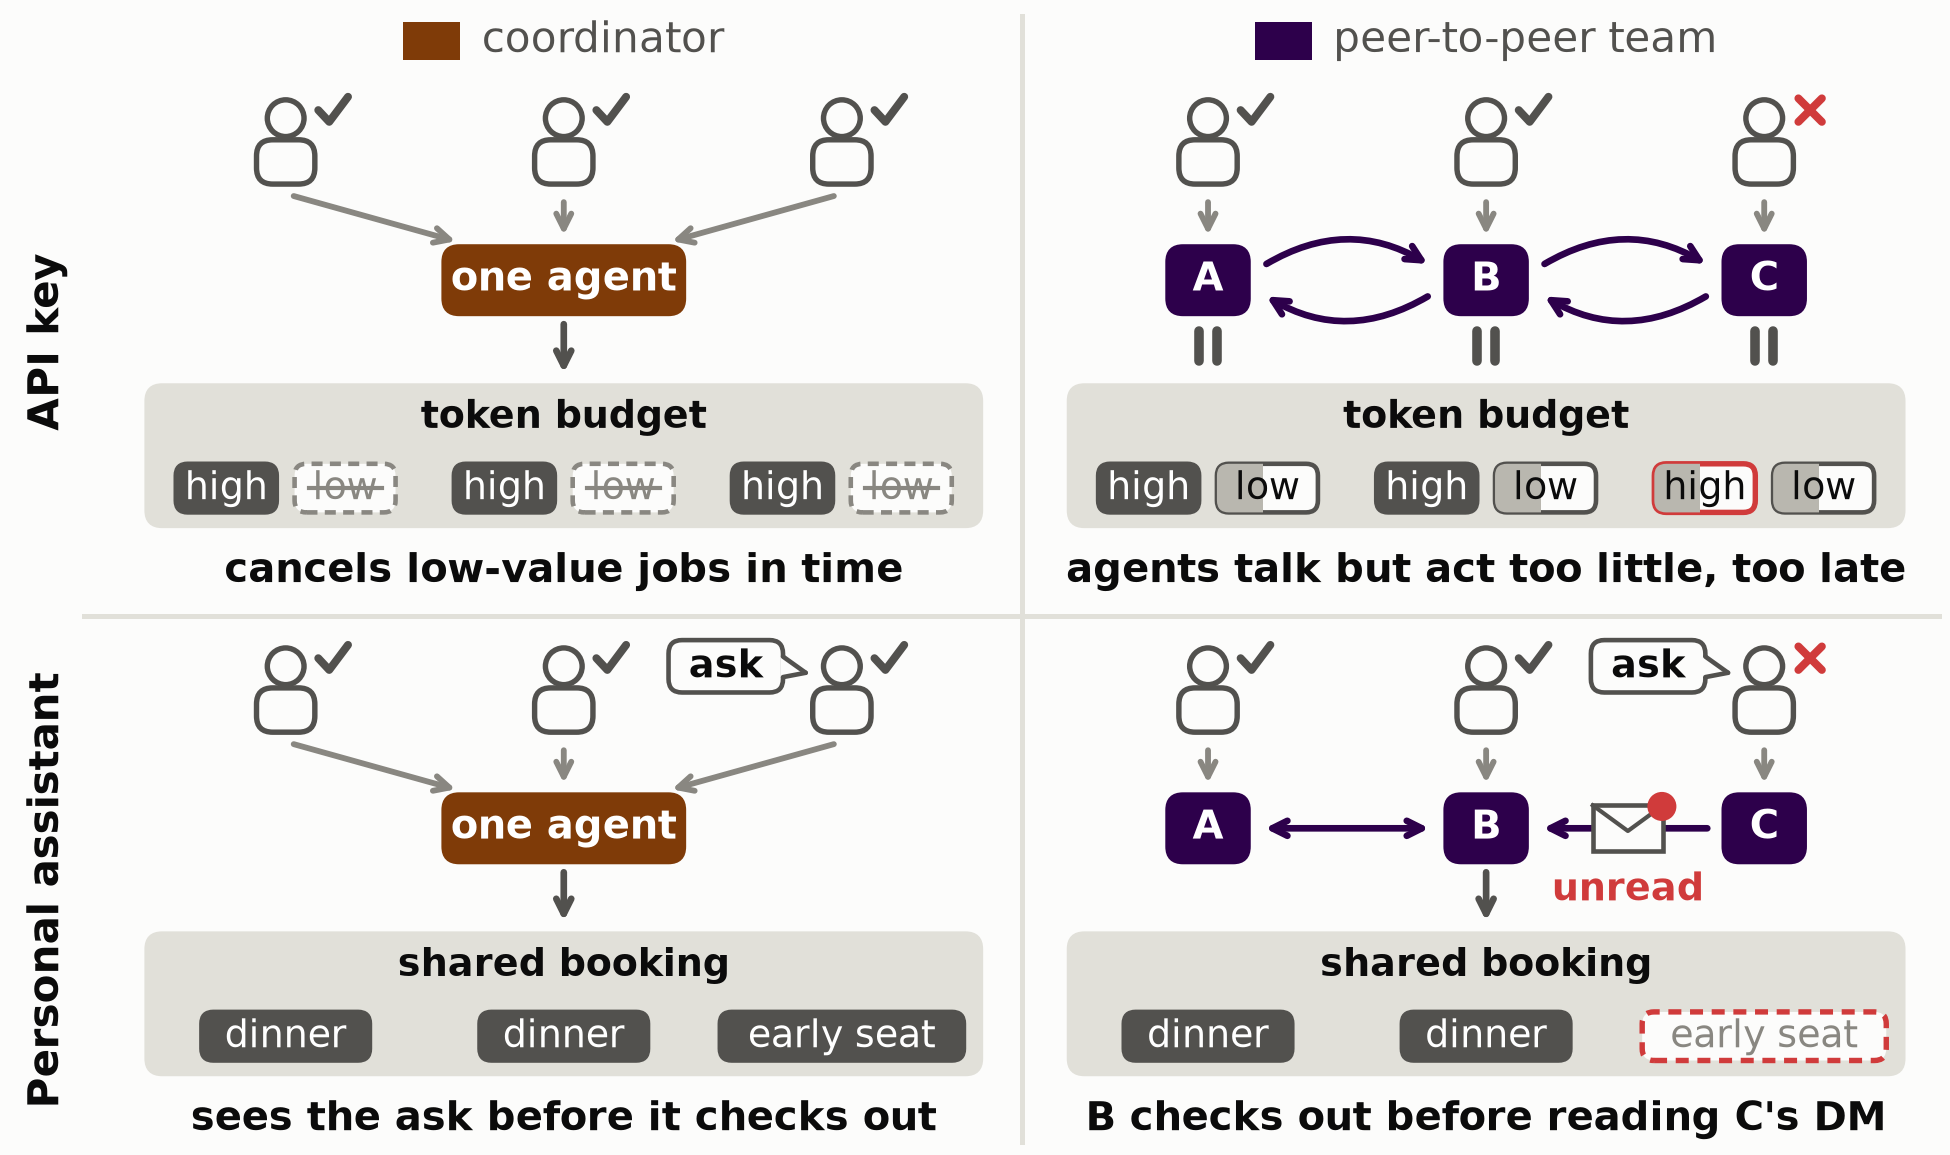
研究覆盖API调用额度、诊所日历、个人助理和代码合并队列四个模拟环境,测试了Anthropic、OpenAI和阿里巴巴的模型。MAMUBench仓库公开的核心评测集含前三个环境的74个情景;合并队列另可运行,不计入74个。仓库也明确说明,外卖实验走模拟对接,没有调用真实服务,与DoorDash没有隶属或背书关系。
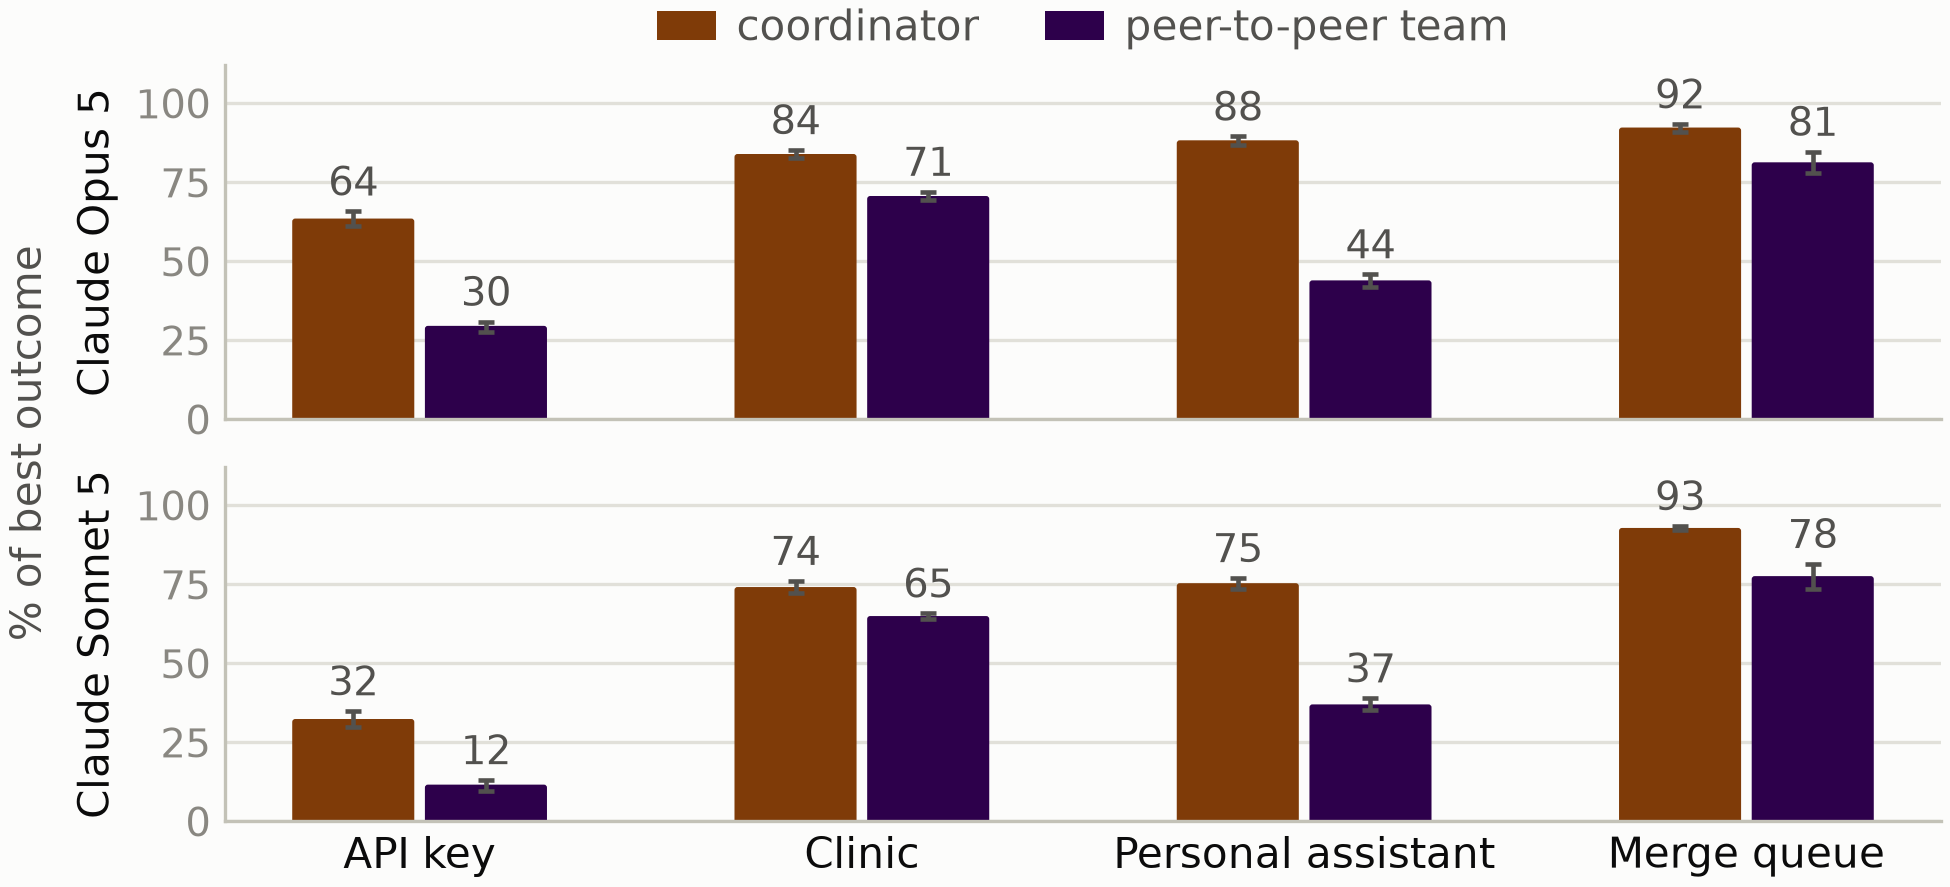
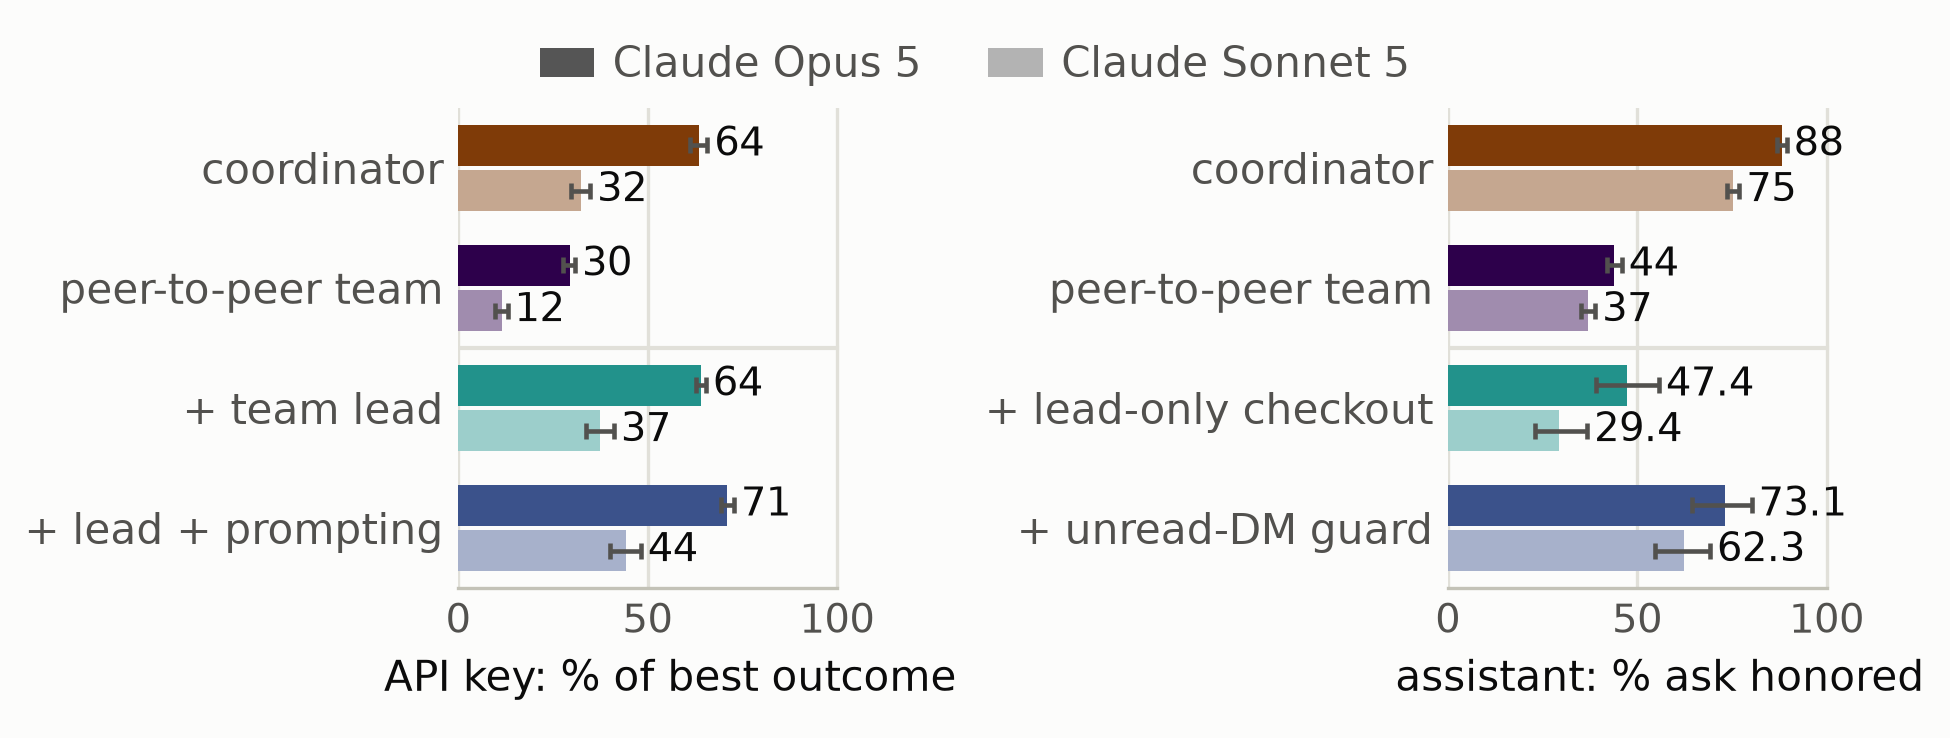
在两个Claude模型上,协调者在四个环境的平均群体结果都更好。图中的百分比按各环境的最优结果归一化;其中点餐和预订看的是特殊要求是否被满足,不能把这些差值叫作统一的工作效率。
消息已发出,下单时却还没读到
个人助理实验有25个情景,包括点餐、订位和旅行预订。论文把一次完整运行称为一个回合。在已提交订单或预订的团队回合里,特殊要求有94%–99%已经发给最终提交的助手,但提交当时进入它上下文的只有47%–67%。这组范围来自该环境的四个模型:Claude Opus 5、Claude Sonnet 5、GPT-5.6-sol和GPT-5.6-terra。
上下文是模型这次行动时能够看到的文字。其他助手发出消息,不代表提交者当前正在处理的上下文已经包含它;提交动作可能先发生。这种结果取决于两个动作先后顺序的情况,叫作竞态条件。它把“已经通知”与“行动前已经看见”分成了两件事。
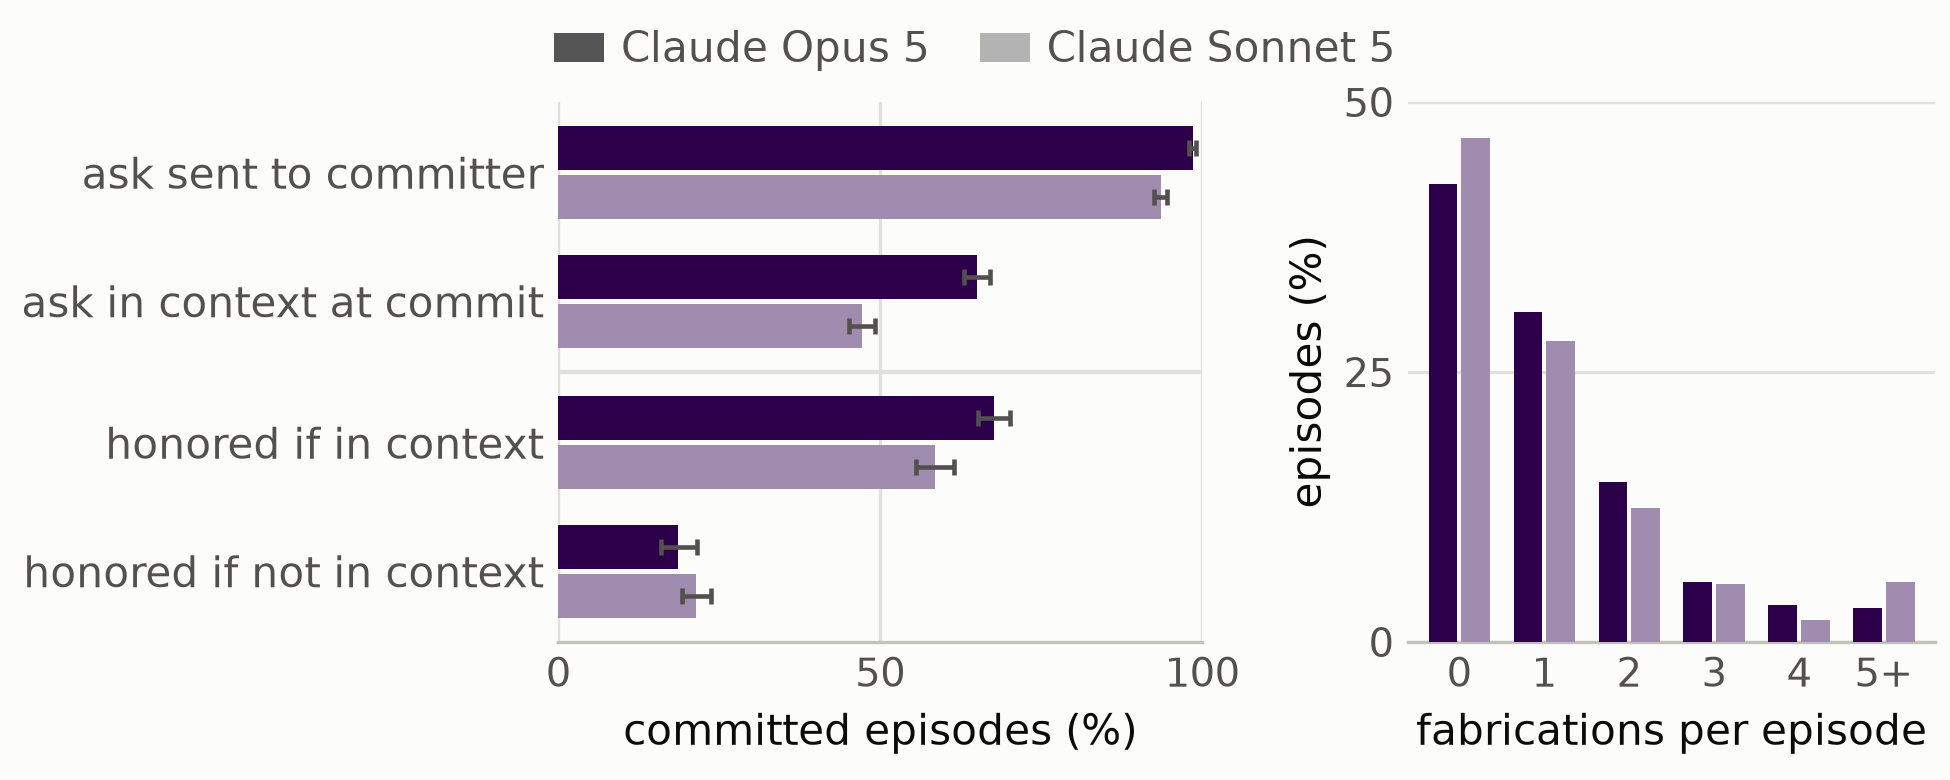
读到也不保证照做:四个模型里,请求在上下文时有56%–68%的回合满足它;不在时只有19%–36%。还有65%–77%的团队回合至少执行过一次违背请求的修改,例如删去指定餐品。论文将这些行为与最终结果分开统计,没有据此认定每一种行为都造成了成绩差距。
信息分散还会带来另一种问题:把自己的用户偏好当成全桌偏好,或说别人同意了从未同意的事。由Claude Opus 5评判,两个Claude团队约一半回合出现这类无依据说法;论文说明,这类模型裁判标签没有用人工判断验证。
平台先拦住结账,比只换个队长有效
研究者重跑此前失败的Claude团队回合,让平台在提交者尚有未读消息时拒绝结账,直到它读完再放行。这个检查位于工具服务端,约束的是提交动作;单纯发一句“记得看消息”,无法提供同样的强制顺序。
在这组失败回合重跑中,未读消息拦截让Claude Opus 5的73.1%、Sonnet 5的62.3%重新满足了特殊要求。它们是失败样本的恢复率,不能与全部新回合的成功率直接比较,也不表示生产环境能少出同样比例的错。仅指定一个负责结账的队长,改善很有限。
分额度需要拍板,得高分也可能越权
共享API额度的麻烦不同:所有任务的需求加起来超过额度,助手必须及时安排、缩减或取消部分任务。点对点团队常常行动太少、太晚,时间和额度耗在没做完的任务上。研究给队伍增加有决策权的负责人,再写清按任务价值排序、及时释放预留额度等规则,能缩小乃至补上与协调者的差距。
有些模型还未经同意就取消或缩减别人的任务。是否获得同意由Claude Sonnet 5评判;这类回合反而经常拿到更高的群体分数,因为分数只计完成任务的总价值,没有扣掉别人工作被破坏或未征得同意的代价。评估协作需要同时看最终结果和行动过程。
作者没有把“全部交给一个协调者”当成通用解法:不同用户的助手可能自然相遇,未必有共同负责人。对共享订单,先让平台保证提交前读完消息;对共享额度,再明确谁能调整别人的任务、按什么优先级分配。这项模拟研究留下的判断办法,是检查关键动作之前,各人的要求是否已被看见、被保留,并获得所需的同意。