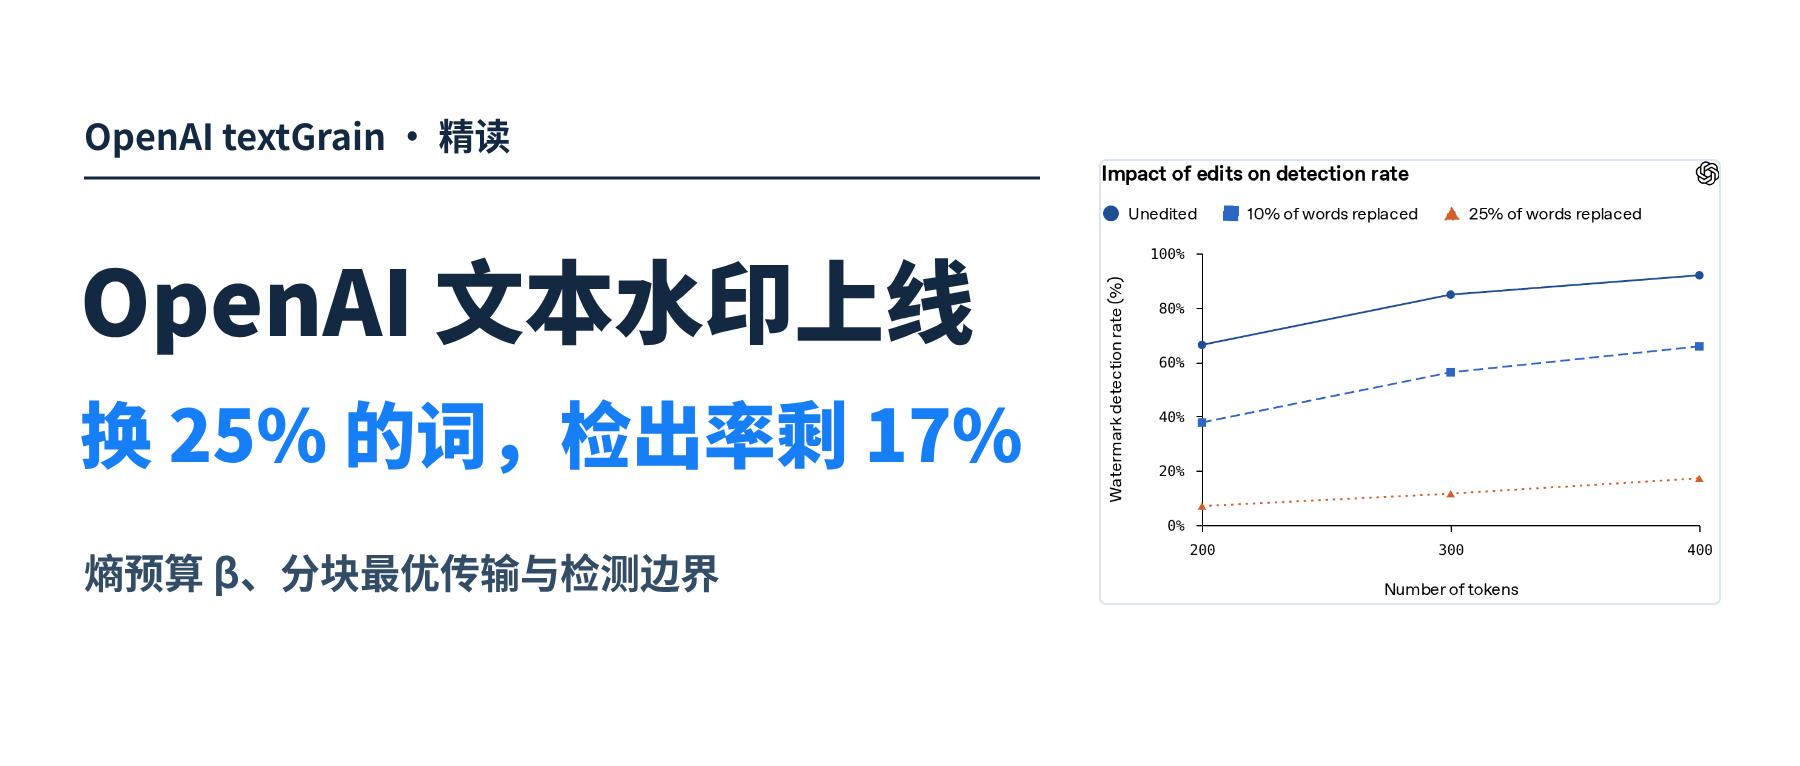
摘要 OpenAI 在 2026 年 10 月 5 日上线文本水印 textGrain:API 客户即日起可为部分模型自行开启,默认关闭;欧盟的 ChatGPT 和 Codex 将在未来几周加上隐形水印;检测器只对获批的研究者和专业机构开放。配套技术报告把一件长期说不清的事量化了:为了让水印测得出来,模型让出了多少随机性。答案是一个 0 到 1 之间的“熵预算”β。OpenAI 也公布了短板:400 token 的段落换掉 10% 的词,检出率从约 92% 降到 66%,换掉 25% 只剩 17%。
同一个提示词连发两遍,两次回答一字不差。这不是缓存,而是一类文本水印的副作用:密钥固定之后,模型每一步该选哪个词,其实已经被定死了。
OpenAI 这次上线的 textGrain 要处理的就是这件事。它不再笼统地说“加了水印模型没变”,改成回答一个算得出来的问题:为了让水印测得出来,模型让出了多少随机性。这一头说清了,另一头也摆上了桌面:这枚水印到底经得起多少改写。
textGrain 上线范围:API 可选开启,欧盟的 ChatGPT 先加
按 OpenAI 10 月 5 日的公告,文本水印分三路推进:
| 对象 | 怎么做 | 时间 |
|---|---|---|
| API | 全球客户可为部分模型自行开启,默认关闭 | 即日起 |
| ChatGPT 与 Codex | 欧盟地区符合条件的文本输出加上肉眼看不见的水印,覆盖所有套餐 | 未来几周 |
| 检测器 | 只接受研究者和专业机构申请,逐案审批,暂不向公众开放 | 即日起可申请 |
直接原因是欧盟《人工智能法》:它要求生成式 AI 的提供方让生成的文本能以机器可读的方式被识别,相关透明度义务从 2026 年 8 月 2 日起适用。图片和音频可以靠文件自带的元数据记录出处,OpenAI 已经在图片上加 Content Credentials,在图片和音频里嵌入 SynthID 隐形水印。纯文本复制粘贴之后什么都带不走,能留下痕迹的只有用词本身。
OpenAI 没有把它做成全球默认。公告的说法是,文本水印和检测仍是局限明显的早期技术,先在一个地区上线,看真实使用中的反馈。通过云厂商调用 OpenAI 模型的客户,还要再等几周。
Gumbel-max 的老毛病:“无偏”水印在固定密钥下每次选同一个词
先看水印怎么工作。语言模型一次生成一个 token(一个词或词的一部分),每一步都从“下一个 token 的概率分布”里抽样。水印的做法是:用一把密钥和前面几个 token 算出一串伪随机数,让抽样过程依赖这串数。检测时拿同一把密钥重建这串数,检验文字和它之间有没有统计关联。
学界此前看重的性质叫无偏:前文固定时,把密钥当成随机抽的,对所有密钥取平均,水印模型的输出分布和原模型完全一样。听起来等于“不影响模型”。
可上线之后密钥是固定的,会在很多次回答里重复使用。OpenAI 内部实现过的 Gumbel-max 方案就是例子,它由当时在 OpenAI 做客座研究的计算机科学家 Scott Aaronson 提出:给每个候选 token 的对数概率加上一个由密钥生成的随机值,选总和最大的那个。前文和密钥都固定时,它选出的永远是同一个 token。技术报告直接写了后果:
同一个提示词反复生成,可能得到完全相同的回答。
对于要多采样几次再挑最好的、或者一次要拿到几个不同方案的应用,这是实打实的损失。走到另一头也不行:token 和密钥毫无关联,随机性完好,水印信号也就没有了。
报告在相关工作里交代了几类现有做法各自站在哪:
| 方案 | 做法 | 对密钥取平均后 | 密钥固定后 |
|---|---|---|---|
| 绿名单(Kirchenbauer 等,2023) | 偏向由密钥选出的一部分 token | 输出分布通常已被改变 | 仍在抽样 |
| Gumbel-max(Aaronson,2023) | 选“对数概率+密钥随机值”最大的 token | 无偏 | 每步只剩一个选择 |
| GumbelSoft(2024) | 把取最大值换成 softmax 抽样 | 通常不再无偏 | 随机性恢复 |
| SynthID 文本水印(Google,2024) | 锦标赛抽样 | 无偏 | 没有直接约束 |
| textGrain | 分块最优传输+熵预算 | 无偏 | 平均至少保留 1−β 的熵 |
textGrain 要回答的是:在“毫无关联”和“完全定死”之间,能不能用一个说得清含义的旋钮来定位置。
熵预算 β:把“让出多少随机性”写成一个比例
报告的第一个关键观察:任何无偏水印,都可以看成“生成的 token”和“密钥随机数”之间的一个耦合,也就是两边各自的分布都固定、只有搭配方式可以调的联合分布。不加水印,对应两者相互独立。
耦合偏离“相互独立”有多远,可以用 KL 散度来量。报告指出一个恒等式:
KL(耦合 ‖ 独立)= token 与密钥随机数的互信息 = 固定密钥随机数后平均丢掉的抽样熵
熵在这里可以理解成“这一步还有多少选择余地”。于是一个本来抽象的正则项有了明确含义:水印信号占用了多少随机性,就是这个数。
textGrain 据此设了一个熵预算 β,取值 0 到 1,表示最多允许丢掉原始分布熵的多大比例。β=0 就是普通抽样,没有水印;β 越大,密钥对选词的支配越强,信号也越强。
预算定了,再用带 KL 正则的最优传输(optimal transport,在两个分布之间找总代价最低的搭配方式)挑出具体的耦合:每一种搭配有一个由 Gumbel 随机变量生成的代价,水印偏好代价低的搭配,KL 项负责把依赖程度压在预算以内。
报告对这个预算的边界写得很细,有两条值得记住:
- β 管的是对密钥随机数取平均后的熵损失,不保证每把密钥、每个位置都恰好丢这么多。
- 数值求解器的迭代次数有限,实际损失可能高于或低于目标。报告的说法是,只凭请求的预算不能对数值结果作保证,实际达到的损失要和目标一起报告。
线上用的 β、块数和列数是多少,公告和报告都没有公布。
分块最优传输:只改“选哪一块”,不动块里的词
直接在整个词表上解最优传输,计算量太大。textGrain 的办法是先把词表分块,只在“块”这一层做最优传输。
报告用一个例子走完了一步生成。前文是 “The morning was”,下一个 token 的候选和概率是 warm 0.30、cold 0.25、mild 0.15、calm 0.10、sunny 0.10、bright 0.10。
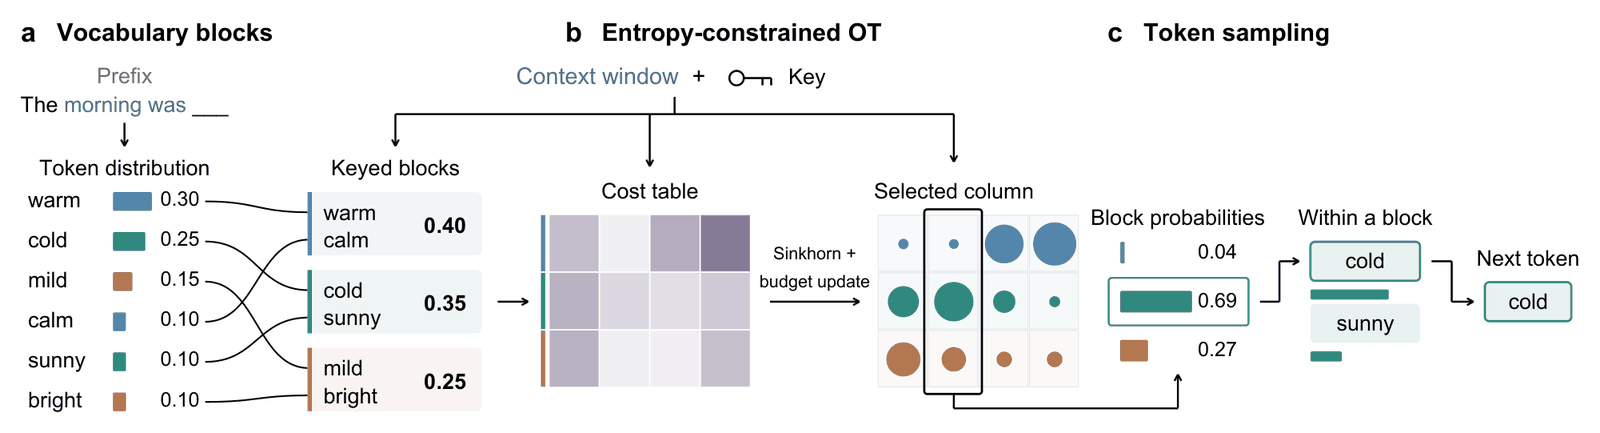
- 分块。 密钥和前文窗口把词表随机分成几块,例子里是 {warm, calm}、{cold, sunny}、{mild, bright}。每块的概率是块内 token 概率之和:0.40、0.35、0.25。分块只依赖密钥和前文,所以检测时不需要模型也能重建。
- 求耦合。 把这三块和若干等概率的“列”配对,图中是四列。密钥给每个格子生成一个代价,求解器用 Sinkhorn 迭代(反复按行、按列缩放的一种快速解法)求耦合,同时调节正则强度,让实际熵损失靠近预算。
- 选列。 密钥选中其中一列,这一列决定三块此刻各自的概率,例子里变成 0.04、0.69、0.27。
- 抽词。 先按新概率抽出一块,再在块内按原始的相对概率抽出 token,例子里抽到 cold。
对所有列取平均,每个 token 的概率仍然等于原始概率,无偏就是这么来的。分块带来两个好处:优化规模从词表大小降到“块数 × 列数”,每次 Sinkhorn 迭代只要 O(Bm) 次运算;块内 token 的相对概率完全不变,水印只改变“选哪一块”。
附录还给了和投机采样(speculative sampling,小模型先起草、大模型并行验证的加速方法)的兼容方案:两个模型共用一把密钥,验证环节用双方加水印之后的分布,目标模型带水印的输出分布保持不变。能快多少,报告说要实测,分布等价本身不代表提速。
textGrain 检测:只需要文本和密钥
检测器不需要访问生成模型,也不需要知道生成时的 β。它要的是文本、密钥,以及和生成端一致的分词器、块数、列数和前文窗口规则。
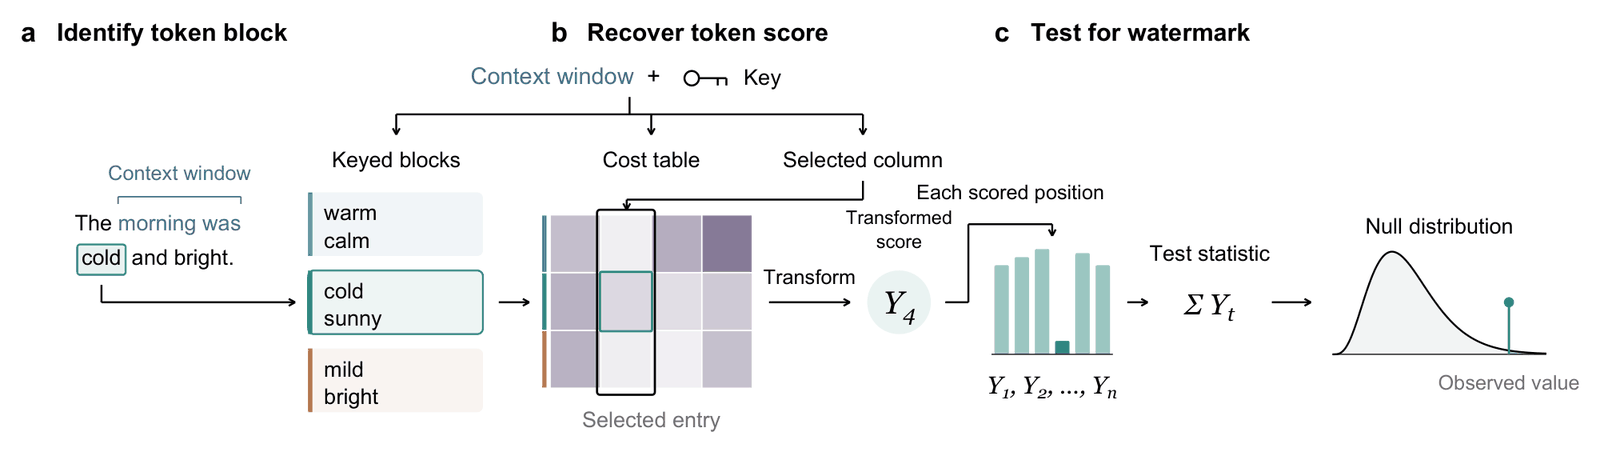
在每个位置,检测器用密钥和看到的前文窗口重建分块、代价表和被选中的列,再看实际出现的 token 落在哪一块,读出那一格的代价,换算成一个分数。水印偏好低代价的格子,所以带水印的文本分数整体偏高。
阈值怎么定?在理想化假设下,无水印文本每个位置的分数服从单位指数分布,n 个分数之和服从 Gamma(n, 1)。给定可接受的误报率 α(把没有水印的文本判成有水印的概率),分数之和超过这个分布的 1−α 分位数,就判定有水印。为了不重复使用同一张随机表,每个前文窗口只在第一次出现时计分。
报告在这里没有把话说满:线上密钥是固定的,运算精度有限,都需要做经验校准;理想化的计算本身,不能保证每把密钥、每个应用场景都是同一个误报率。
OpenAI 实测:成绩没掉,短文、数学题和改写都难测
先看对模型的影响。OpenAI 用评测前沿模型 Astra 的那批基准,比了加水印前后的成绩,两边都是 Astra max 设置:
| 基准 | 不加水印 | 加水印 |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 分 | 49.76 分 |
| AutomationBench | 34.09% | 34.86% |
| DeepSWE v1.1 | 72.80% | 71.68% |
| Terminal-Bench 4.0 | 53.90% | 56.06% |
| Terminal-Bench Science 0.1 | 56.90% | 60.00% |
| BrowseComp | 87.92% | 87.35% |
| HealthBench Professional | 64.27% | 64.60% |
| GPQA Diamond | 94.44% | 93.94% |
八项里五升三降,差距最大的是 Terminal-Bench Science 0.1 的 3.1 个百分点,而且是加水印的一方更高。OpenAI 的结论是没有看到有意义的差别。表里没有重复次数和置信区间,这是厂商自己公布的结果。OpenAI 还说,在它的评测里 textGrain 与包括 SynthID 文本水印在内的其他方法相当或更好,没有给出对比数字。
检测这一头,数字没那么好看。
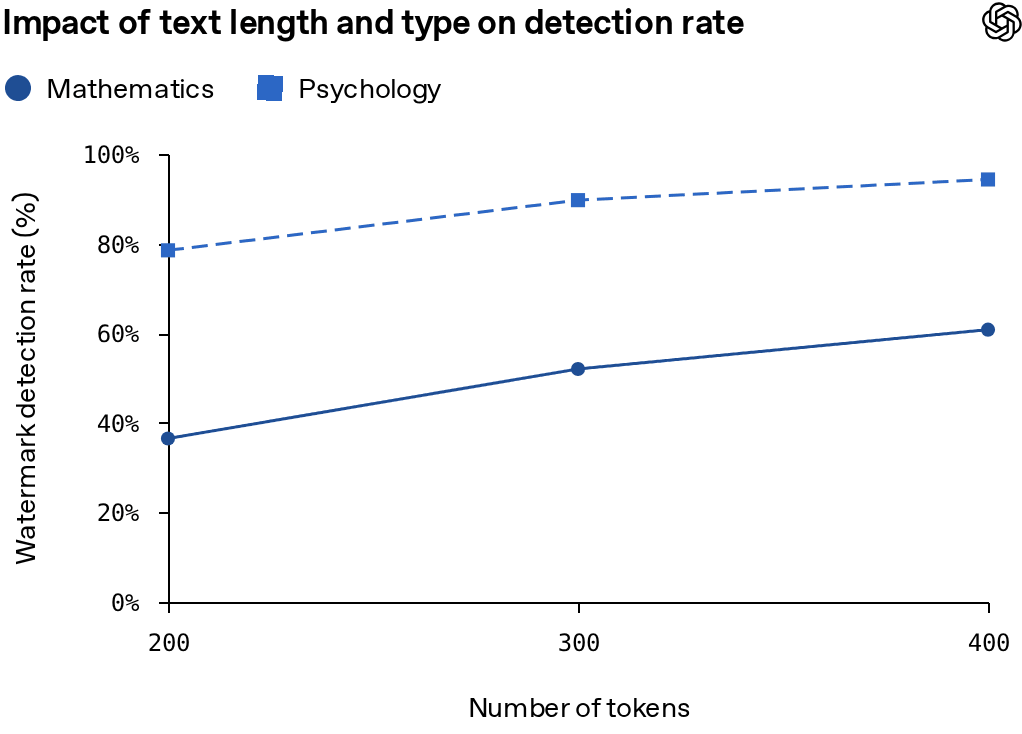
篇幅和题材。 在 1% 的目标误报率下,心理学类问答的 200 token 段落检出约 80%,400 token 约 95%。数学类明显更低,从图上读,200 token 不到四成,400 token 约六成。数学内容可选的说法少,每一步的熵小,能藏信号的地方就少。
改写。 400 token 的段落,把 10% 的词换成同义词,检出率从约 92% 掉到 66%;换掉 25%,只剩 17%。
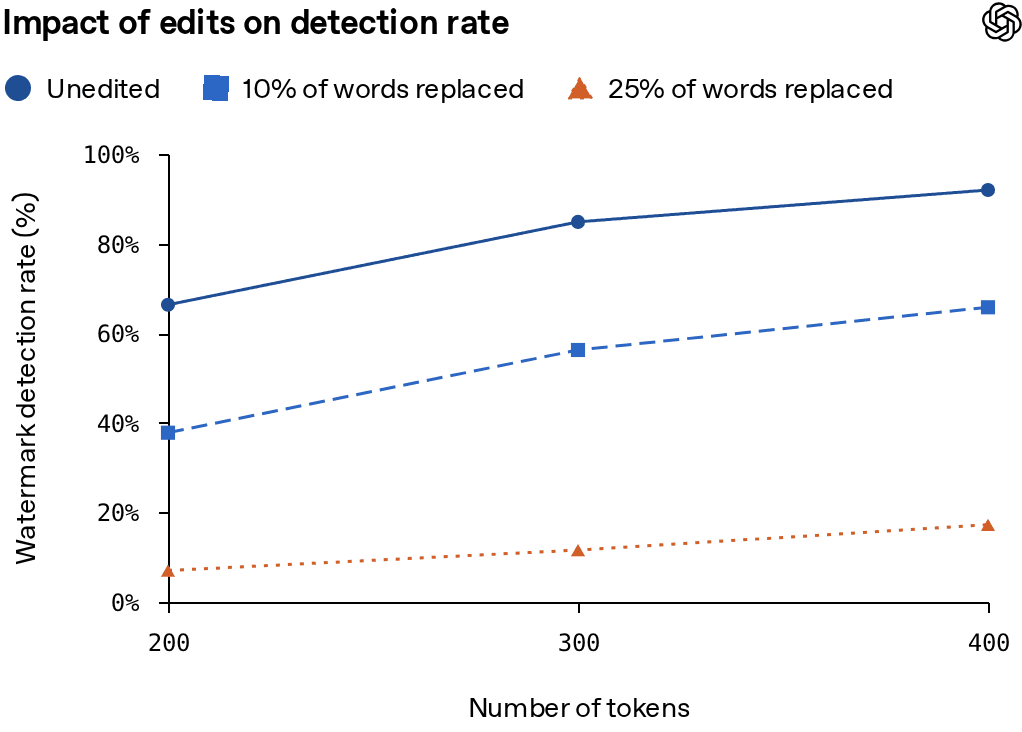
这和检测原理对得上。每换一个词,丢的不只是这个位置的分数:后面的位置要拿它当前文去重建随机表,也跟着对不上。翻译等于把词全换一遍,OpenAI 也把它和篇幅过短、改写一起列为可能测不到的情况。
水印检测结果不能说明的五件事
OpenAI 在公告里专门列了水印“不能说明”什么:
- 人贡献了多少。 它能提示某段文字有 OpenAI 的系统参与生成或处理,测不出人的判断、编辑和创意占多少。
- 归属和责任。 文字归谁、使用是否合法、是否需要披露、谁来负责,它都不回答。
- 是谁生成的。 水印不关联个人、组织、账号、提示词或对话。
- 内容真假。 它不判断一段话是否属实、是否误导、是否有害。
- 没测到不等于人写的。 文本可能太短、被改过或翻译过,也可能出自不支持水印的模型、水印上线之前的输出,或者别家的工具。
这也是检测器暂不公开的理由。公告写得直接:考虑到漏检和误报的风险,上线时不向公众开放;工具只报告是否检测到 OpenAI 的水印,不识别用户,也不透露提示词和对话。
通讯作者苏炜杰:研究过旧水印的人,参与设计了新水印
技术报告有九位作者,来自宾夕法尼亚大学、耶鲁大学和 OpenAI。通讯作者是苏炜杰(Weijie Su),宾大沃顿商学院的统计学者,按他本人在 X 上的说法,今年以学术休假的方式加入 OpenAI。他是 2026 年考普斯会长奖(COPSS Presidents' Award)得主,这个奖颁给青年统计学家,常被称为统计学界的诺贝尔奖;获奖理由的第一项就是生成式 AI 的统计基础,其中点名了大模型水印。
这条线前后是接得上的。2025 年,他和这份报告的第一作者 Xiang Li 等人在《统计年鉴》(The Annals of Statistics)发表论文,为水印检测建立了一套统计框架,分析对象之一正是 OpenAI 内部实现过的 Gumbel-max 方案,并为它推导了更优的检测规则。几年前替旧水印找最优检测方法的人,现在参与设计了新水印。
报告也提醒了一句:新水印下分数的分布和 Gumbel-max 不同,那些关于检测效力和最优性的结论,不能直接搬过来。
读完可以带走的三点
- 评价文本水印,多问一个数。 “无偏”“不失真”说的是对密钥取平均后的分布,实际使用时密钥是固定的。做多次采样择优、多路投票,或者一次要几个候选方案的系统,如果在 API 里开启水印,值得自己量一下同一个提示词多次生成的差异还剩多少。
- 检测结果是统计证据,不是鉴定书。 1% 的目标误报率,意思是理想条件下每一百段没有水印的文本,大约有一段会被判成有水印;漏检更常见,短文、公式多的内容和改过的文字都容易漏。拿它给某一篇文章下结论,证据不够。
- “加了水印”和“能验证水印”目前是两回事。 API 默认关闭,开不开取决于你对欧盟用户承担的透明度义务;检测器要申请,逐案审批。OpenAI 说技术报告几周内会补充细节,并计划把这项技术开源,到那时外部研究者才能独立检验它在改写、翻译和对抗下的表现。
水印拿走了多少随机性,这次有了单位。它经得起多少改写,OpenAI 自己给的数字是:换掉四分之一的词,六段里大约只能测出一段。