摘要 10 月 30 日,博主数字生命卡兹克发帖说,Qwen 3.8 Flash 在简单的准确性任务上“意外的强”,他们各产品的自动化任务已经有一大半被 Claude Opus 5.5 切换成了 Qwen 3.8 Flash。很多人读成“旗舰 Opus 被便宜模型取代”,但作者在回复里澄清:是 Opus 帮他做决策,跑完评估后把后台不少接口从 DeepSeek 换成了 Qwen 3.8 Flash。配图里的那次对比,用同一份提示词让两款小模型读 47 段周报、各跑 2 轮:Qwen 3.8 Flash 94 次全读对,DeepSeek V4.1 Flash 读对 87 次,用的 token 是前者的 3.5 倍。这说明的不是“小模型全面胜出”,而是一种值得照做的换法:用自己的真实任务、让强模型当裁判打分,再把简单的活交给便宜模型。
“一大半自动化任务从 Claude Opus 换成了 Qwen 3.8 Flash”,这句话在圈里传得很快。翻完原帖的回复区和配图,事情和第一眼读到的不太一样,而真实的版本反而更值得照着做。
原帖说了什么,作者又澄清了什么
10 月 30 日,数字生命卡兹克(科技博主,同名公众号作者)发帖:在一些简单的准确性任务评测里,Qwen 3.8 Flash 这个模型“意外的强”;他们各种产品的很多自动化任务,“居然已经一大半都被 Claude Opus 5.5 切换成 Qwen 3.8 Flash 了”。截至发稿,帖子有约 3.5 万次浏览、78 条回复。
这句话有两种读法:一种是“原来用 Opus 跑的任务,换成了 Qwen”;另一种是“Opus 动手,把任务切到了 Qwen”。不少读者按第一种理解,回复里有人说“Opus 5.5 月薪几千刀的活 Qwen 3.8 Flash 几毛钱干完”。作者随后在回复区澄清,是第二种:“不是从 Opus 切换,是 Claude Opus 5.5 现在会帮我做很多决策”,它在跑了评估以后,把后台的一些接口“很多都从 DeepSeek 换成 Qwen 3.8 Flash 了”。作者在另一条回复里也说,换的“只是简单的任务”。
所以 Opus 在这里是裁判,下场的是 DeepSeek V4.1 Flash,上场的是 Qwen 3.8 Flash。它说明的是小模型之间的取舍,以及让强模型替你做评估这件事,而不是 Qwen 取代了 Opus。
那 94 次对比:全读对、更快,token 只用了不到三分之一
原帖的配图是一段对话截图:有人问“为啥不用 DeepSeek V4.1 Flash”,AI 助手在运行了两条命令后给出一张对比表。任务是从周报进展里读出关键结果的数字(比如某个目标现在做到了多少),两个模型用同一份提示词、同样的 47 段周报,各跑 2 轮,一共 94 次。
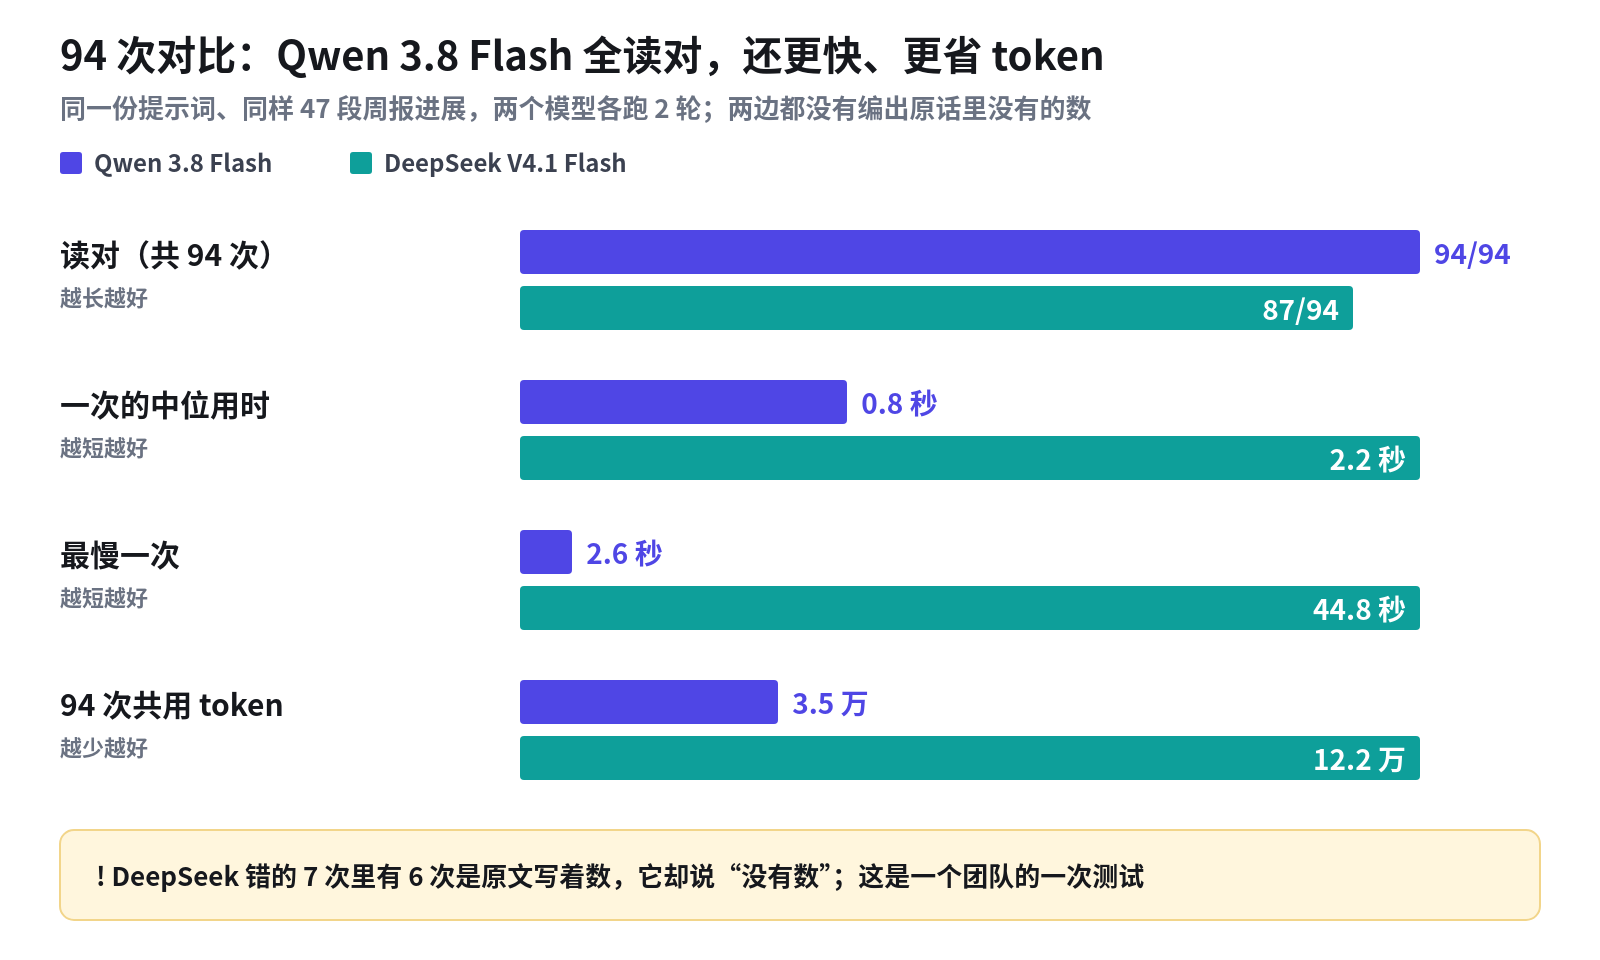
Qwen 3.8 Flash 94 次全读对,DeepSeek V4.1 Flash 读对 87 次;两边都没有编出原文里没有的数。速度上,中位用时(把 94 次的耗时从短到长排开,正中间那次)是 0.8 秒对 2.2 秒,最慢的一次差得更多:2.6 秒对 44.8 秒。94 次一共用掉的 token(模型按它计费的文字单位)是 3.5 万对 12.2 万。
截图还写了 DeepSeek 错在哪:7 次错误里有 6 次是周报里明明写着数,它却说“没有数”;还有 1 次把目标值 4 当成了当前进度,实际已经做到 5。漏读的后果是那条关键结果不会自动更新。截图最后一句是“换模型只要改一行代码,以后 DeepSeek 出新版本,拿同一套 94 次再测一遍就知道该不该换”。
不过这组数别读过头。它是一个团队、一种任务、47 段样本的测试,评测方法和其他被换掉的任务清单都没有公开;作者自己也只说是“简单的任务”。它能证明的是:在“从一段文字里准确抠出数字”这类活上,Qwen 3.8 Flash 至少不输同档的 DeepSeek V4.1 Flash,而且明显更省。
Qwen 3.8 Flash 是什么,贵不贵
Qwen 3.8 Flash 是阿里通义千问 8 月 26 日上线的轻量多模态模型(能读文字、图片和视频,输出文字)。官方模型页写明:原生支持 100 万 token 的上下文(模型一次调用能看到的全部文字),同时兼容 OpenAI 和 Anthropic 两家的接口协议,可以直接接进 Claude Code、Codex 这类开发工具。
价格是它最大的卖点。国际站标价每百万 token 输入 0.15 美元、输出 0.47 美元;阿里云百炼平台 8 月 27 日起把国内价下调到输入 0.8 元、输出 2.7 元。作为对照,Anthropic 官方给 Claude Opus 5.5 的标价是输入 4 美元、输出 20 美元。
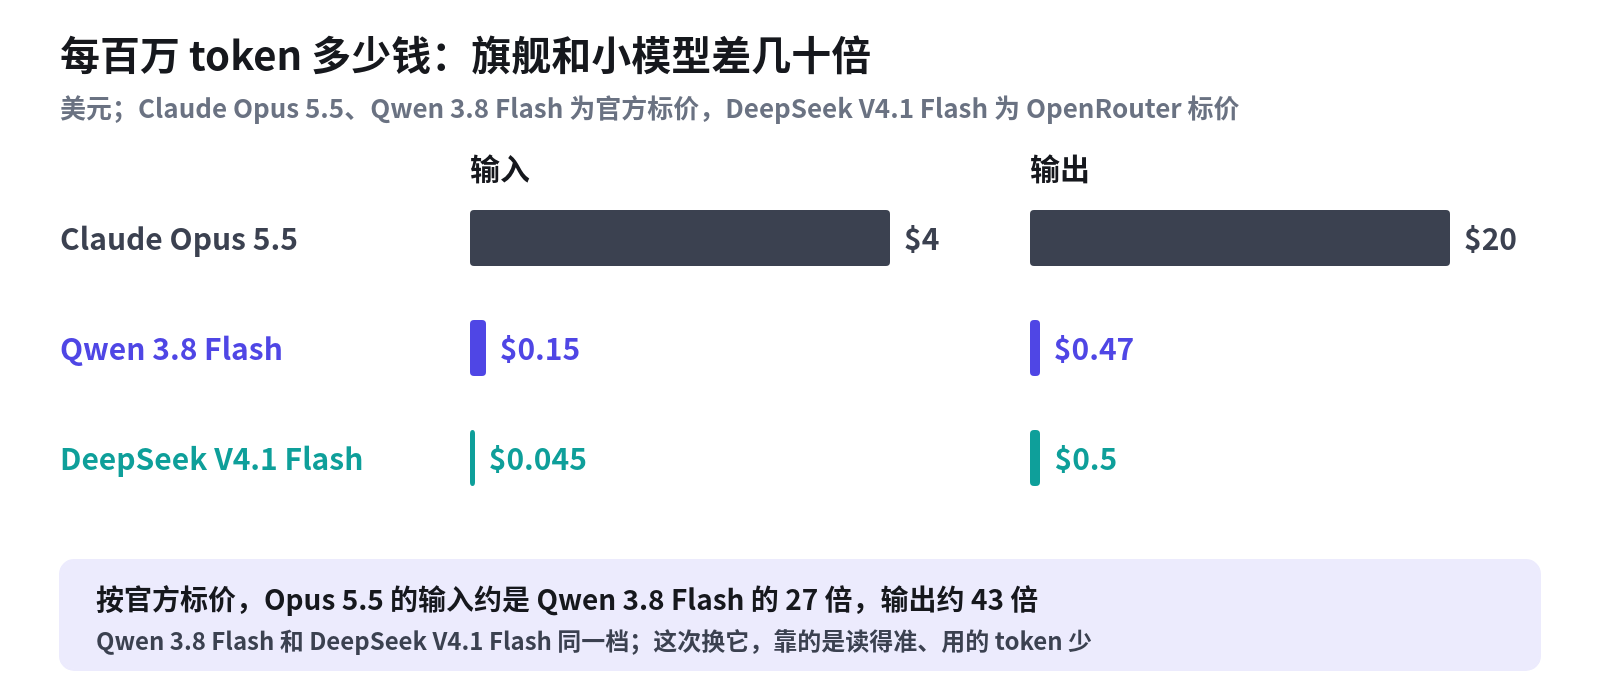
按标价算,Opus 5.5 的输入约是 Qwen 3.8 Flash 的 27 倍,输出约 43 倍。不过这次被换掉的 DeepSeek V4.1 Flash 和它本就在同一档:OpenRouter 上的标价是输入 0.045 美元、输出 0.5 美元,输入单价更低、输出略高。卡兹克那边换它,靠的不是单价,而是读得更准、用的 token 只有不到三分之一,实际账单才会更低。真正花钱的是“单价 × 用量”,只比单价会看错。
哪些活可以交给便宜模型
回复区里做自动化的人给出的经验很一致:分类、抽取、改写、格式化、简单判断这类目标明确的任务,小模型基本够用。一位读者的说法很具体:周报数据提取的关键是格式对齐和抓准确定的字段,不需要多步推理,轻量模型直接定位原文,单次几百毫秒就能完成;重型推理模型做这种受限的短任务,反而容易想太多,个别请求还会拖到几十秒。截图里 DeepSeek 最慢的一次用了 44.8 秒,原因截图没写。
反过来,复杂推理、长链路规划、需要跨很多步保持判断的任务,仍然是旗舰模型的地盘。卡兹克自己的做法也正好说明这一点:决定换谁、怎么评估,还是交给了 Opus 5.5。
回复区最常被问到的是两件事:怎么判断一个任务算“简单”,以及小模型出错了谁来兜底。一位读者提醒,“切小模型最怕简单任务里混着几个不简单的”,他的办法是按任务类型分别看准确率,不只看总分;小模型的输出过不了格式校验,就自动回退到旗舰模型。这样省下的是实打实的钱,翻车的那部分也有人接住。
自己试一次:用真实任务给模型打分
这件事最值得抄的不是“换成 Qwen”,而是换之前先量一下。照着卡兹克截图里的做法,四步就能做一次自己的对比:
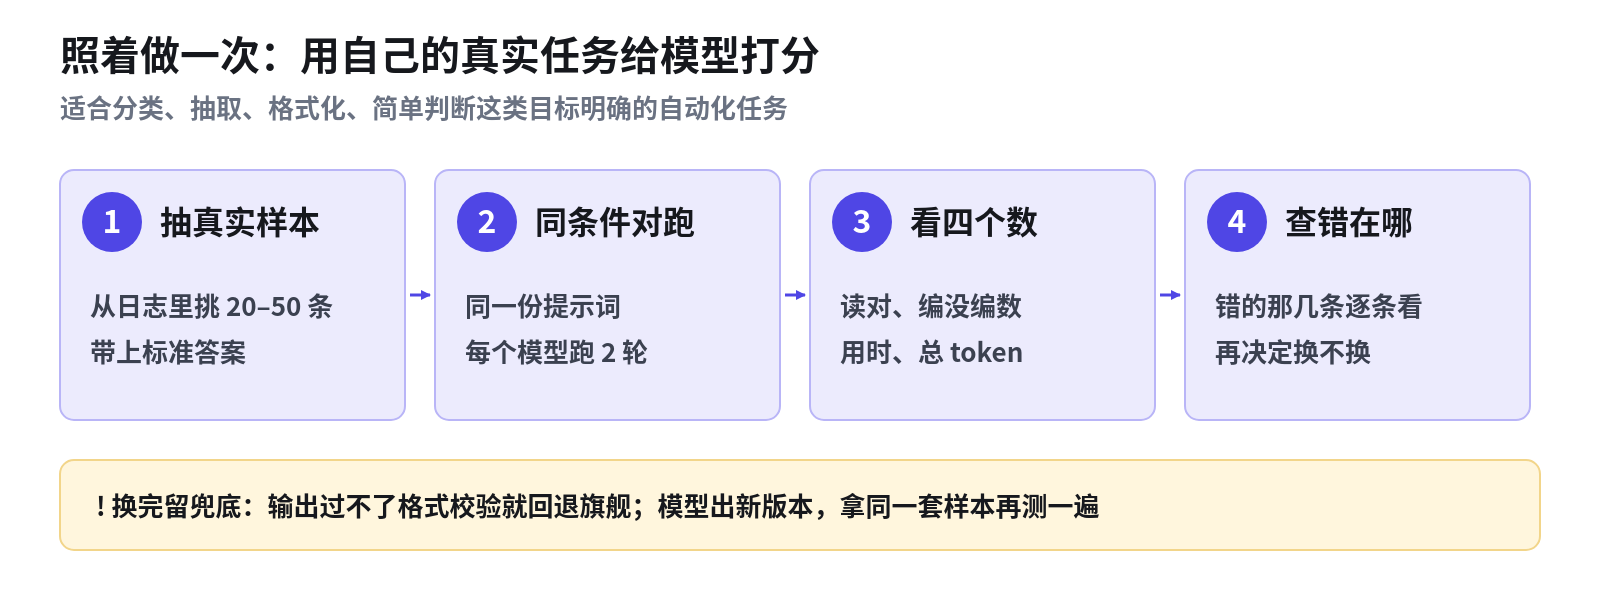
第一步,从自己的日志里挑 1 个高频的自动化任务,抽 20–50 条真实样本,配上标准答案(可以用旗舰模型当时的输出,人工核一遍)。第二步,同一份提示词,让现在用的模型和 Qwen 3.8 Flash 各跑 2 轮。第三步,看四个数:读对几条、有没有编出原文没有的内容、中位和最慢用时、总 token。第四步,把错的那几条逐条看完再决定。
这件活本身也可以交给 Claude Opus、Claude Code 这类强模型去跑,卡兹克就是这么做的。因为 Qwen 3.8 Flash 兼容 Anthropic 和 OpenAI 的接口协议,在现有工具链里试,多数时候只需要按官方文档改接口地址、密钥和模型名 qwen3.8-flash。换完后留两道保险:输出过不了校验就回退旗舰模型;任何一边出了新版本,拿同一套样本再测一遍。
挑一个你每天都在跑的自动化任务,今天就拿 20 条样本试一次,比看榜单更能告诉你这件活该交给谁。