摘要 Qwen4-Max正式版开放按量API,国内北京部署输入10元、输出30元/百万Token。一次任务的账单还取决于思考长度、缓存复用和工具调用;官方评测中的任务降本,不能直接当成你的固定单次价格。接入时需区分正式版与预览版、套餐与按量端点,以及两地Claude Code文档的配置差异。
让编程助手读一遍项目、按截图改页面,再运行测试修错,同一份代码可能被读很多次,模型也会生成一段看不见的思考。换成按量API后,最后交回的一小段修改说明,远不是这次任务的全部用量。Qwen4-Max正式版的变化,正适合从这张账单看起。
正式版来了,预览版还在自己的窗口里
北京时间11月16日10:01,千问正式发布Qwen4-Max,调用型号为qwen4-max。它同时提供Token Plan和按量API;前者按Credits(套餐额度点数)计量,后者按实际消耗结算。Token Plan面向兼容工具的交互式使用,不能把个人版套餐Key当作应用后台的通用Key。对想把模型接进应用的人来说,变化是有了按量调用入口,而不只是多了一个可以在聊天界面里选的名字。
11月11日上线的qwen4-max-preview仍是另一款型号,预览窗口到北京时间11月25日24:00。正式发布不等于预览版已经下线,预览活动的Credits折扣也不能套到正式版。接入时先确认模型ID、计费方式和专属API Key与端点是否配套,不能只删掉名字里的“preview”就认定账单规则也随之切换。
QwenWork、Qoder、QwenStudio等产品也可体验正式版。官方预告后续开放Qwen4中小模型的权重;这次Max上线提供的是服务,不能据此写成Max已开放权重。
输入10元,输出30元,思考也算输出
Token是模型处理内容的计量单位,不等同于中文字数。千问AI平台目前列出的Qwen4-Max北京部署单价是:普通输入10元、输出30元,单位均为每百万Token。思考与非思考模式同价,也不按输入长度分档;但思考也按输出计费,所以同价不代表两种模式花费相同。
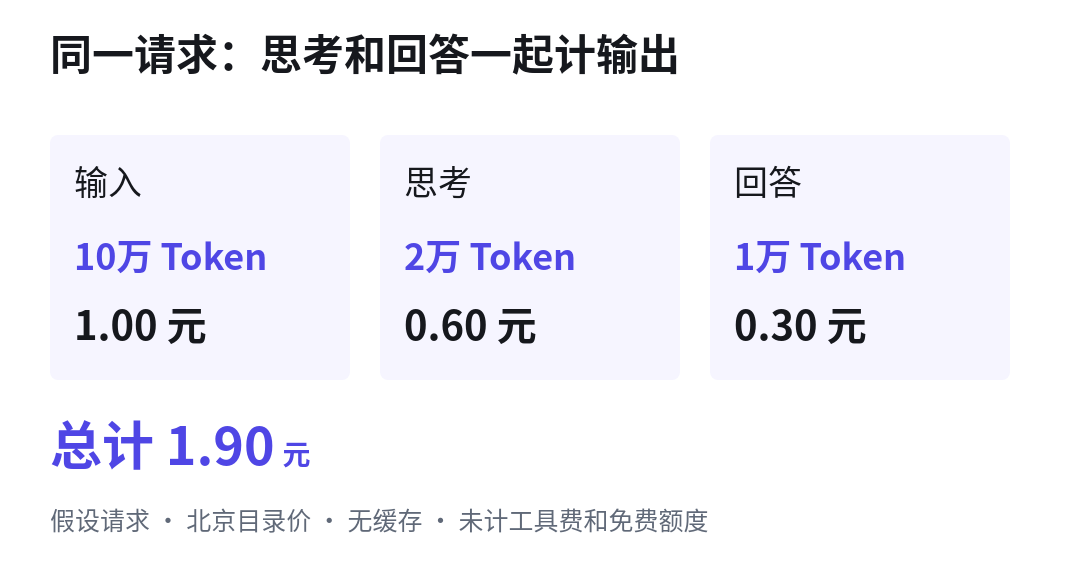
用一个纯文字、无缓存、无工具费用的假设请求算账:输入10万Token,生成2万Token思考和1万Token最终回答,费用为1元输入加0.9元输出,共1.9元。若只按最终可见的1万Token回答估算,就会漏掉0.6元思考费用。这是按目录价计算的示例,不是实测请求。
工具费用还要另看。国内计费文档列出,内置联网搜索一般为4元/千次,PDF解析为0.02元/页;Function calling(让模型请求外部函数)和MCP协议本身不收工具费,但工具说明会占输入Token,外部服务也可能另有收费。这样算出的才接近一次完整任务,而非最后一轮回答的价格。
新加坡QwenCloud标价则是输入1.5美元、输出4.5美元/百万Token,缓存读取0.075美元。官方所说较Qwen3.8-Max降价、隐式缓存价格下降70%,对应其美元报价;不能直接外推为国内人民币同幅降价。选地区时应使用相应平台的价表和凭证。
0.5元是读取价,缓存要靠重复使用省钱
代码仓库、工具说明和固定参考资料,会在多轮任务里反复出现在输入开头。缓存把这段公共前缀的计算结果留住,后续命中时复用,减少重复计算。国内显式、隐式缓存读取价都是0.5元/百万Token;它只适用于命中的那部分输入,剩余输入和输出仍按各自规则计费。
显式缓存需要先创建:保存5分钟的创建价为12.5元/百万Token,保存1小时为20元。创建价高于普通输入价,所以一次性材料未必值得缓存;重复读取越多,才越可能抵消创建费用。隐式缓存由平台自动识别公共前缀,命中并不保证。显式缓存则要求前缀完全一致、仍在有效期内;把变动的问题放在固定材料之后,有助于保持可复用部分稳定。
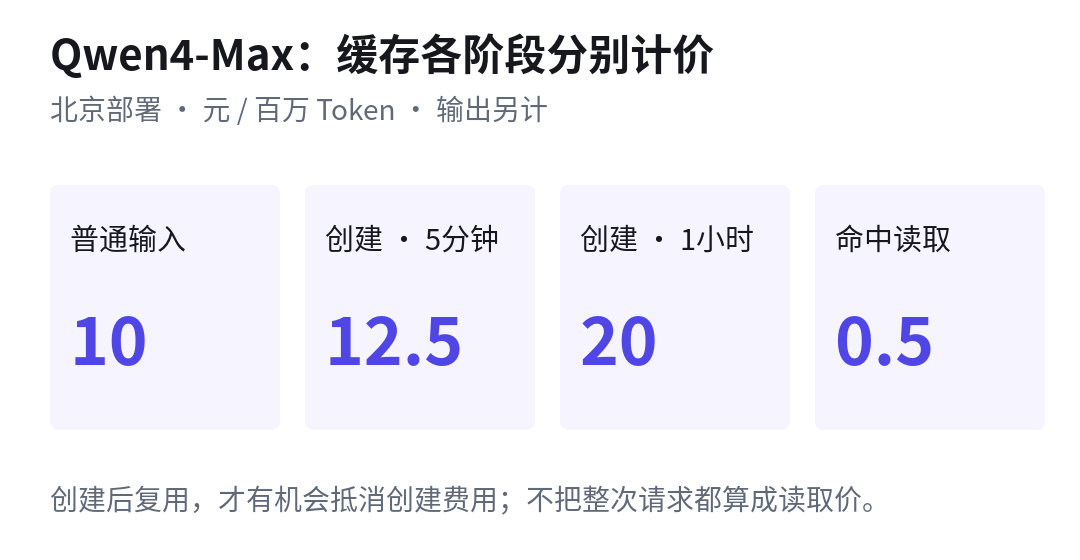
例如,一份10万Token的固定材料,按5分钟创建价计为1.25元,后续一次命中读取为0.05元;如果两次都普通输入,则共2元。这个简化示例合计1.30元,只比较这段前缀,假设第二次在有效期内完全命中,不含新增输入、输出和工具费用。省下来的来自复用,不是把整次请求都改成0.5元的单价。
Claude Code接Anthropic兼容接口,配置按平台核对
正式版支持OpenAI Chat Completions、Responses、Anthropic Messages和DashScope。这里的“兼容”是沿用相应协议的请求格式,让已有客户端接入;不代表每个接口支持的功能完全一样。例如,Qwen4新显式缓存支持前三种接口,DashScope暂不支持,而且DashScope调用这款模型时,即使只发文字,也要使用多模态端点。
Claude Code走Anthropic兼容端点,不能填OpenAI兼容端点。两地官方文档都提示,将ANTHROPIC_DEFAULT_OPUS_MODEL设为qwen4-max,上下文配置保持CLAUDE_CODE_MAX_CONTEXT_TOKENS=983616。若长输出被截断,国内页面建议CLAUDE_CODE_MAX_OUTPUT_TOKENS=64000,国际页面建议131072;应按所用平台核对,不能把其中一个写成全球统一值。页面下方部分通用示例还保留旧模型名,复制后也要检查主模型与各档映射。
模型本身的上下文窗口为100万Token,非思考模式最大输出131,072 Token,思考与最终回答合计最多262,144 Token。默认开启思考,强度为high,思考预算131,072 Token;预算是上限设置,不是每次固定消耗。长任务还需要保留历史assistant消息及思考内容;若开启CoT Summary(思维链摘要与加密),显示摘要之外的历史密文应原样回传,不能拿摘要替代完整历史思考。
按量API提供100万Token免费额度,与Token Plan Credits分开。新用户需完成实名认证并开通平台;免费额度通常有效90天:开通时已有的模型从账号开通日算,开通后新增的模型从发布日期算。具体剩余量和到期日以权益页为准。免费额度不抵内置工具费,“用尽即停”默认关闭,试用前可自行开启。
任务少用Token,是另一种降本
Qwen4-Max采用MoE(混合专家)架构,处理每个Token时只激活部分参数。阿里云公告列出的主干规模为2.4万亿参数,每Token激活710亿,较同为2.4万亿规模的Qwen3.8-Max少25%。它原生支持视觉输入,能把代码、图纸和截图放进同一个任务里处理;参数规模本身不能替代交付质量的比较。
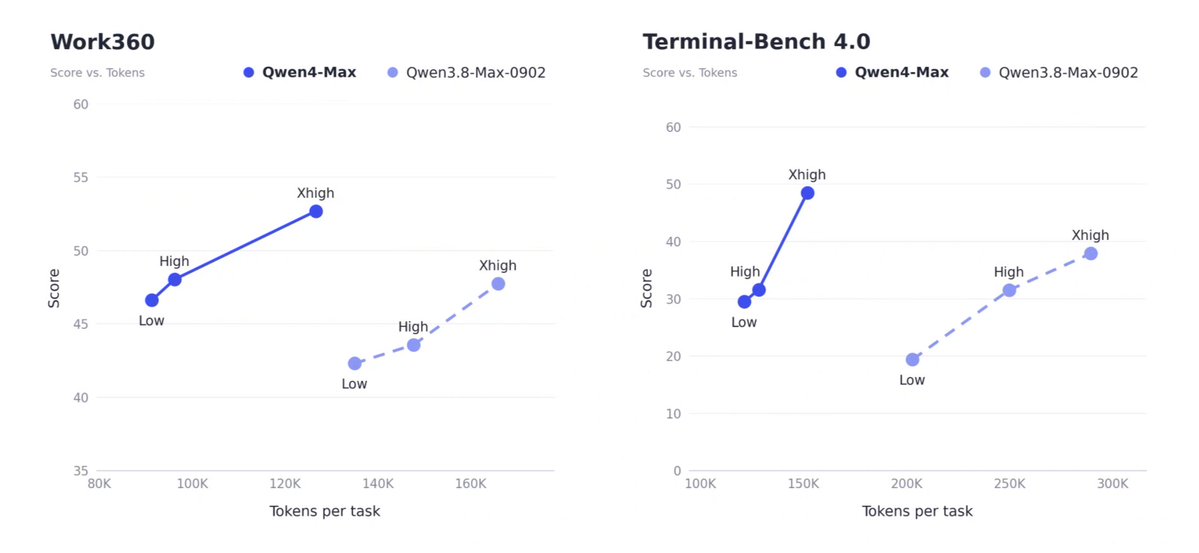
官方Work360评测覆盖行业任务,报告相较Qwen3.8-Max,Qwen4-Max在Xhigh、High两档思考强度下分别少用约24%、35%的Token;Terminal-Bench 4.0中分别少用约48%、49%。官方同时报告,Work360平均每任务成本从4.43美元降至1.67美元。这组数字同时受任务、模型用量与计费条件影响,是官方评测结果,不能当成API每次调用固定收1.67美元。
Arena给出了另一类证据。首发时Qwen4-Max在Agent Arena模型榜列第14,阿里巴巴在实验室榜列第5,两者不是同一个排名。Code Arena WebDev为第6、1750分,较Qwen3.8-Max的1676分高74分;Image-to-WebDev也为第6、1674分,较1639分高35分。后两项分数均标注为初步成绩,说明它值得进入编程与看图建站的候选集,不能保证每个项目都优于别的模型。
发布博客展示了用Unreal Engine制作游戏、由二维布局构建三维产线、结合实验平台探索冷却液等案例。这些展示说明工具执行和反馈能进入任务过程;它们不等于各行业已有同等效果的规模部署,药物候选的计算结果也不等于完成临床验证。
拿同一项交付,比较效果和总花费
如果已有一个熟悉的项目,可以让新旧模型分别完成同一处页面修改,交回可运行结果,再记录完整任务的输入、缓存读取、思考与回答Token,以及人工返工量。这是本文建议的比较方式:把“每百万Token多少钱”和“交付一次要用多少Token”放在一起,才知道换模型是否合算。
功能边界也要先确认。QwenCloud模型页的Features列有Batches和Fine-tuning,但中英文“最新模型”文档明确写明Qwen4-Max暂不支持批量推理、模型调优或部署。当前不应按通用批处理五折来估算它的账单,应以具体模型文档和实际可用功能为准。正式按量入口让试验更容易开始,最终要比较的仍是完成同一件事花了多少钱、还需要改多少。