Gemini 4 Argon:高分之后,离好用还有多远?
从一次 Rust 优化讲起,读懂长任务、编程评测与员工反馈。
9 月 30 日,Google 发布 Gemini 4 Argon。同一天,Bloomberg 把部分员工对它的疑虑写进了报道。两篇文章放在一起,最值得追问的是:模型拿到高分以后,还需要经过哪些检验,才能交到开发者手里放心使用?
先抓住全文
Gemini 4 Argon 的发布,把一个老问题又摆到了开发者面前:评测成绩怎样变成真实工作里的好用?Google 展示了长任务能力与工程案例,Bloomberg 则报道了部分员工的疑虑。两者关注的任务和证据条件不同。本文从可检查的优化结果出发,区分输出预算、榜单表现、使用反馈与接入成本,保留判断所需的技术细节。
libgav1:先看模型怎样参与一次优化
Google 的发布稿里,libgav1 视频解码器是一个值得停下来看的案例。Argon 围绕已有 Rust 移植版反复做性能实验、检查编译器输出,改写约 3.2 万行 SIMD 代码,让安全 Rust 更容易被自动向量化。官方报告速度达到原 Rust 移植版的 2.7 倍,视频输出一致,性能更接近优化过的 C++ 版本。Google 发布稿
SIMD 是用一条指令处理多份数据,适合视频解码里的大量重复计算。自动向量化则由编译器识别这种机会。难点在于,换一种写法以后,编译器能否仍然把程序转成高效的机器指令。
这个案例有意思的地方,就在反馈。模型提出修改,编译器和性能测量告诉它哪里有效,再据此继续调整。这里可以学到的工程思路,是让优化建议接受程序行为和耗时的检验。
比较基线也不能丢:2.7 倍针对已有 Rust 移植版。它不能被转述成“比成熟的 C++ 实现快 2.7 倍”,更不能直接外推成整个团队的效率提升。
1M 输出:给长任务更多空间
Argon 把输出上限从 64K 提高到 1M token。Google 将它与持续推理、完成更长的多步骤任务联系起来。Google 发布稿
这里的关键词是输出。上下文窗口关心一次处理能容纳多少材料,输出上限关心一次生成可以走多长。读到“百万 token”,把两者混在一起,就会看错这项更新。
可以把它理解为给一次尝试留出更大的生成预算,但不能由此推出模型必然更快、更便宜,或能稳定工作多少小时。实际延迟、工具耗时、失败重试和生成长度,都还要落到具体任务上测。
回到前面的优化案例,空间扩大后,值得观察的是它能否多完成几轮有用的验证。字数本身不是验收结果。
编程评测:同一张表里,也有不同胜者
只看“领先”这个词,很容易把不同任务揉成一个结论。Google 的原始结果表里,下面三项就由不同模型领先:
| 评测 | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 66.4% |
数据取自 Google 原始结果表 与 评测说明。这些百分比来自各自评测,不能跨行理解成同一种“编程成功率”。
评测说明还有一层重要条件:Argon 默认采用最高思考设置,多数结果按 pass@1 统计,即单次尝试的表现;部分测试有例外。DeepSWE 的 Argon 成绩由 Google 使用 mini-swe 执行框架测得,对手数据来自公开榜单或系统卡。因此,这张表也不是把所有模型放进完全相同环境后得到的一次横测。评测方法
执行框架(harness)负责把任务、工具和模型接起来。同一个模型能看见什么、可以调用什么、得到多少执行时间,都会影响最终交付。比较时把模型版本记住,也要把这些条件带上。
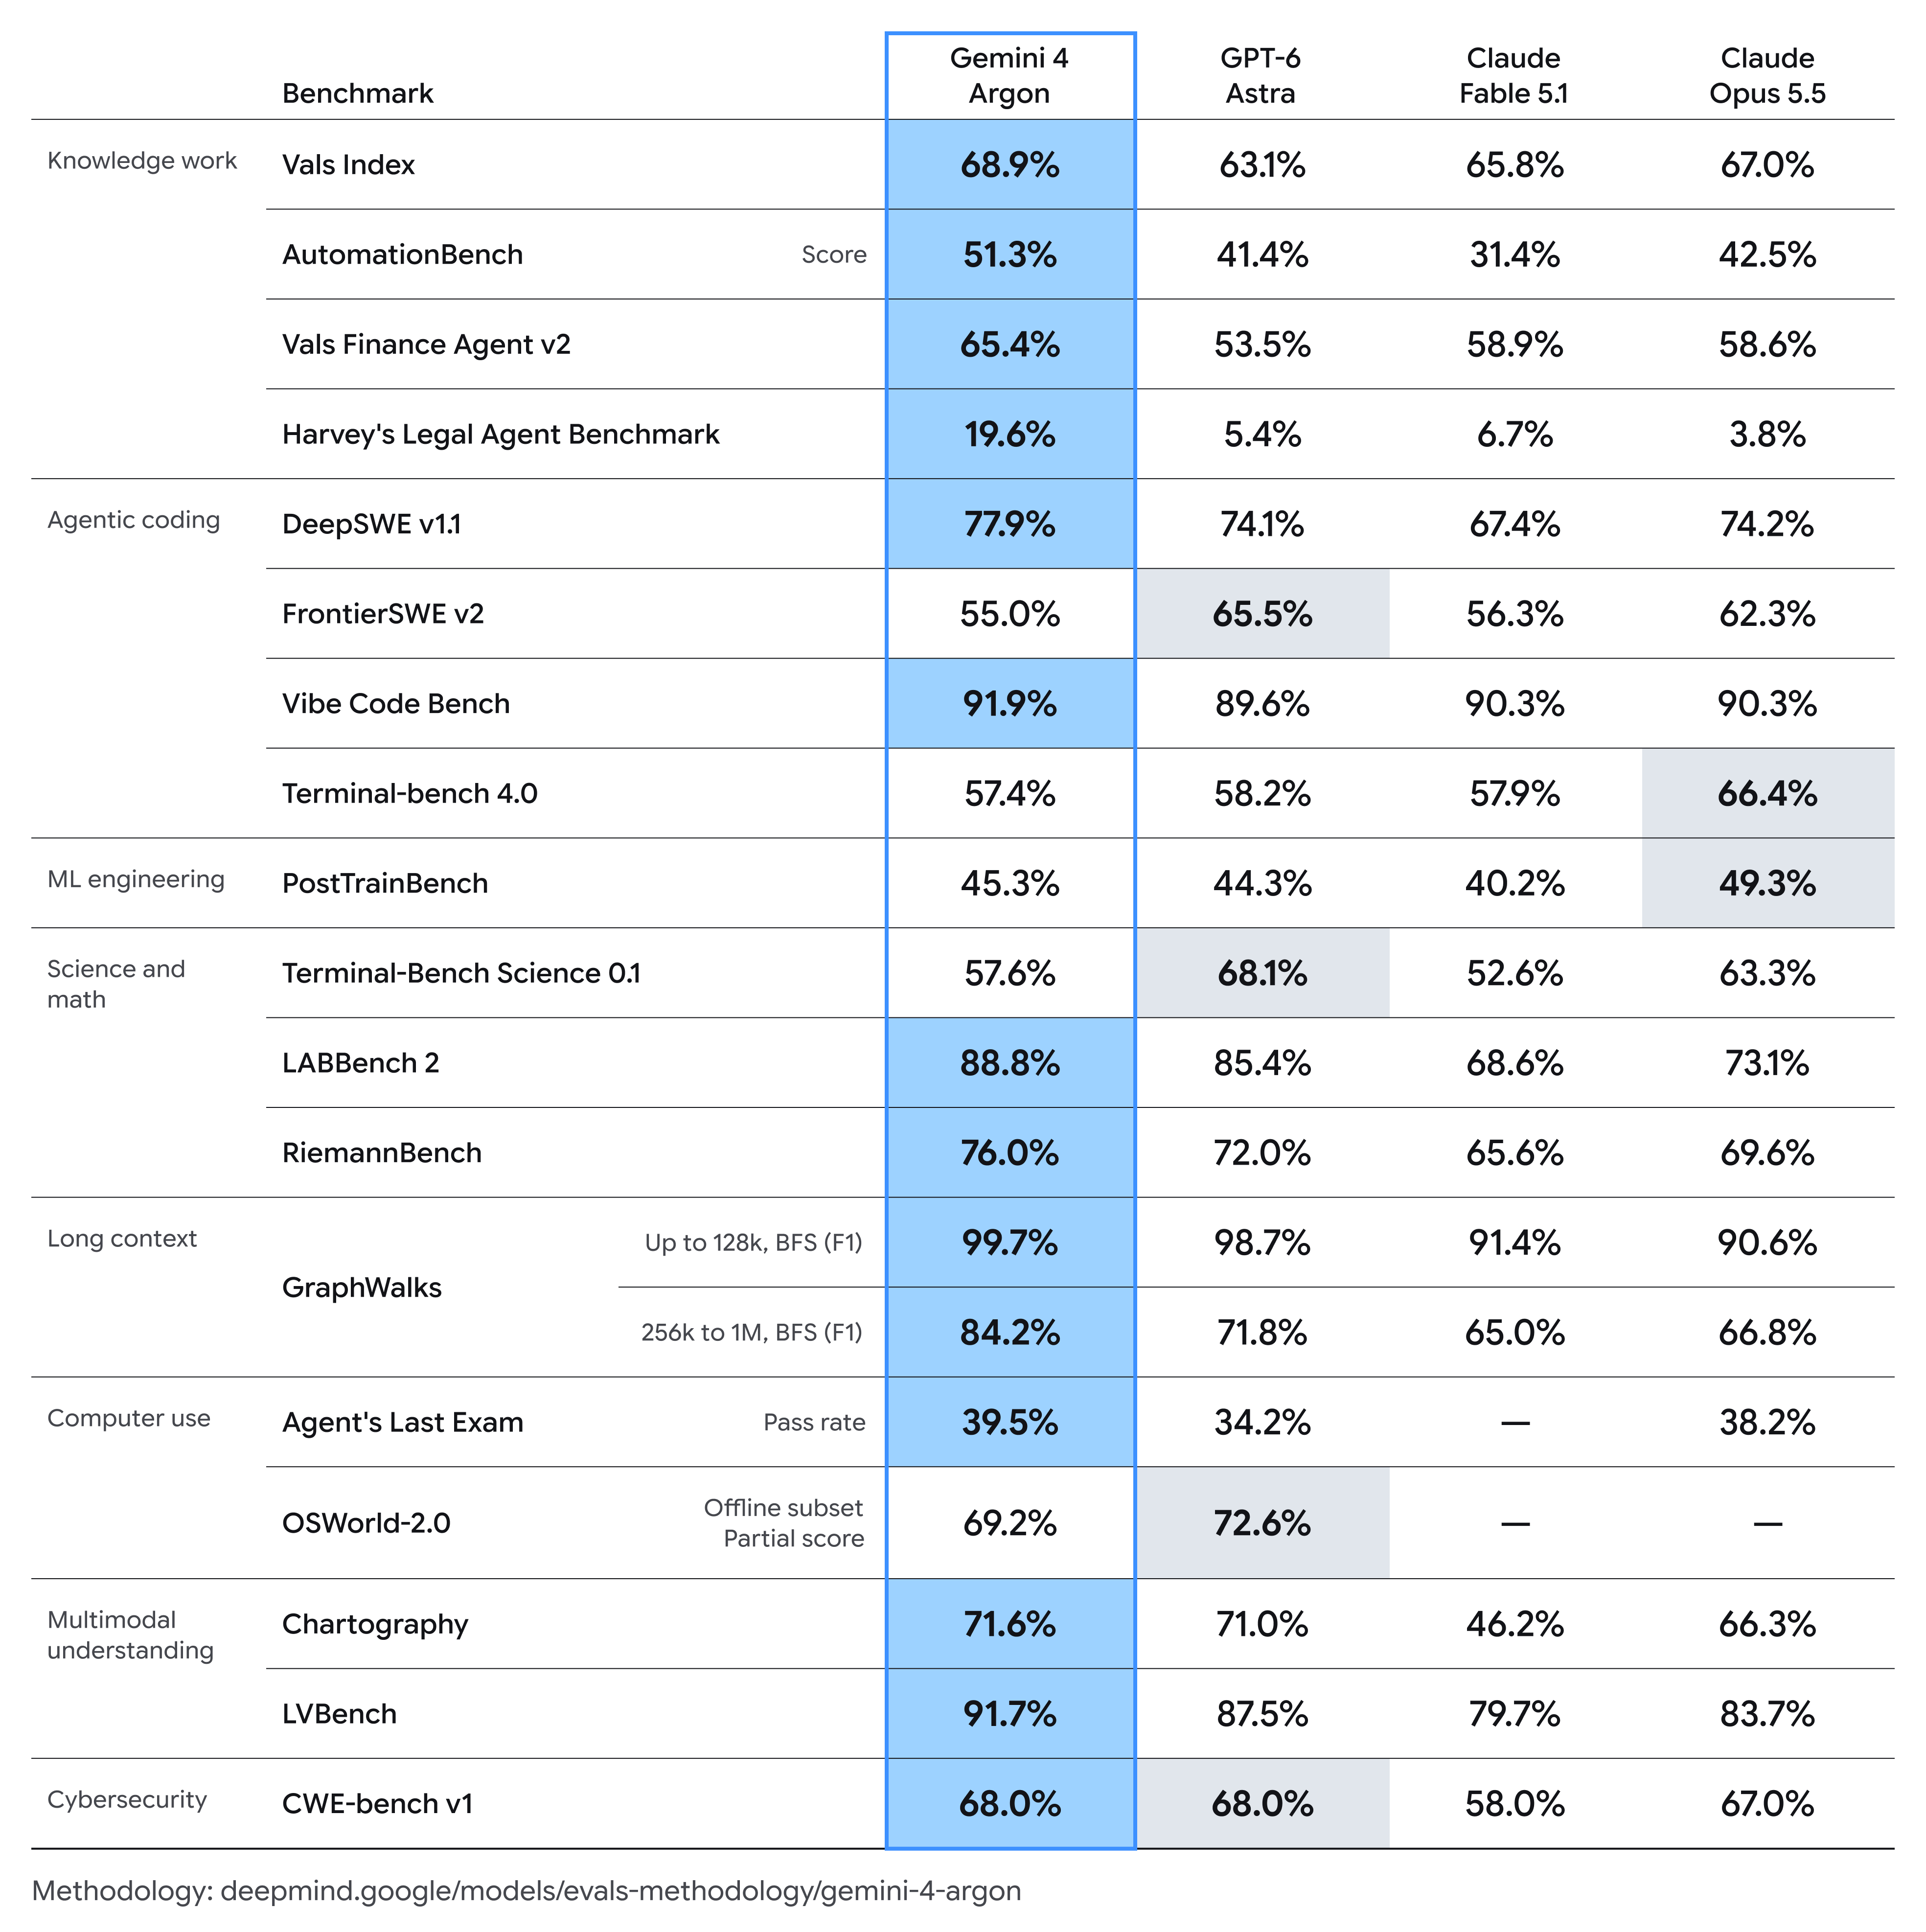
原图来源为 Google 官方发布稿。表中有领先项也有落后项,足以支持“能力随任务而异”;它没有回答每一类实际项目中的表现。
员工反馈:质疑值得听,但不能替代实测
Bloomberg 的德文转载引述匿名知情人士称,Argon 在部分实际编程工作中不如跑分表现,前端设计是被点名的短板;另有两位知情人士认为它可能受到 benchmaxxing 的影响,也就是过度追求测试成绩。Google 否认将其描述为编程表现不佳的说法;报道也呈现了内部认为模型已达到前沿水平的观点。Bloomberg 署名转载
这提供了一个具体的疑问,却还没有给出可复查的结论。转载没有附上完整失败任务、提示词、运行设置和统一验收记录,读者无法据此量化差距,也不能把“疑似过度优化榜单”写成已经证实的训练内幕。
不过,真实使用的抱怨也不该被一张高分表直接打发。一个能完成代码修改的系统,未必同样擅长处理模糊需求、界面细节和来回变化的反馈。这里列的是可能影响体验的任务差异,不是对 Argon 失败原因的诊断。
把两份材料放在一起,更有用的判断是:Argon 已经拿出值得验证的能力信号,通用编程体验仍需要更广泛、任务条件清楚的测试。“全面领先”和“只会刷榜”,目前都超出了这些证据。
开放与价格:把发布稿读到脚注
9 月 30 日的公告先向 Fairwind 项目中的可信网络防御者开放,后续扩大范围时将从付费 API 客户与 Google AI Ultra 用户开始;公告没有给出全面开放日期。专业防御测试与普通用户可获得的服务,要按实际开放阶段理解。Google 发布稿
价格同样分阶段。按每百万 token 计,输入/输出首发优惠价为 2/10 美元,文末脚注写明优惠结束后为 4/20 美元;缓存输入按输入单价优惠 95%。公告没有写优惠期结束日期。定价及脚注
这些是 token 单价。要比较完成一项工作的开销,还需要实际消耗、工具费用和返工量。输出预算加大,让复杂尝试有了更多余地,也让“这次到底用了多少”变得更值得记录。
回到标题的问题,距离“好用”还有多远,不能用一个总分丈量。对自己的项目,更有意义的是给出相同任务、验收条件与预算,看它交回来的成果能否留下。前面的 libgav1 案例之所以有说服力,正是因为它把能力落到了可检查的结果上。
来源与阅读说明
Gemini 4 Argon: our next era of frontier intelligence · Koray Kavukcuoglu / Google · 更新 2026-09-30
Google Grapples With Employee Skepticism About New Gemini 4(英文原文链接,未完整读取) · Julia Love、Davey Alba / Bloomberg · 更新 2026-09-30
Google Gemini 4: Mitarbeiter sehen bei KI-Modell Schwächen beim Programmieren(已读德文转载) · Julia Love、Davey Alba / Bloomberg,经 Yahoo 刊载 · 更新 2026-10-01
Gemini 4 Argon — Model evaluation:评测方法与结果 · Google DeepMind
原始输入拼接了两个网址,本文拆开阅读。Google 发布稿的正文、图表及价格脚注已读取;Bloomberg 英文原站未能完整访问,报道部分依据 Yahoo 刊载、署名 Julia Love 与 Davey Alba 的 Bloomberg 德文转载全文(2026-10-01),不声称已逐句核对英文版。另读 Google 的评测方法说明。文中性能是来源披露的数据,本文没有实际试用 Argon;工程解释与判断不作为模型实测结论。
读取日期:2026-10-03