摘要 全文按三件事展开:它在找资料、处理项目代码这些活上的成绩到底怎样,它是怎么练出连续干活的,国产加速卡上做了什么;最后是价格和怎么试。
11 月 1 日,美团的 LongCat 团队发布了 LongCat-2.5,主打长程智能体,也就是能连续干完一整件活的 AI,而不只是陪你聊天。官方成绩表拿 Claude 作对照:两边都有分数的 24 项里,它赢了 Opus 4.8 的 18 项,换成 Opus 5 只赢 27 项中的 10 项。这些成绩全部是美团自测,还没有第三方复测。
LongCat-2.5 是什么:在 2.0 的底子上,补了看图和干长活
LongCat 是美团的大模型系列。6 月 30 日发布的 LongCat-2.0 已经是 1.6 万亿总参数,权重按 MIT 协议开源在 GitHub 上。2.5 沿用同样的规模:总参数 1.6 万亿,每个 token(模型处理文字的基本单元)只激活约 480 亿参数,大约 3%。这种结构叫 MoE(混合专家,模型里有很多“专家”子网络,每次只叫醒其中一小部分),所以参数很多,单次计算量却小得多。参数规模不是这次的新闻。
新东西有两样。一是原生多模态:图片被切成一串离散的 token,和文字放进同一个模型里处理,官方说这让它在写网页、做设计和 3D 任务上更强。二是长程智能体:面向复杂代码库、从零搭一个完整项目这类要连续做很多步的任务。
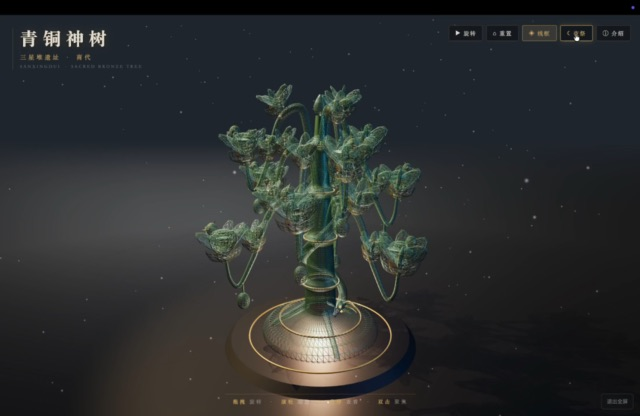
官方博客放了 8 个由它端到端完成的演示视频,一半是写软件,一半是办公。比如一个三星堆青铜神树的 3D 展示页:神树模型可以拖动旋转、滚轮缩放、双击聚焦,还能切换线框、打开文物介绍。这些是官方挑选的演示,不等于独立实测。
时间线上,9 月 25 日先上线了 LongCat-2.5-Preview 预览版,11 月 1 日官方博客发布正式版,API 平台的更新日志记在 11 月 2 日。
按活来看:找资料很强,写大项目还差一截
官方博客放了一张 31 项的成绩表,对手有 GPT-5.5、GPT-5.6-Sol、Claude Opus 4.8、Claude Opus 5、GLM-5.3、Kimi K3 和 DeepSeek-V4.1-Flash,开头还画了一组和 GPT、Claude 对比的柱状图。
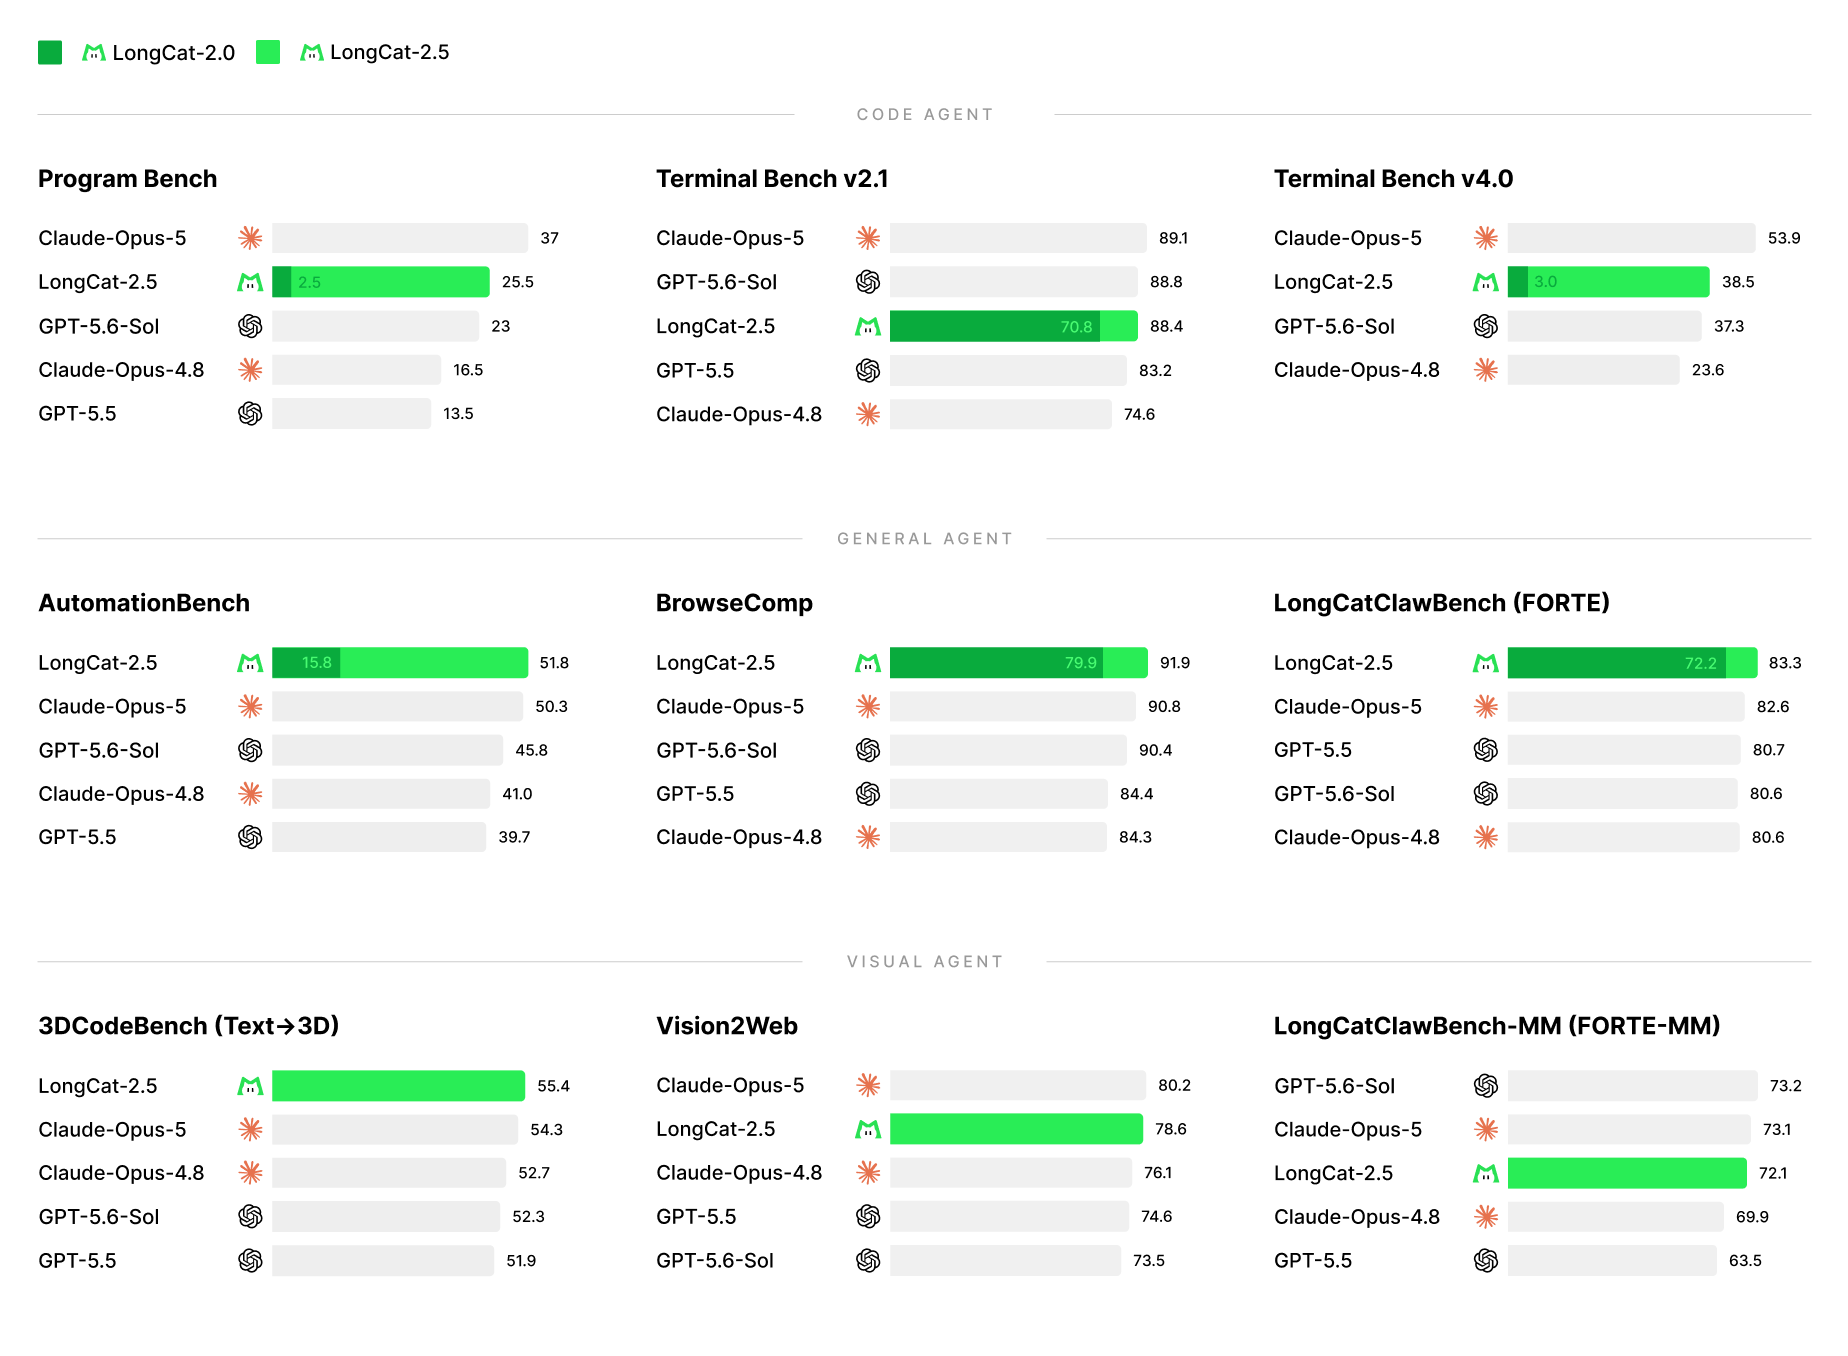
把这些分数放回具体的活里看,差别更清楚:
| 什么活 | 怎么测 | LongCat-2.5 | Opus 4.8 | Opus 5 |
|---|---|---|---|---|
| 找资料 | BrowseComp:上网找很难找到的信息 | 91.9 | 84.3 | 90.8 |
| 处理项目代码 | Terminal Bench v2.1:在命令行终端里完成真实任务 | 88.4 | 74.6 | 89.1 |
| 更难的代码活 | Terminal Bench v4.0:同类任务的新版,各家分数都低得多 | 38.5 | 23.6 | 53.9 |
上网找资料这类活,它的分数已经排在 Claude 前面;在命令行里处理项目代码,它明显好过 Opus 4.8,和 Opus 5 差不多;到了更难的新版测试,就落后 Opus 5 一大截,难度最高的编程任务是它目前的短板。完整胜负按两边都有分数的项来数是这样:
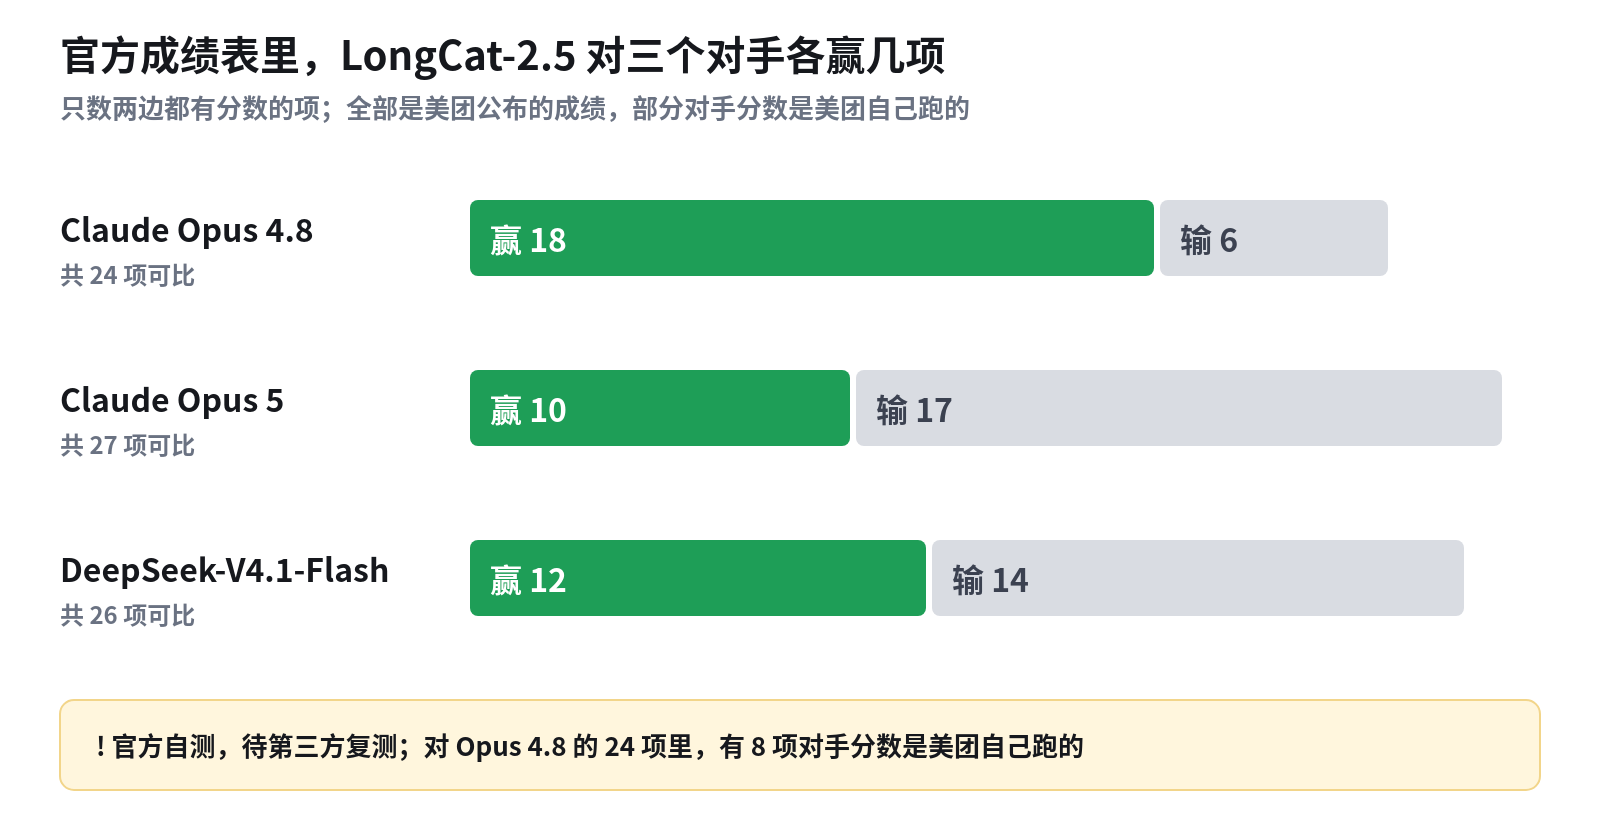
表里的国产对手 DeepSeek-V4.1-Flash,可比的 26 项里有 14 项比 LongCat-2.5 高。读这张表还要记住两个口径:对手分数不带星号的是美团自己跑的,官方注明仅供参考,对 Opus 4.8 的 24 项里有 8 项属于这种;另有三项是美团自己的评测。
怎么练连续干活:拿翻车记录当错题本
让模型一口气干完一个项目,难在中途任何一步走偏,后面就全白做。美团博客里最值得普通读者记住的一条做法是:把智能体在真实任务里翻车的过程收集起来,改成能复现、能自动判对错的训练题,持续补进训练里,专门练模型的短板,相当于给模型准备了一本错题本。
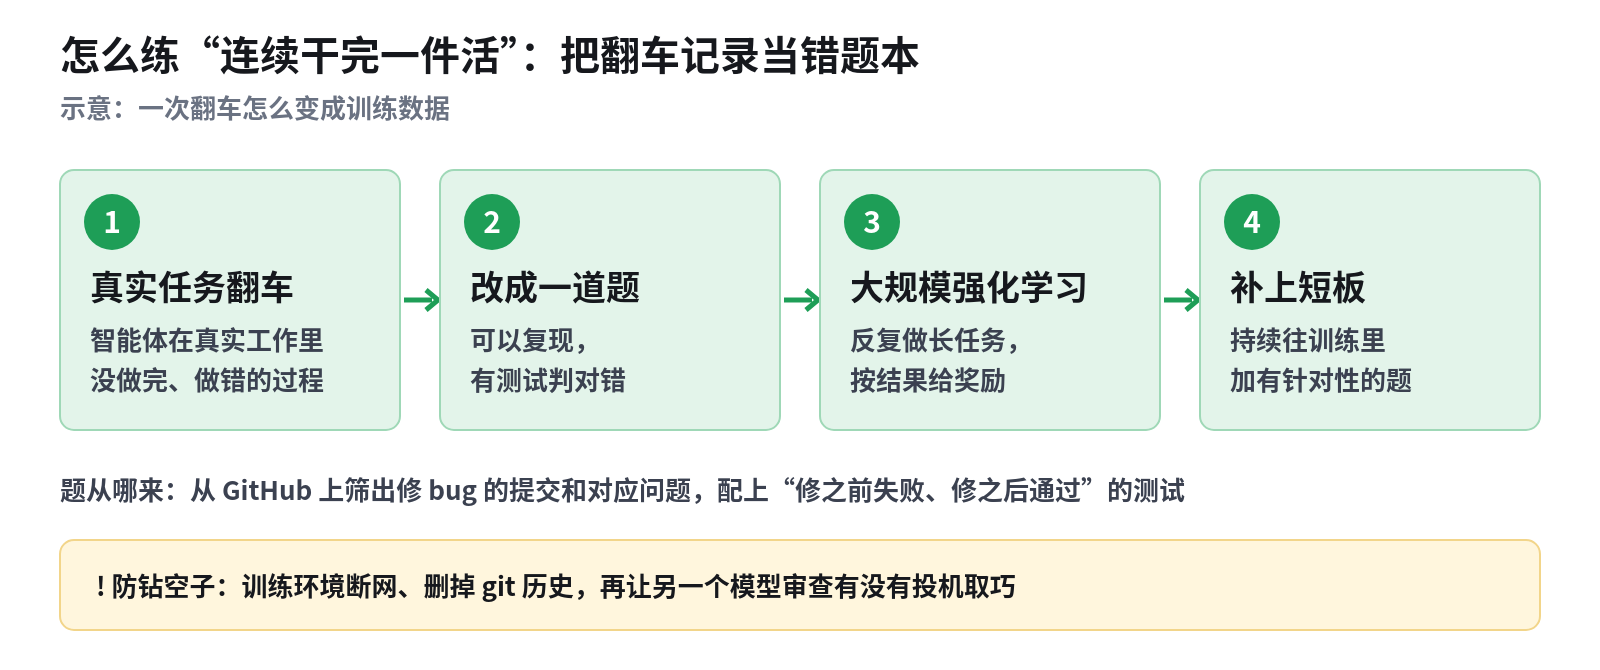
题的主要来源是 GitHub:筛出修 bug 的提交和对应的问题单,让智能体标注任务、搭好运行环境,再用两类测试验收,一类原来失败、修好后应该通过,一类原来就通过、修完不能被改坏。美团内部的真实编程任务也加了进来。接着是大规模强化学习(让模型反复做任务,按结果给奖励),每道题都是一整条长任务。
模型在训练里也会钻空子。美团的做法是训练环境断网、删掉 git 历史和缓存文件,不让它直接找现成答案,再让另一个大模型审查每条做题记录有没有投机取巧;对反复空想、重复调用同一个工具的行为额外扣分,防止回答越写越长。
练出来的效果,可以从官方的业务分析演示里看一眼:画面左边是它的工作记录,它自己跑命令,碰到页面报错就去看完整的错误信息,修完再核对渲染出了几个章节、几张图表,最后检查截图;右边是生成的经营分析报告网页。这同样是官方挑选的演示。
国产加速卡上做了哪两件事
官方博客写了两件放在国产 AI 加速卡上做的事,没写是哪家的卡。第一件是长上下文训练,用在中期训练和 SFT(监督微调,用示范数据教模型)阶段。每张卡的显存不到 80GB,而长序列很占显存,所以训练系统按超节点(用高速互联把多张卡连成一个整体)来切分模型和数据。官方给的结果是,长序列 SFT 任务里单卡吞吐比 DDP 基线(每张卡各存一份完整模型的常规做法)高 86%。
第二件是 W4A4 推理:模型权重和计算中的激活值都压成 4 比特,直接在卡上的 INT4 计算单元里算。和 8 比特的 W8A8 方案比,线上压测里预填充(先读完你输入的内容)和解码(逐个往外写 token)的吞吐都提高了四成多,延迟也有下降,细分数字见下图。官方称在评测过的下游任务上,精度和没压缩的模型相当。
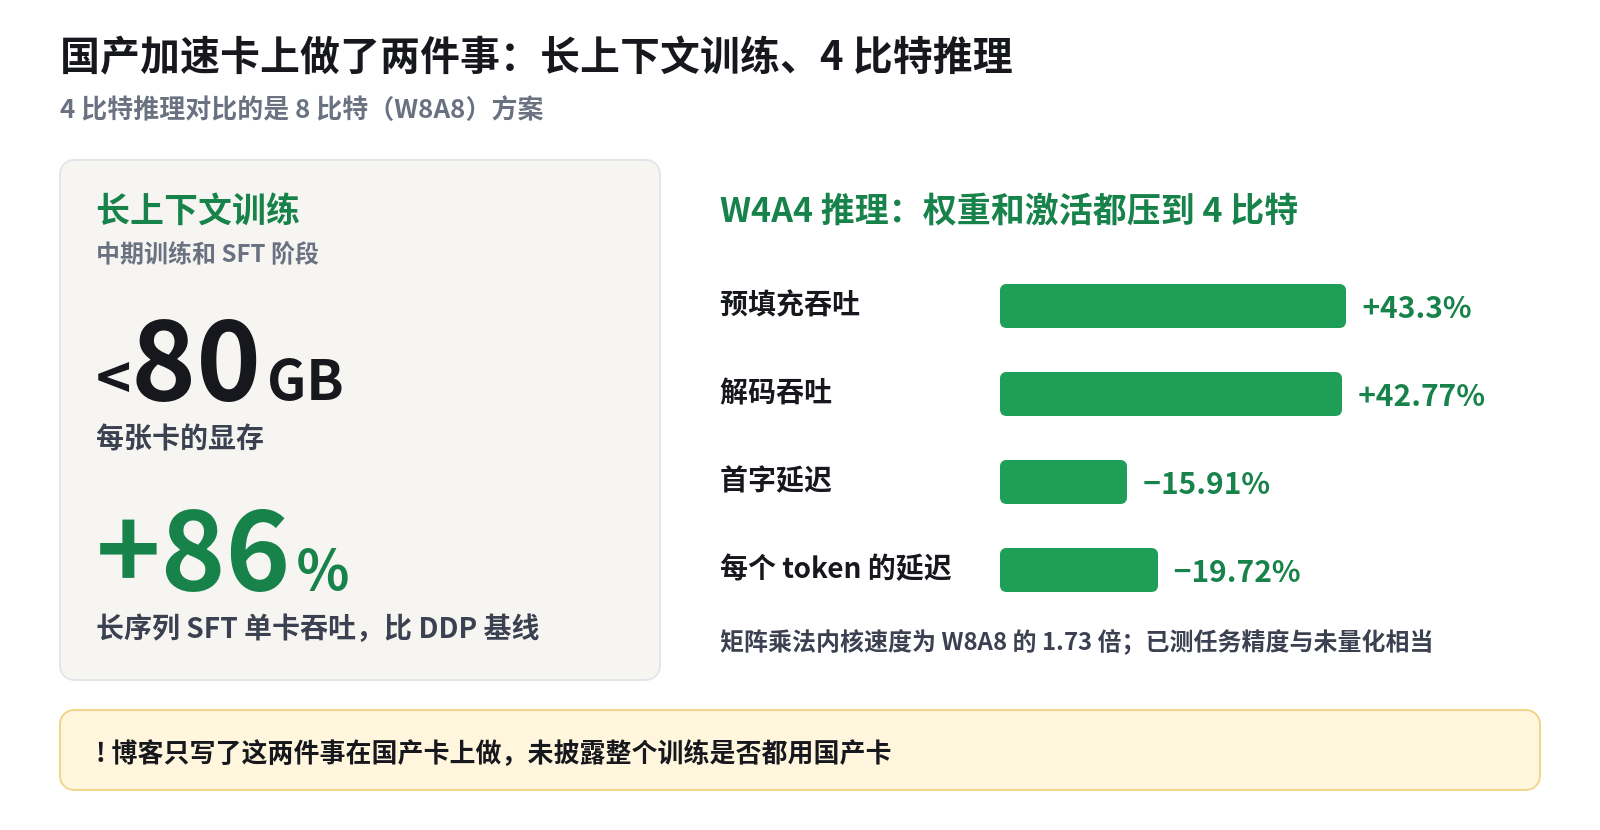
边界要说清:博客只说这两件事在国产卡上做了优化,没有说 LongCat-2.5 的整个训练都在国产卡上完成。
现在就能用:价格、接入和没开源的部分
LongCat-2.5 的 API 已经在美团的 LongCat API 平台上线,博客也附了在线试用入口。按官方定价页,现在是限时折扣价:每百万 token,未命中缓存的输入 0.3 美元(2 元),命中缓存的输入 0.006 美元(0.04 元),输出 1.2 美元(8 元);官方注明价格可能调整,以平台和账单为准。
开发者最关心能不能接进现有工具。更新日志写明它兼容 Claude Code、Codex、Hermes 等智能体工具,API 文档同时提供 OpenAI 风格的 Chat Completions、Responses 接口和 Anthropic Messages 接口。官方文档有一篇 Claude Code 接入指南,按指南把模型名设为 LongCat-2.5,再填上 LongCat 的接口地址和密钥,就能在 Claude Code 里用它。想判断它适不适合自己的工作,可以选同一个真实小项目,分别交给它和平时用的模型,比一比完成度和花费;这检验的是合不合用,官方跑分仍待第三方复测。
权重暂未开源。博客上 GitHub 和 Hugging Face 的入口写着 Coming soon,官方没给时间和协议;上一代 LongCat-2.0 的权重已按 MIT 协议开源。