摘要 水印藏在 Claude 选词的随机数里,不加字、不带身份信息。Claude 自己挑的词越多,水印越容易测到:翻译会带上,代码通常较少。目前只有获准的机构能检测,结果也只是一个可能性。
据 Anthropic 近日发给 API 客户的邮件,11 月 3 日起又有 4 款 Claude 旧模型写的字会带上隐形水印,8 月以后发布的新模型早就带着。用 Claude 写稿、做翻译、写代码的人,交出去的文字看上去和以前没有区别。获准使用检测接口的机构则可以拿 Anthropic 的密钥评估,这段字有多大可能是 Claude 参与写的,但水印里没有你是谁的信息。
哪些模型、从哪天起、在哪里生效
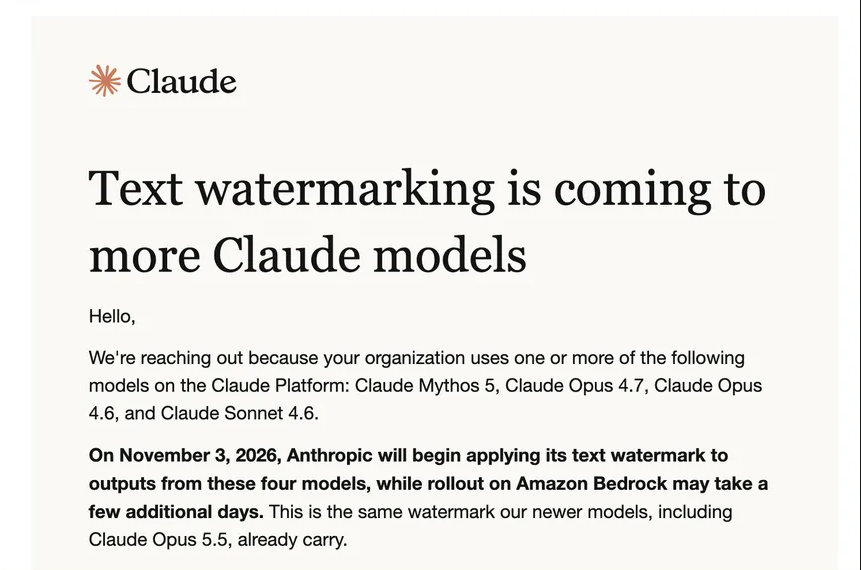
这次扩到的是 Claude Mythos 5、Opus 4.7、Opus 4.6 和 Sonnet 4.6,都是 8 月 2 日之前发布的旧模型。邮件写明,11 月 3 日起给这 4 个模型的输出加水印,Amazon Bedrock(亚马逊云上托管 Claude 的服务)可能晚几天,用的就是 Opus 5.5 等新模型已经带着的同一种水印。这个日期目前只见于邮件,Mashable、MACCUS 等多家媒体引用的都是这封邮件,Anthropic 官网没写。
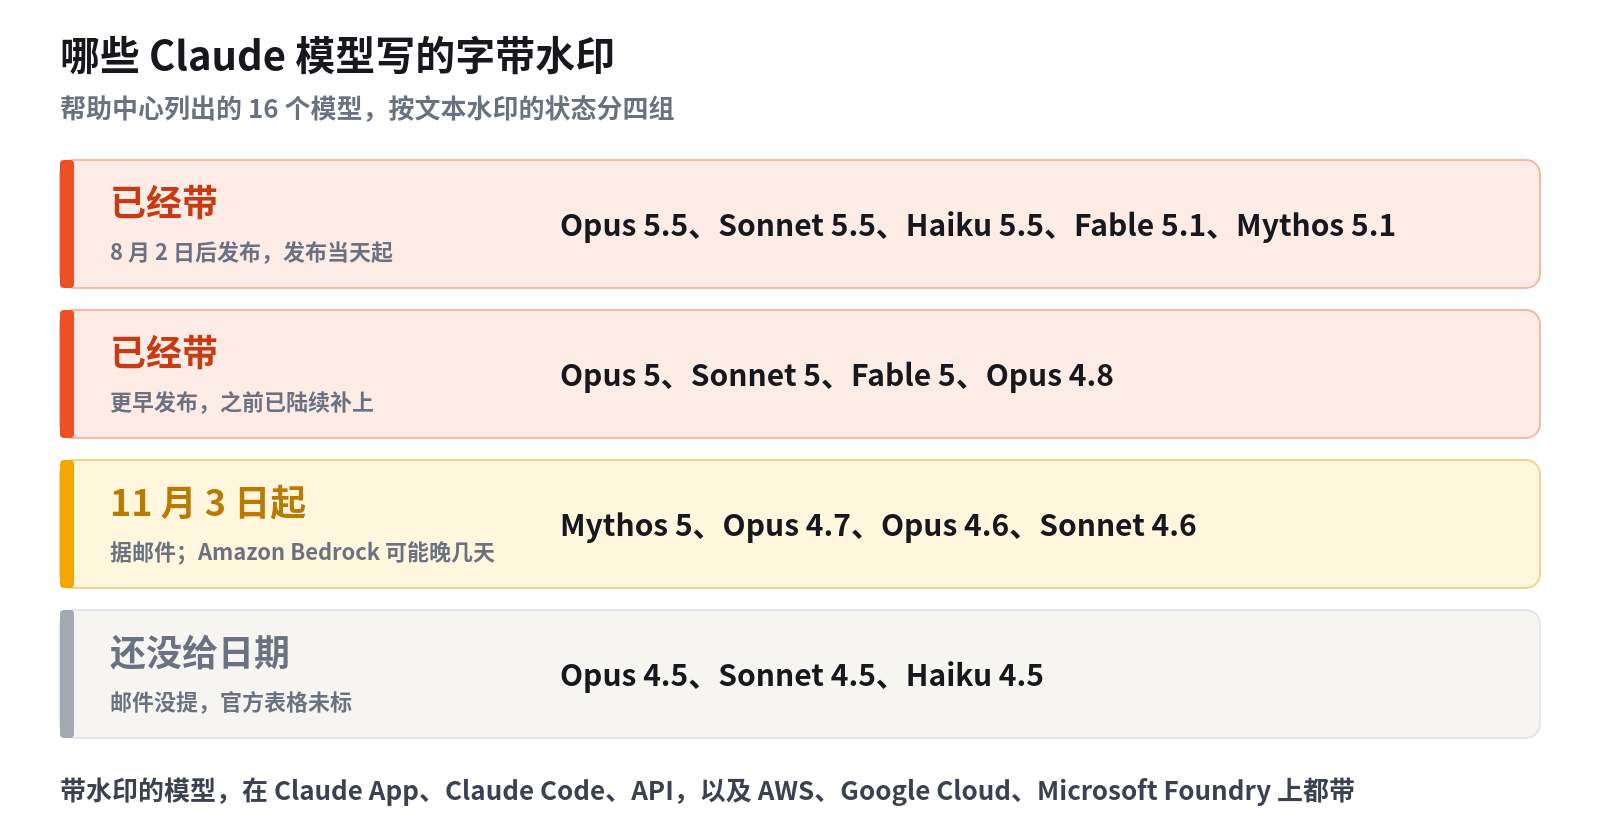
按帮助中心 11 月 2 日的模型表,16 个模型里已有 9 个带文本水印;加上这 4 个,只剩 Opus 4.5、Sonnet 4.5 和 Haiku 4.5 还没给日期。
为什么是现在?欧盟 AI 法案要求,8 月 2 日起服务欧盟市场的 AI 提供方给 AI 生成的内容打上机器能识别的标记。Anthropic 和其他几家大模型公司在 7 月签了欧盟同一份行为准则,各家都会有自己的水印。8 月 2 日前上市的旧模型有一段过渡期,欧盟委员会的问答写明,这类系统的标记义务从 2026 年 12 月 2 日起适用,11 月 3 日大约提前了一个月。
对中文读者最要紧的是两点。第一,水印全球生效,不只在欧盟:官方的理由是还没有可靠的办法按地区区分。第二,水印加在模型层面,Claude App、Claude Code、API,以及 AWS、Google Cloud、Microsoft Foundry 上的同一模型都带,复制粘贴到别处也跟着走。据 The Decoder,客户不能关闭;帮助中心和官方文章也没有提供关闭选项。不过同一篇报道引述邮件说,在 Opus 4.6 和 Sonnet 4.6 上,只有 temperature、top_p、top_k 三个采样参数(开发者用来调模型选词有多随机的设置)都保持默认时才加水印,改动任意一个就不加,靠水印来满足自身合规要求的客户要把这几项保持默认。这一段目前只有 The Decoder 引述,公开的邮件截图里没有。
水印藏在哪:选词时的随机数
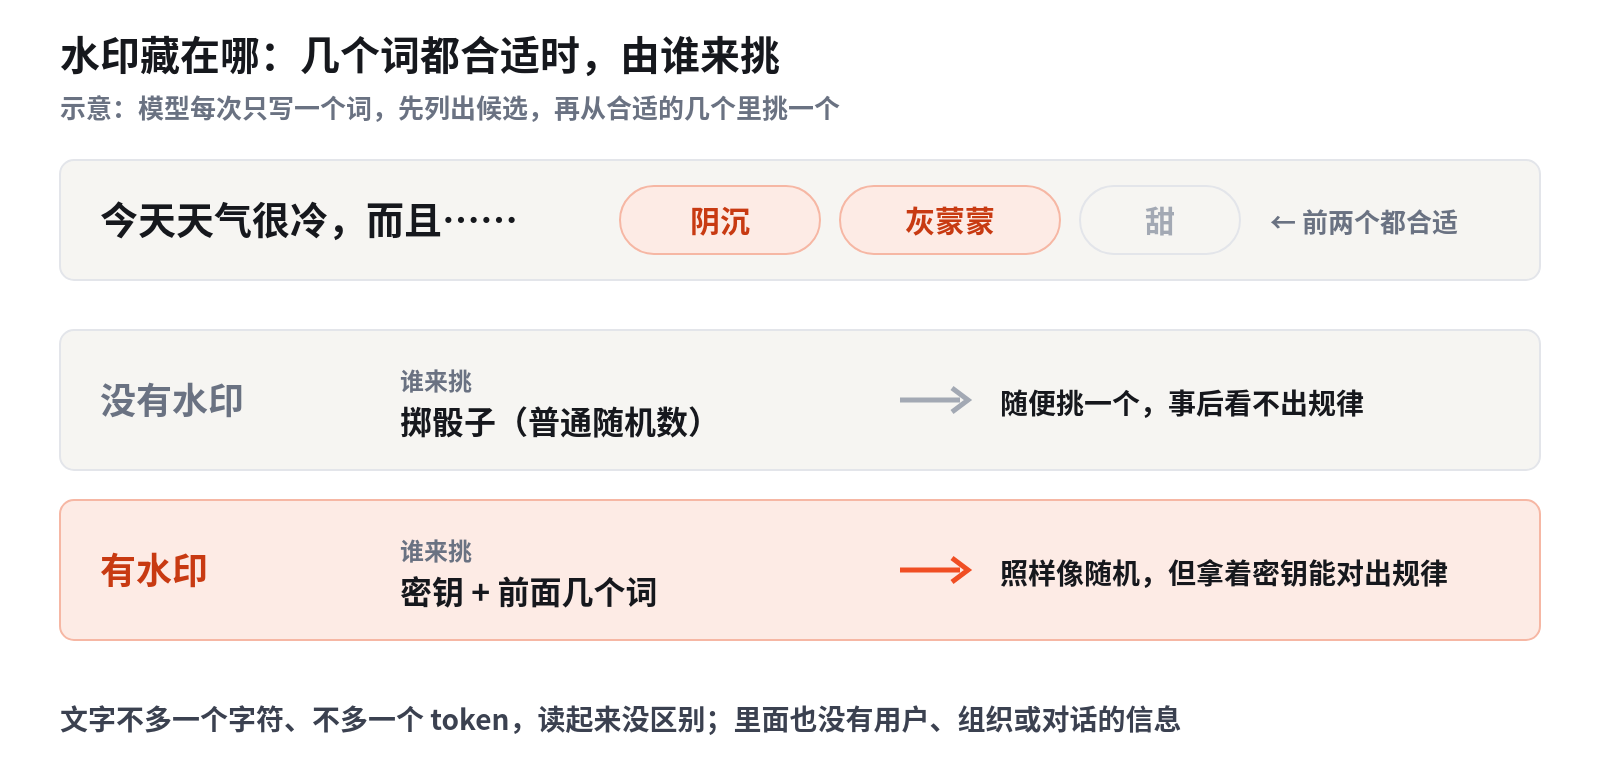
大模型写字是一个词一个词往外蹦的。每写下一个词,模型先列出一串候选,再挑最通顺的那个。官方举的例子是“今天天气很冷,而且……”,下一个词几乎不可能是“甜”,但“阴沉”和“灰蒙蒙”都很合适,选哪个对读者来说意思差不多。这种时候,最后由一个随机数来定。
水印用的就是这类无关紧要的选择。加了水印以后,模型照样随机挑,只是随机数的来源换了:不再用普通的随机数生成器,而是用 Anthropic 的密钥加上前面几个词来决定挑哪个。读者看不出任何区别;拿着密钥的人把整段文字逐词对一遍,看它跟“用密钥挑词”的结果吻合到什么程度,就能算出这段字由 Claude 生成的可能性。
官方自己打了个比方:玩大富翁时,不掷骰子,改成照着一本圆周率的数字表往下走,从中间某一位开始,每人轮到时就用下一位数字当点数。对玩家来说照样是随机的,输赢也不受影响;但赛后如果能看到全部走法、又知道圆周率,就能判断这局多半是照着圆周率走的。水印就是那本数字表。
所以文字里不多一个字符,没有隐藏字符,也不多耗 token(模型计费和计量的文字单位),不增加费用;按官方的说法,对速度的影响可以忽略。水印里不带任何身份信息,追溯不到具体的人、组织或对话。它也不会让 Claude 偏爱某个词,更不会让它去挑平时根本不用的生僻词。
这套方法有来历:官方写明,用的是 Google DeepMind 2024 年发在 Nature 上的 SynthID-Text 方法的一个版本,这类做法可以追溯到计算机科学家 Scott Aaronson 2022 年的提案。质量方面,据官方介绍,内部测试没看到影响;SynthID-Text 的论文里,DeepMind 把带水印的模型放到一部分 Gemini 流量上,用户点赞和点踩的比例和不带水印的没有统计上的差别。也有人不同意,据 The Decoder 介绍,博主 John Gruber 认为没有两个同义词意思完全一样,按密钥而不是按语义挑词,难免损失一点精确。
翻译会带水印,代码通常较少
水印只能落在 Claude 自己挑的词上,Claude 替你选的词越多,可供检测的地方就越多。
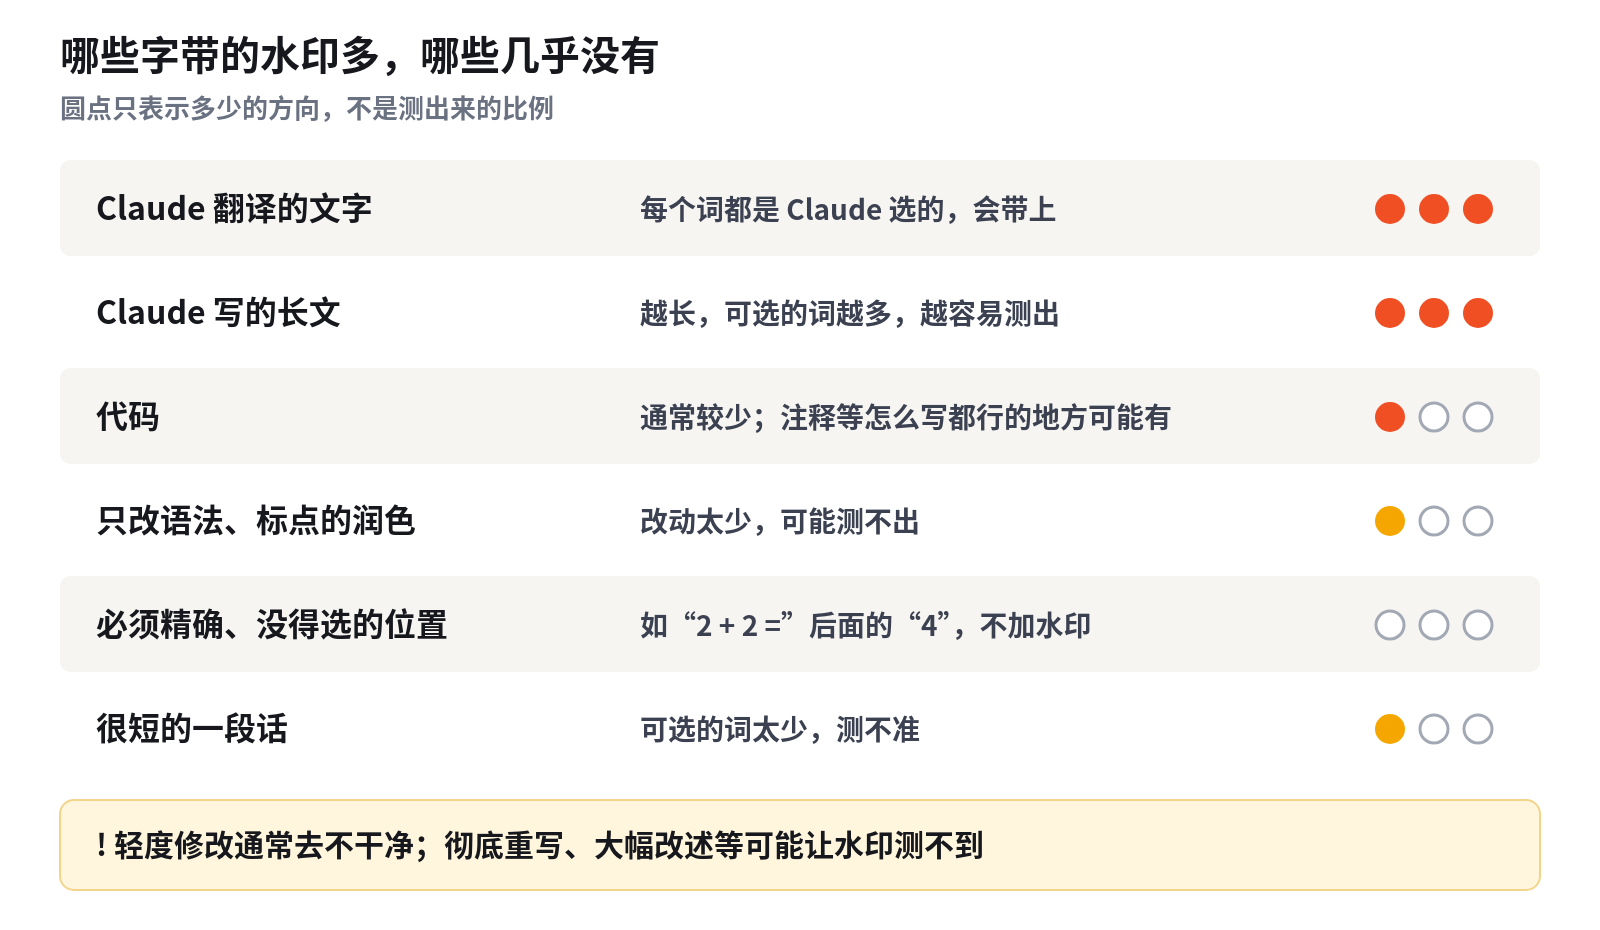
翻译会带水印,因为每个词都是 Claude 选的。长文同理,篇幅越长,检测越有把握;反过来,很短的一段话测不准。
代码通常较少。官方的说法是,必须精确、换个词就会算错或跑不起来的地方不加水印,就像“2 + 2 =”后面只能是“4”;代码里也有怎么写都行的地方,比如注释,水印可以落在那里。官方的结论是水印对代码本身的影响可以忽略,并没有说代码测不出来。事实性内容也一样,答案唯一的地方没有水印。
让 Claude 只改语法和标点的润色,几乎所有词都还是你自己的,水印只能落在那几处改动上,可能少到测不出来。改动能不能去掉水印?官方的说法是,轻度修改大概去不干净,把每个词都换掉的彻底重写可以去掉。这不是唯一的情况,帮助中心还列了几种可能测不到的:大幅编辑、改述、再翻译成别的语言,或者混进别的文字。
谁能检测,测出来能说明什么
检测文本水印的接口目前是私有预览。按欧盟法律的要求,只开放给监管机构、执法部门、媒体、事实核查机构、独立研究者、教育机构和欧盟的民间团体,以及同样要为合规核验水印的企业。官方说以后会逐步扩大范围,但没给时间,普通人暂时没法自己测。
它和网上常见的“AI 检测器”不是一回事。官方专门拿 Pangram 这类软件做了对比:它们没有 Anthropic 的密钥,靠的是 AI 文字的写法特征,比如官方举的例子,AI 很爱用“这不是 X,而是 Y”这种句式,“悄悄”(quietly)也用得比你想象的多。水印检测查的是密钥留下的规律,和看文风是两种方法。
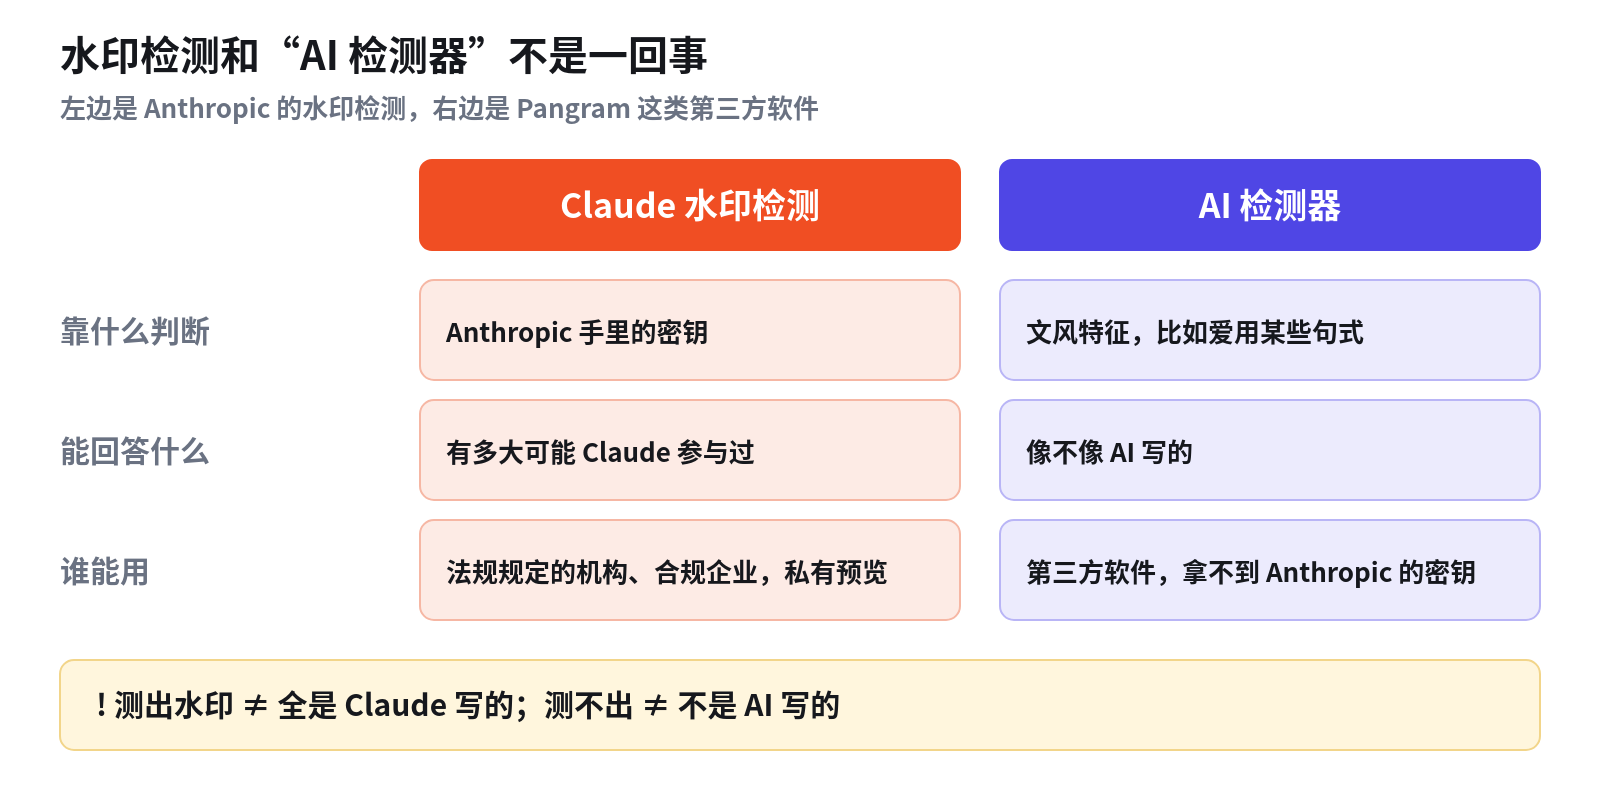
获准使用接口的机构能做的,是评估 Claude 参与的可能性。它只能回答“这段字有多大可能是 Claude 参与写的”,分不清是 Claude 写的还是 Claude 大改的,也判断不了是不是人写的、是不是别家 AI 写的。模型加水印之前生成的、改得很多的、太短的,都可能测不出。测不出,也不等于不是 AI 写的。
Claude 生成的图片等文件另有一套做法,叫 C2PA 内容凭证,是写在文件元数据里的一小段签名说明,不改文件内容,官方提供免费工具查看。官方还说明,水印不改变输出归谁所有、谁承担法律责任,也不影响用户在服务条款下的权利。
对日常用 Claude 的人意味着什么
社交平台上有人把这件事说成 Claude 要开始告密。其实水印里没有你是谁、在哪个组织、聊过什么,它只反映这些词是不是 Claude 挑的。真正的变化是,用 Claude 写出来的长文和翻译稿看上去和以前一样,但获准的机构可以评估 Claude 参与的可能性,轻度修改通常去不干净。
按用法分开看:
- 写稿、做翻译:学校、客户或媒体有 AI 使用规定的,按规定说明,不要指望水印测不出来。
- 写代码:必须精确的代码不加水印,注释这类怎么写都行的地方可能有。
- 用 API 做合规的企业:据 The Decoder 引述的邮件,Opus 4.6、Sonnet 4.6 上要把 temperature、top_p、top_k 保持默认,改了就不加水印。
- 在 Amazon Bedrock 上用这 4 个模型:可能比 11 月 3 日晚几天生效。