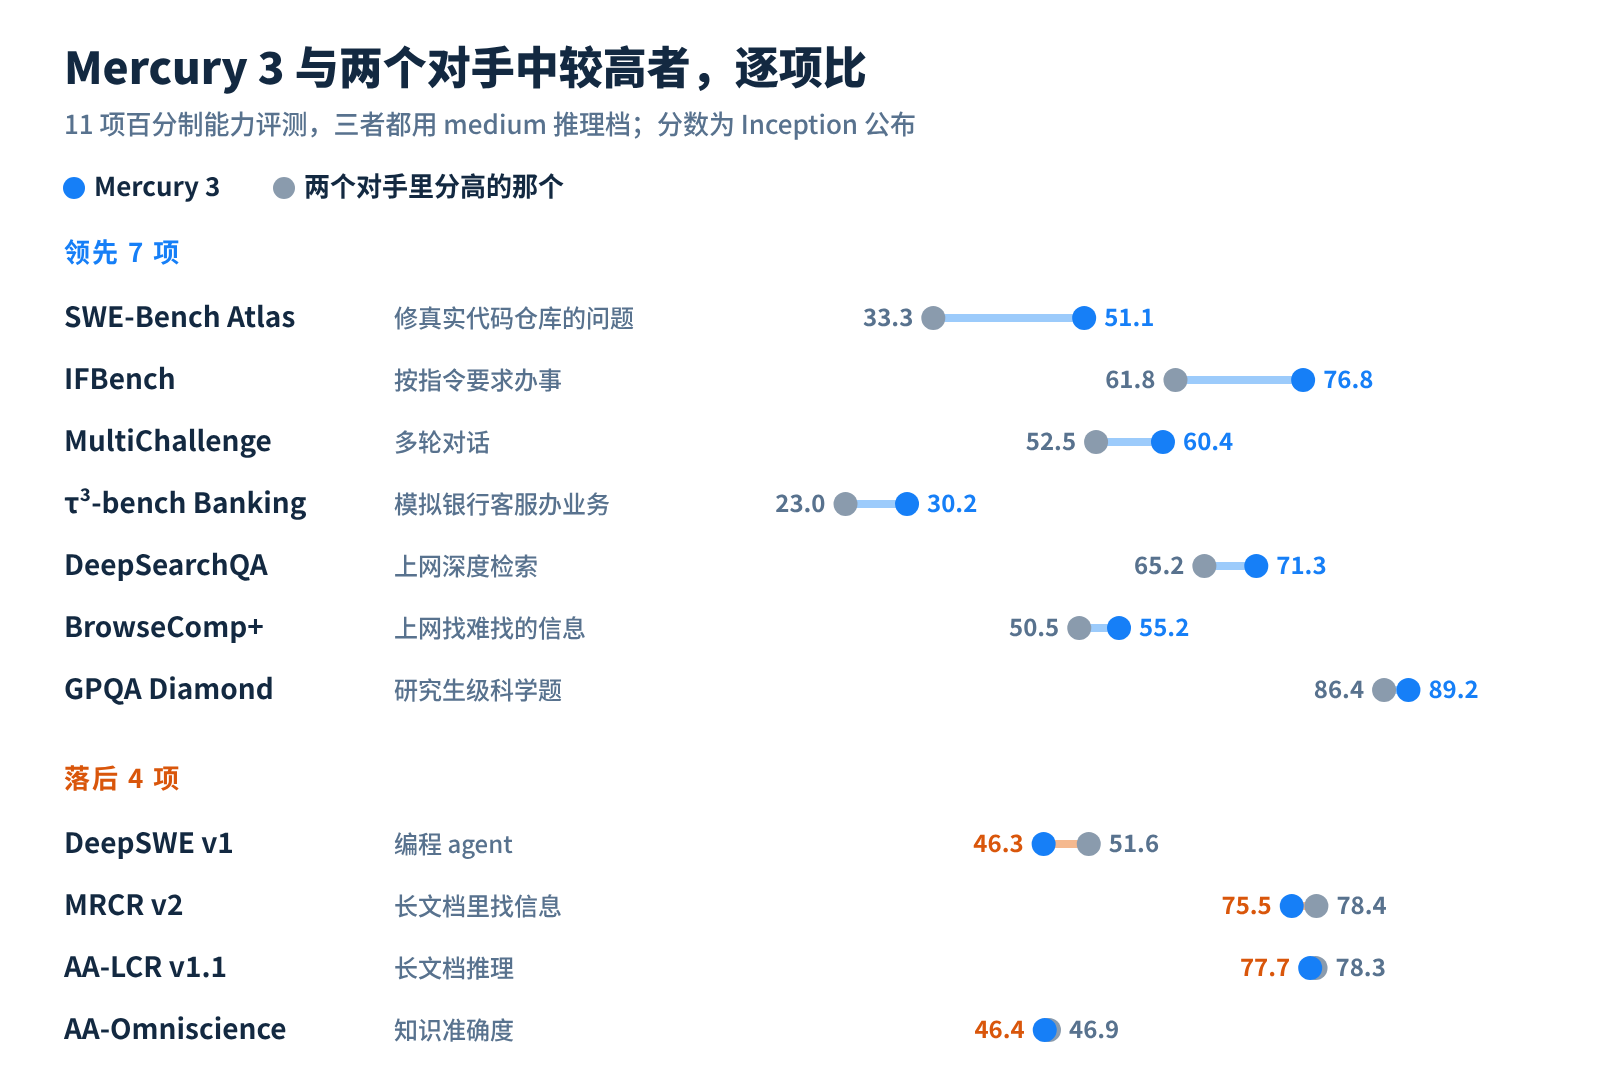
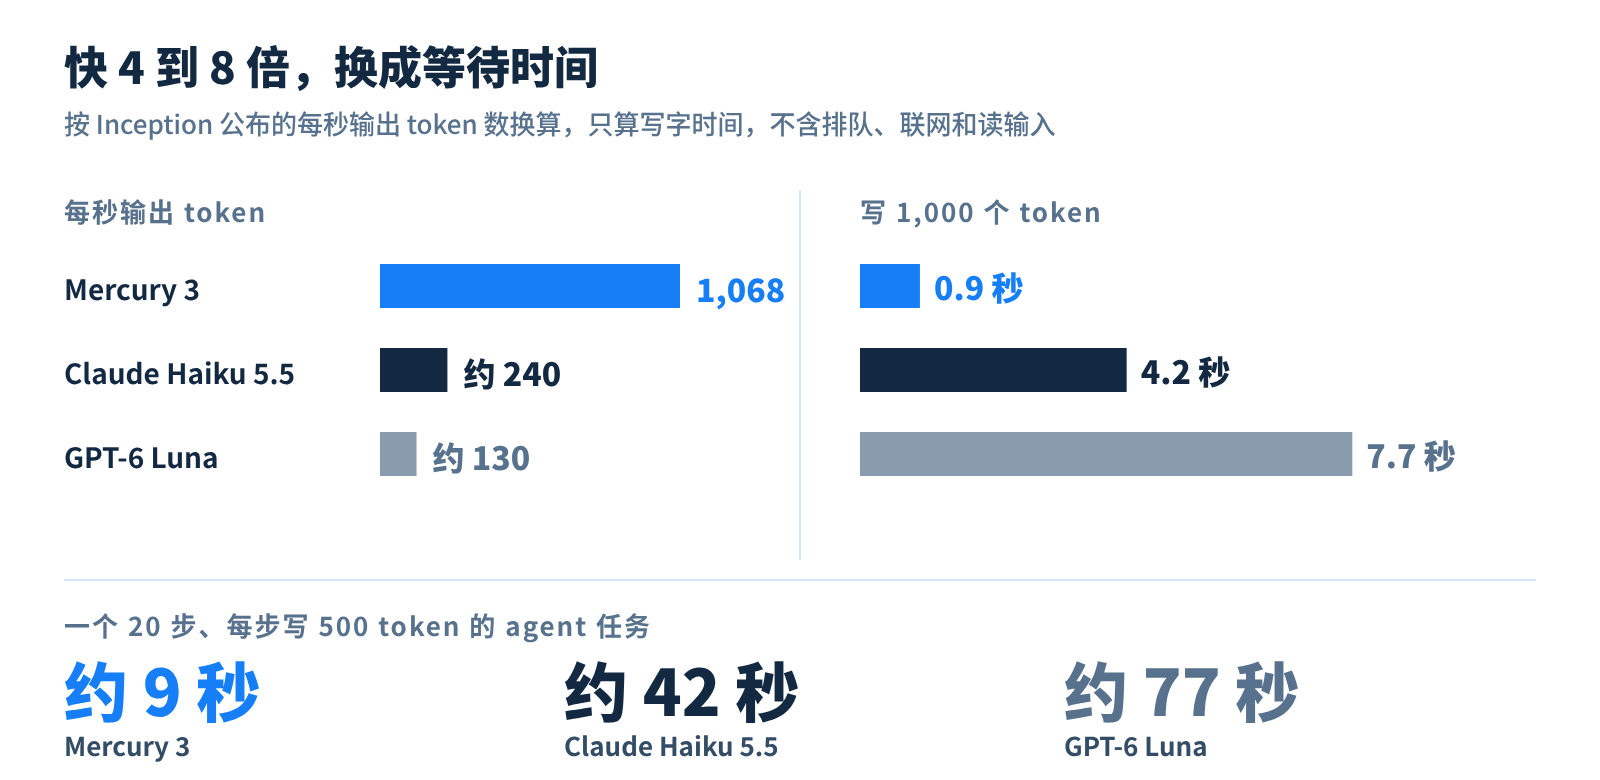
摘要 Inception 10 月 19 日发布 Mercury 3。它是扩散语言模型:不像主流大模型那样一个 token 接一个 token 地写,而是先铺满整段草稿,再多轮同时修改。它的参数是初代的 40 多倍,官方测得每秒输出 1,068 个 token,约为 GPT-6 Luna 的 8 倍、Claude Haiku 5.5 的 4 倍多;12 项能力评测里 8 项是三者最高,输在长文档检索和 DeepSWE 编程。成绩表里的价格是首发五折价。成绩都是厂商自测,上一代的第三方综合分明显低于官方的对标对象。
用 ChatGPT 时,回答是一个字一个字冒出来的。这不是界面动画,今天的主流大模型就是这样写的:每次只算出下一个 token(模型读写文字的计量单位,也是按量计费的单位),接上,再算下一个。10 月 19 日,美国公司 Inception 发布的 Mercury 3 换了一种写法,它把 AI 画图用的扩散方法搬来写字。官方测得它每秒输出 1,068 个 token,而它对标的 GPT-6 Luna 约 130 个。
这条路线以前有个悬而未决的问题:扩散语言模型做大以后,还能不能又快又聪明。Mercury 3 是 Inception 交出的答卷。下面先讲它怎么写字、为什么快,再看成绩、价格,以及这些数字该信几分。
扩散语言模型怎么写字:先铺满草稿,再一遍遍改
主流大模型叫自回归模型(autoregressive),每次根据已经写好的部分预测下一个 token。写 500 个 token 的回答,就要把整个模型从头到尾跑 500 遍,后一个必须等前一个写完。每跑一遍,GPU 都要把模型的全部参数(模型里可调的数字,数量常用来衡量模型大小)从显存搬到计算单元,真正计算的时间不多,大部分时间在等数据。
扩散模型(diffusion model)来自 AI 画图。Stable Diffusion 这类模型从一张满是噪点的图出发,每一轮把整张图的噪点去掉一些,若干轮后得到清晰的画面。Mercury 把同样的思路用在文字上。按 Inception 的技术报告,它从随机噪声出发,每一轮并行修改整段输出,逐步变成通顺的文字;模型主体仍是今天大模型通用的 Transformer 结构,只是训练它一次预测多个位置。这种模型叫扩散语言模型,简称 dLLM。Inception 自己打的比方是:少一点打字机,多一点同时改整篇草稿的编辑。
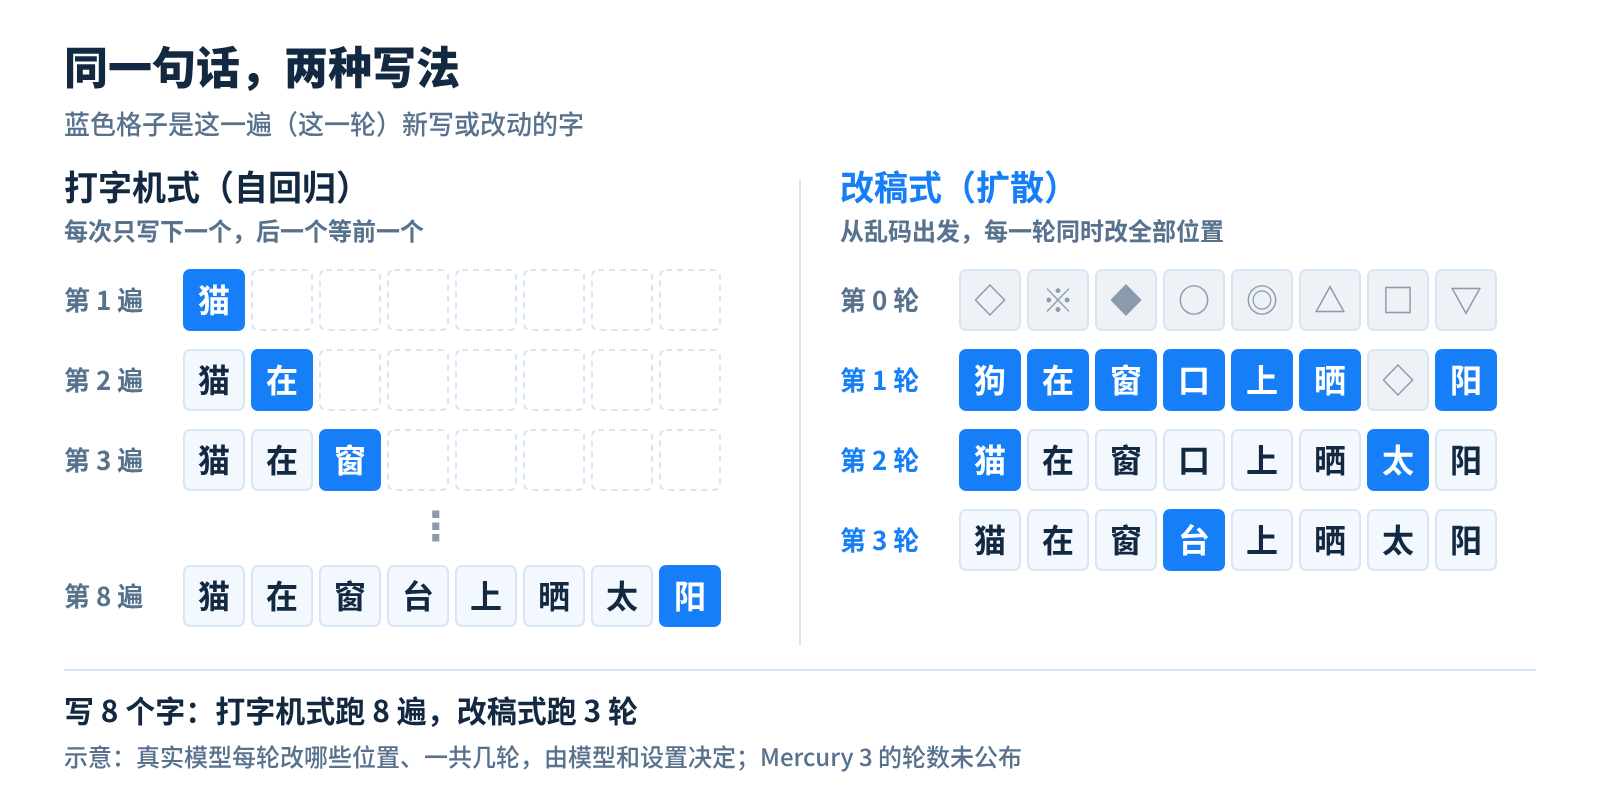
快就快在遍数上。改稿式每一轮同时处理所有位置,GPU 的算力被用满,不再闲着等搬数据,几轮就能收敛。代价是每一轮的计算量比打字机式的一步大,所以到底快多少取决于要改几轮,Inception 只说“少数几轮”,没有公布 Mercury 3 的具体轮数。
Inception 由斯坦福大学教授 Stefano Ermon 等学者创办,Ermon 是图像扩散模型奠基论文的作者之一。2025 年 2 月公司推出初代 Mercury,称它是第一个可商用的扩散语言模型。当时 AI 圈的疑问是,这种模型能不能像自回归模型那样,越做越大、越做越聪明。
扩散模型能做大吗:参数大了 40 多倍,速度没掉
Inception 的回答是能,证据是下面这张五代 Mercury 的对比图。横轴是参数总量,以初代最小的 Mercury 1 mini 为 1 倍,用对数刻度;纵轴是 Inception 选的 11 项评测的平均分。
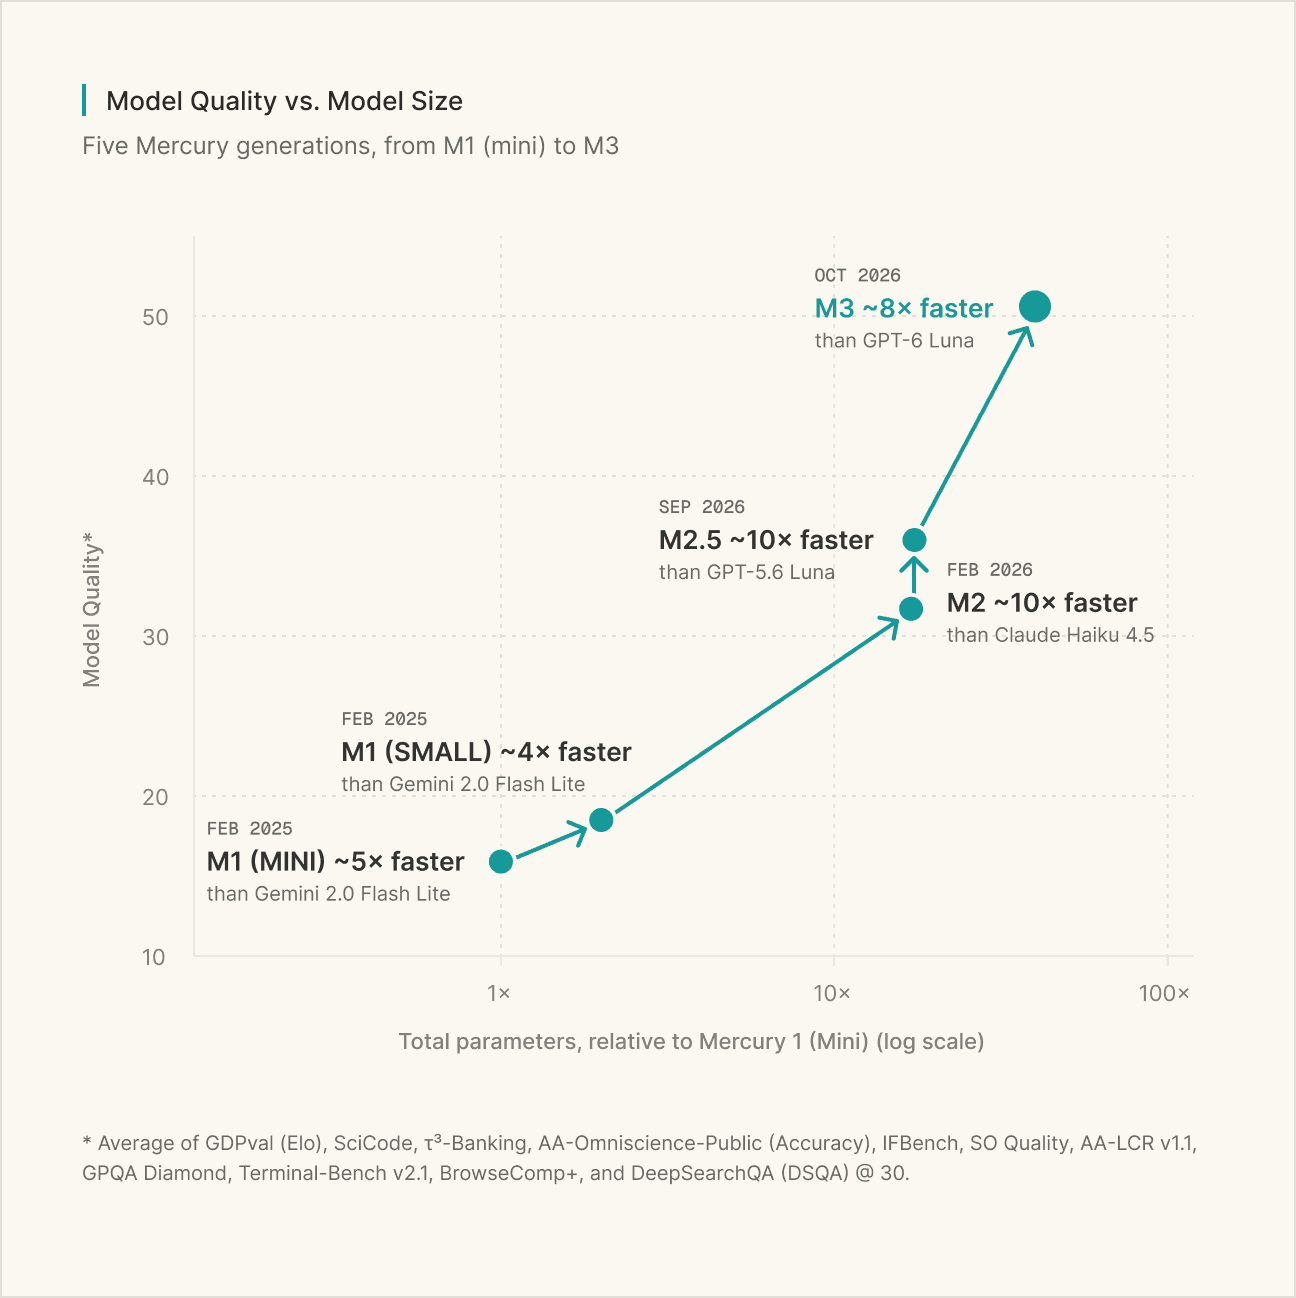
从初代 mini 到 Mercury 3,参数涨了 40 多倍,平均分从约 16 涨到约 50(图上估读),就是官方说的“聪明了 3 倍”。图上还有两个细节:Mercury 2 到 2.5 参数几乎没变,分数仍在涨,说明训练方法也在进步;速度一直在每秒 1,000 个 token 上下,初代 mini 是第三方测得的约 1,109,Mercury 3 是官方测的 1,068。Inception 据此下结论:推动自回归模型进步的规模定律(scaling laws,模型越大、训练数据越多,能力按可预测的规律变强),对扩散模型同样成立。
读这张图要记住两点口径:平均分是 Inception 自选的评测组合;每代“快几倍”的比较对象都不一样,初代比的是 Gemini 2.0 Flash Lite,Mercury 3 比的是 GPT-6 Luna。另外,Mercury 3 的上下文(模型一次能读进的全部文字)从 2.5 的 26 万 token 提到了 100 万 token。
对 GPT-6 Luna、Claude Haiku 5.5:12 项能力评测赢 8 项
Mercury 3 选的对手是两款速度型模型:OpenAI 9 月发布的 GPT-6 Luna 和 Anthropic 10 月发布的 Claude Haiku 5.5。它们是各家旗舰之下主打便宜、快的型号,不是最强的那一档。三者都用 medium 推理档比较,推理档决定模型回答前先“想”多久,三家都可以调。
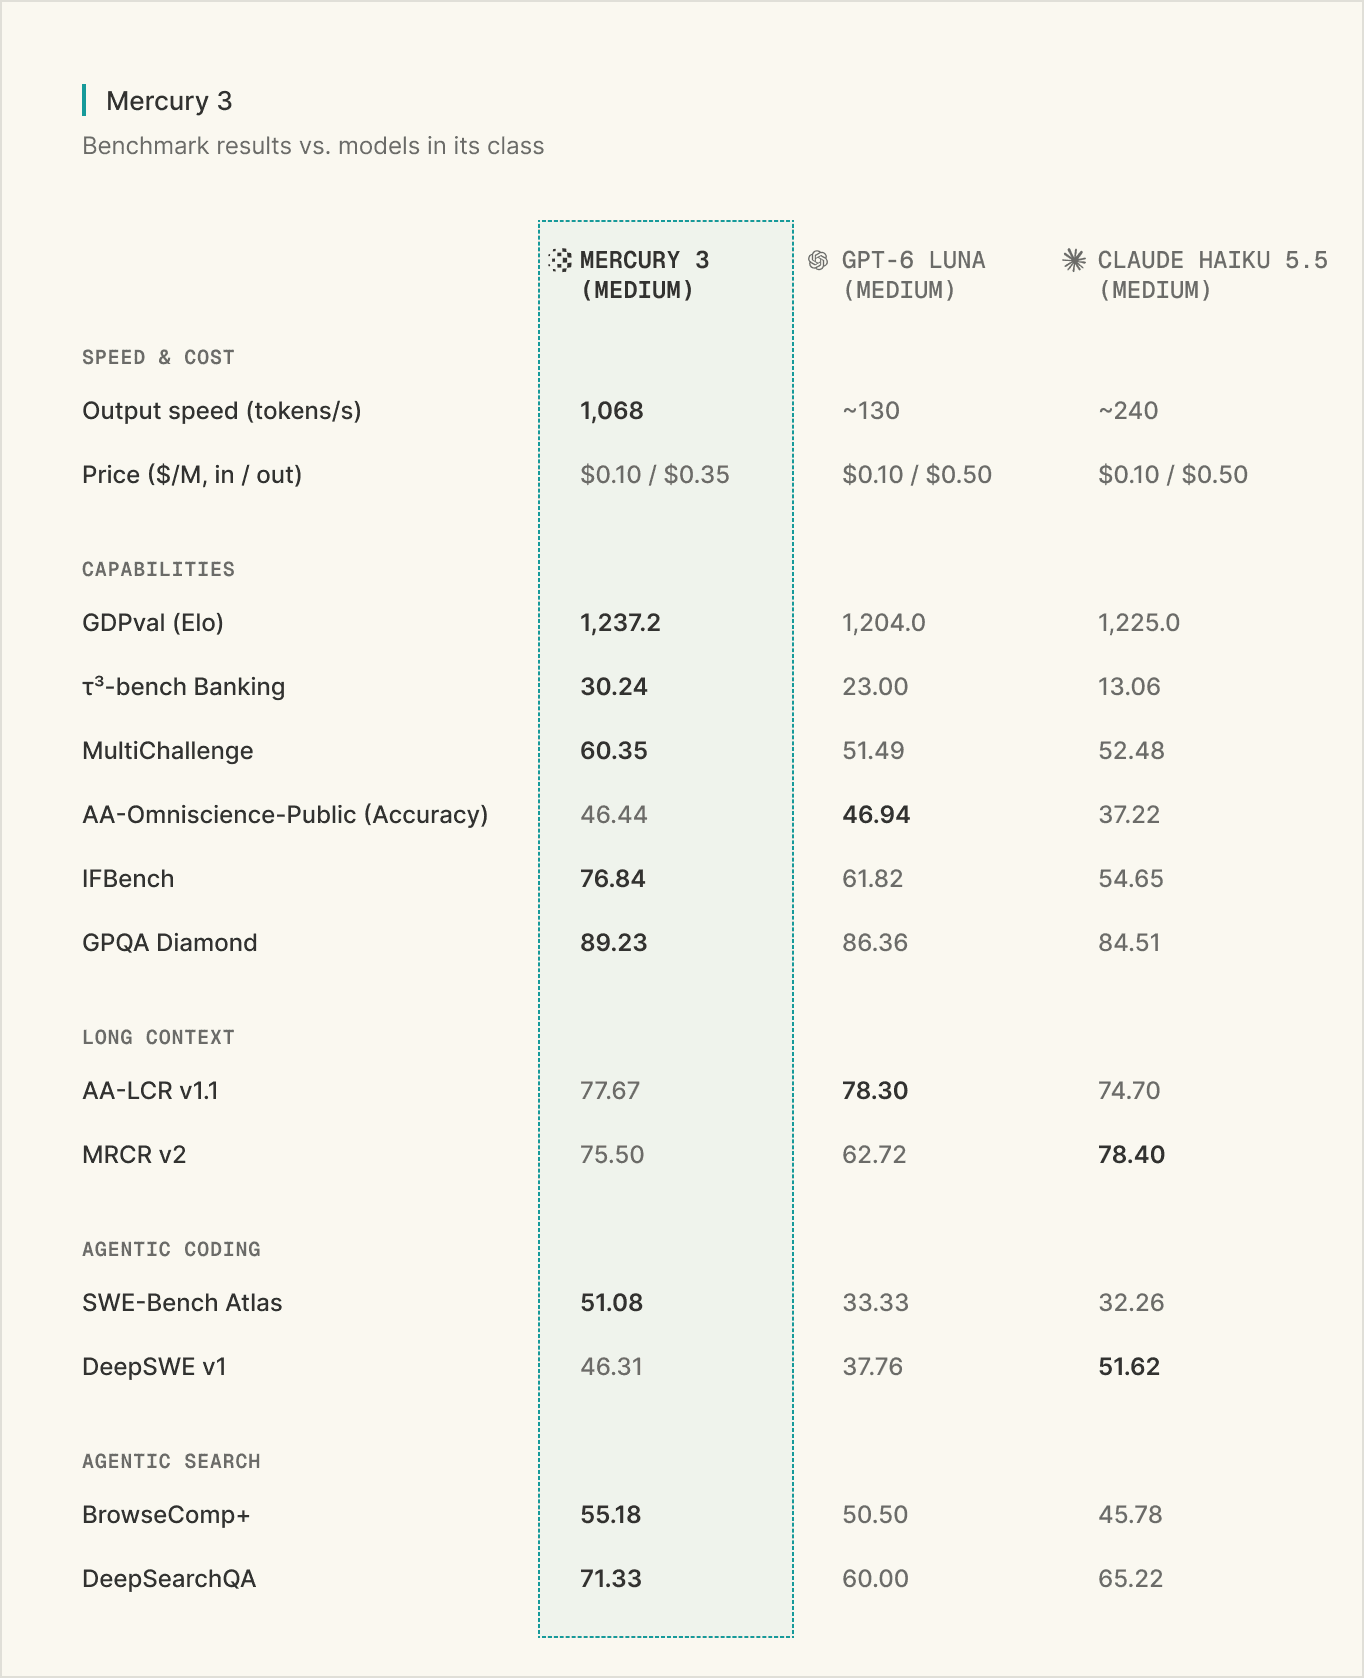
逐项数表里的 12 项能力评测,Mercury 3 有 8 项是三者最高,单独对 GPT-6 Luna、对 Claude Haiku 5.5 都赢 10 项。领先最多的是 agent 类评测(agent 指能自己调用工具、一步步把事办完的 AI):修真实代码仓库问题的 SWE-Bench Atlas,Mercury 3 得 51 分,两个对手都在 33 分上下;考按指令要求办事的 IFBench、模拟银行客服办业务的 τ³-bench Banking,也领先 7 到 15 分。输掉的 4 项集中在两处:在长文档里找信息(AA-LCR、MRCR v2),以及另一项编程评测 DeepSWE,后者比 Haiku 低 5 分;另有一项考知识准确度的 AA-Omniscience,以 0.5 分之差输给 Luna。
价格:成绩表里写的是首发五折价
成绩表的价格一栏,三家看上去差不多:每百万 token 输入都是 0.10 美元,输出 Mercury 3 是 0.35,另两家是 0.50。但 Mercury 3 这一栏是首发五折价,标价是输入 0.20、输出 0.70 美元,按标价算,输入是对手的 2 倍,输出是 1.4 倍。官方没说折扣持续多久。缓存命中的输入(重复发送的同一段前文,服务端已经存过)再打一折,标价 0.02、首发 0.01 美元。
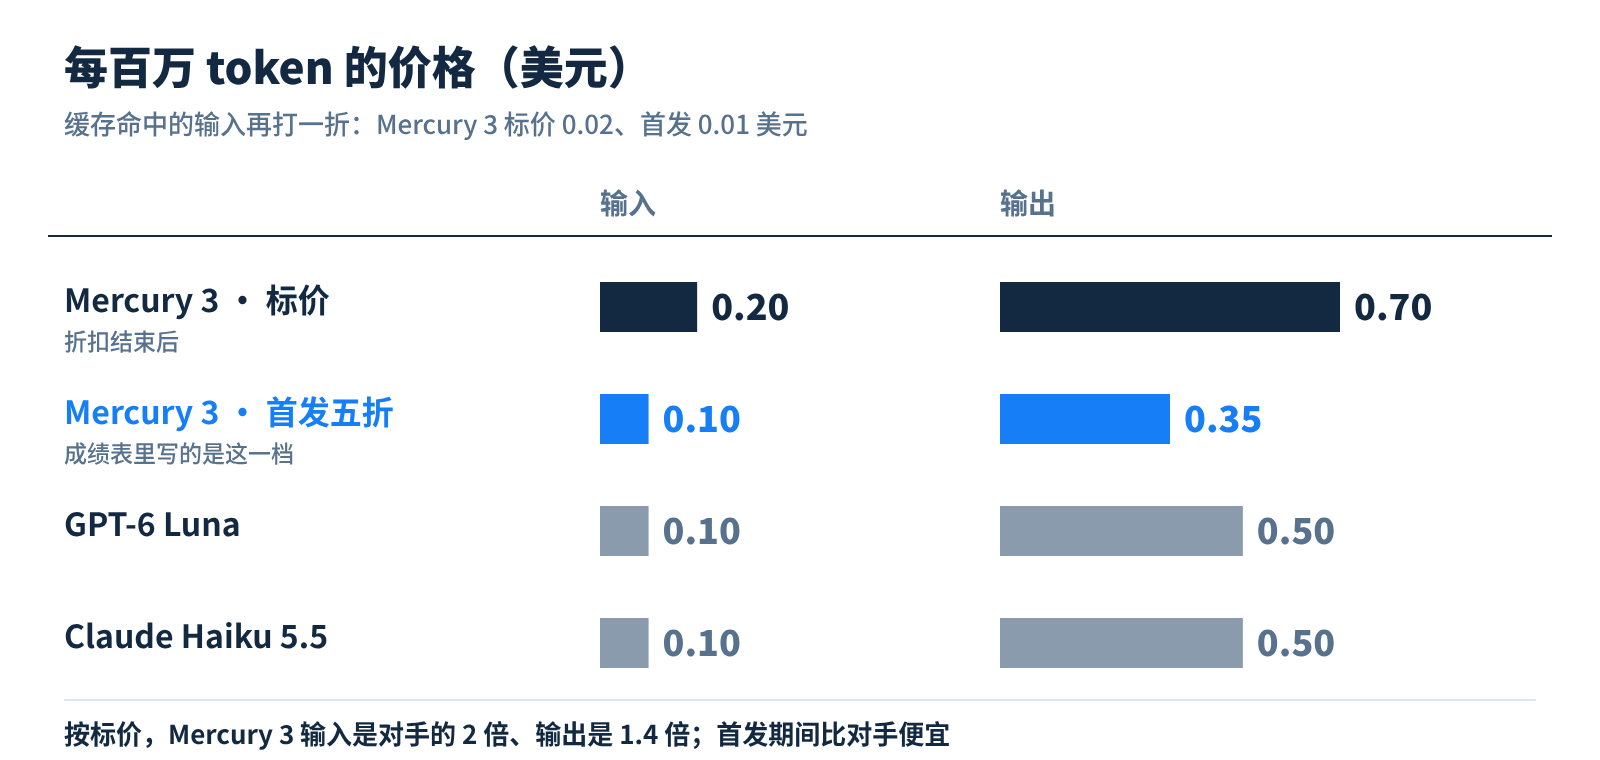
两个对手的价格在第三方评测机构那里也查得到,确实都是 0.10 和 0.50 美元。所以更准确的说法是:Mercury 3 首发期间比对手便宜一些,折扣结束后会贵一些,它真正拉开的差距是速度。新注册的 API 账户送 1 亿 token;Mercury 2 和 2.5 已不再对新用户开放,老用户可以用到 11 月 15 日。
快 4 到 8 倍有什么用:agent 每一步都在等模型
对聊天来说,快一点只是舒服;对 agent 来说,快慢决定能不能用。agent 办一件事要走很多步:看网页、调工具、读结果、决定下一步,每一步都要等模型写完。按官方速度换算,一个 20 步、每步写 500 个 token 的任务,光等模型写字,Mercury 3 约 9 秒,GPT-6 Luna 要一分多钟。
Inception 列了四家早期合作方的使用情况,都是合作方自述:
- 浏览器 agent:TinyFish AI 在自家网页 agent 框架里跑了 50 个 Mind2Web 导航任务(让 AI 在真实网站上完成查询、填表这类操作),Mercury 3 完成一半,明显多于 GPT-6.1-Sol;用的 token 量和步数与前沿模型相当,按 token 算的费用只是零头。
- 在线教育:RevisionDojo 说,提示、批改和名词解释大约一秒返回,质量不低于之前用的模型,而且直接替换、不用改代码。
- 实时搜索:Octen AI 在智能眼镜上测试,搜索本身只要约 80 毫秒,瓶颈在模型生成;Mercury 3 生成时间的中位数是 0.9 秒,从提问到回答全程的中位数是 2.2 秒。
- 客服:给受监管行业做语音、聊天和邮件客服的 Lorikeet 说,早期测试里 Mercury 3 延迟最低,评测和线上表现也更好。
Mercury 3 之外,Inception 还有两款专用模型。Mercury Voice 给语音 agent 用,优化的是 TTFAT(time to first answer token,从提问到第一个回答 token 出来的时间),官方说首个 token 在 170 毫秒内返回;Mercury Decide 是做大批量分类的决策模型,只在给定选项里选并给出概率,官方说它在 JevBench、LegalBench 上超过同类的 Jev。Mercury 3 的接口和 OpenAI 的格式兼容,换模型只要改地址和模型名,目前也上了 OpenRouter、Baseten、Vercel 等平台。
这些数字该信几分:看上一代的第三方实测
上面的成绩和速度都是 Inception 自己测的。独立评测机构 Artificial Analysis 还没收录 Mercury 3,但测过上一代:通过 API 实测,Mercury 2.5 的输出速度约每秒 720 个 token,低于官方说的 1,107,但在它测的 151 个模型里仍排第 2;同一机构测 Claude Haiku 5.5 约 176 个,也低于 Inception 表里的约 240。测法不同,各家数字都会偏低,倍数差距大体还在。
差距更明显的是“质量相当”。Artificial Analysis 的智能指数是用多项评测合成的综合分,Mercury 2.5 只有 12 分,而它发布时对标的 Claude Haiku 4.5 是 17 分,GPT-5.6 Luna(low 档)21 分,Gemini 3.5 Flash-Lite 22 分。
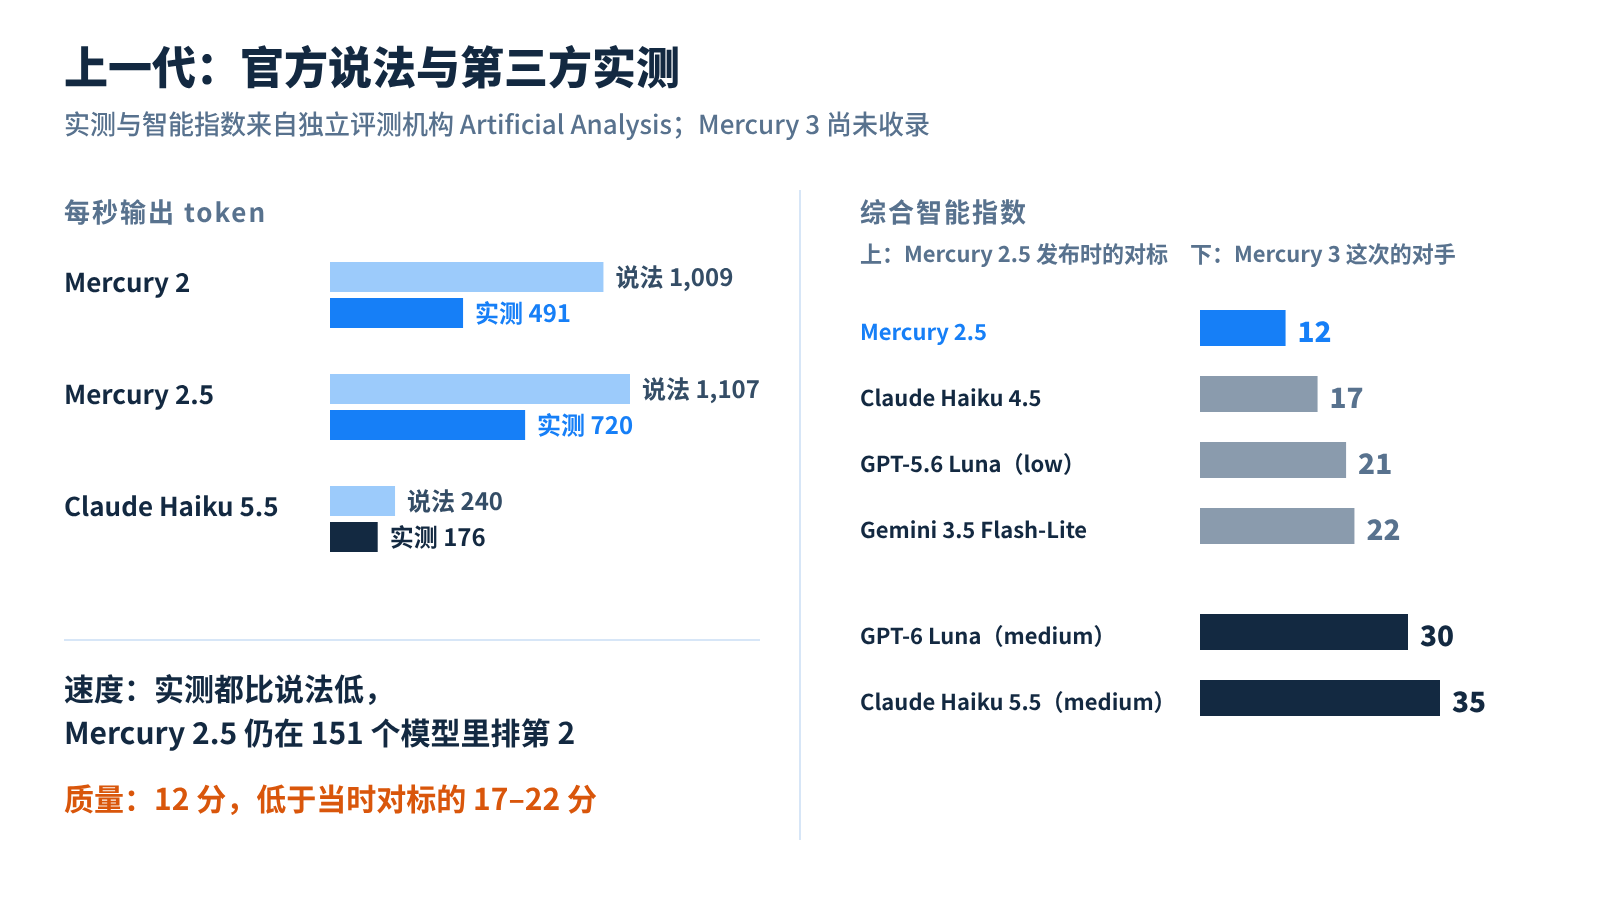
也就是说,上一代快是真的快,“质量相当”要打折扣。这次对标的 GPT-6 Luna、Claude Haiku 5.5(都是 medium 档)在这个指数上是 30 分和 34 分,Mercury 3 要真与它们相当,得从上一代的 12 分涨到 30 分以上;而 Inception 自己的平均分里,2.5 到 3 只涨了约四成。第三方结果出来之前,比较稳的判断是:扩散语言模型已经做到了速度型模型这一档,最适合语音、搜索、agent 子任务这类等不起的场景;要拿它换掉手上的模型,先用自己的任务各跑一遍。