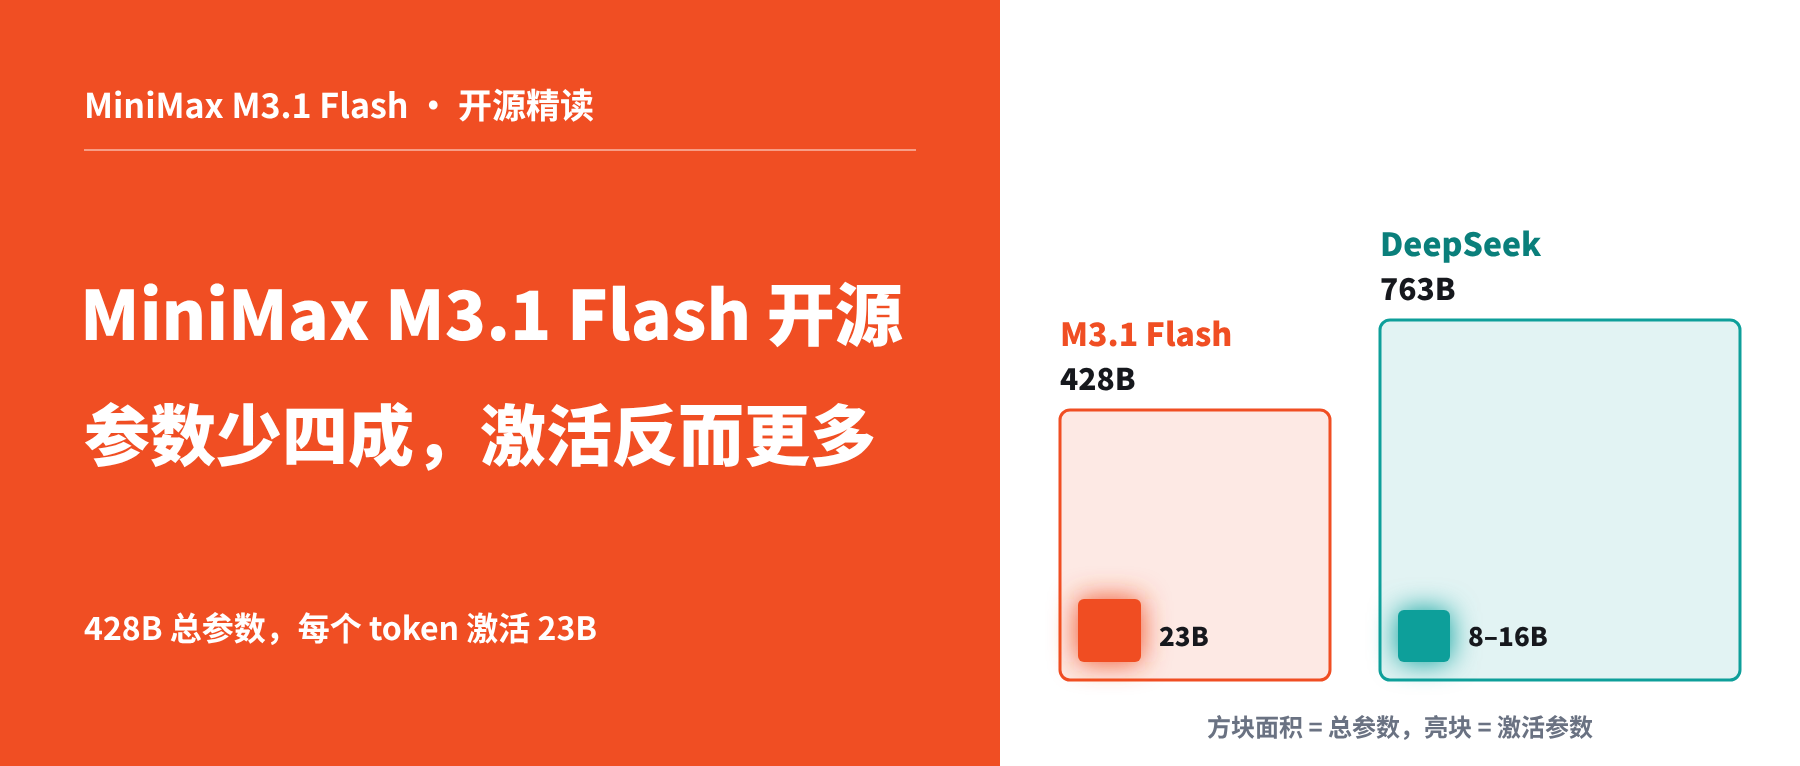
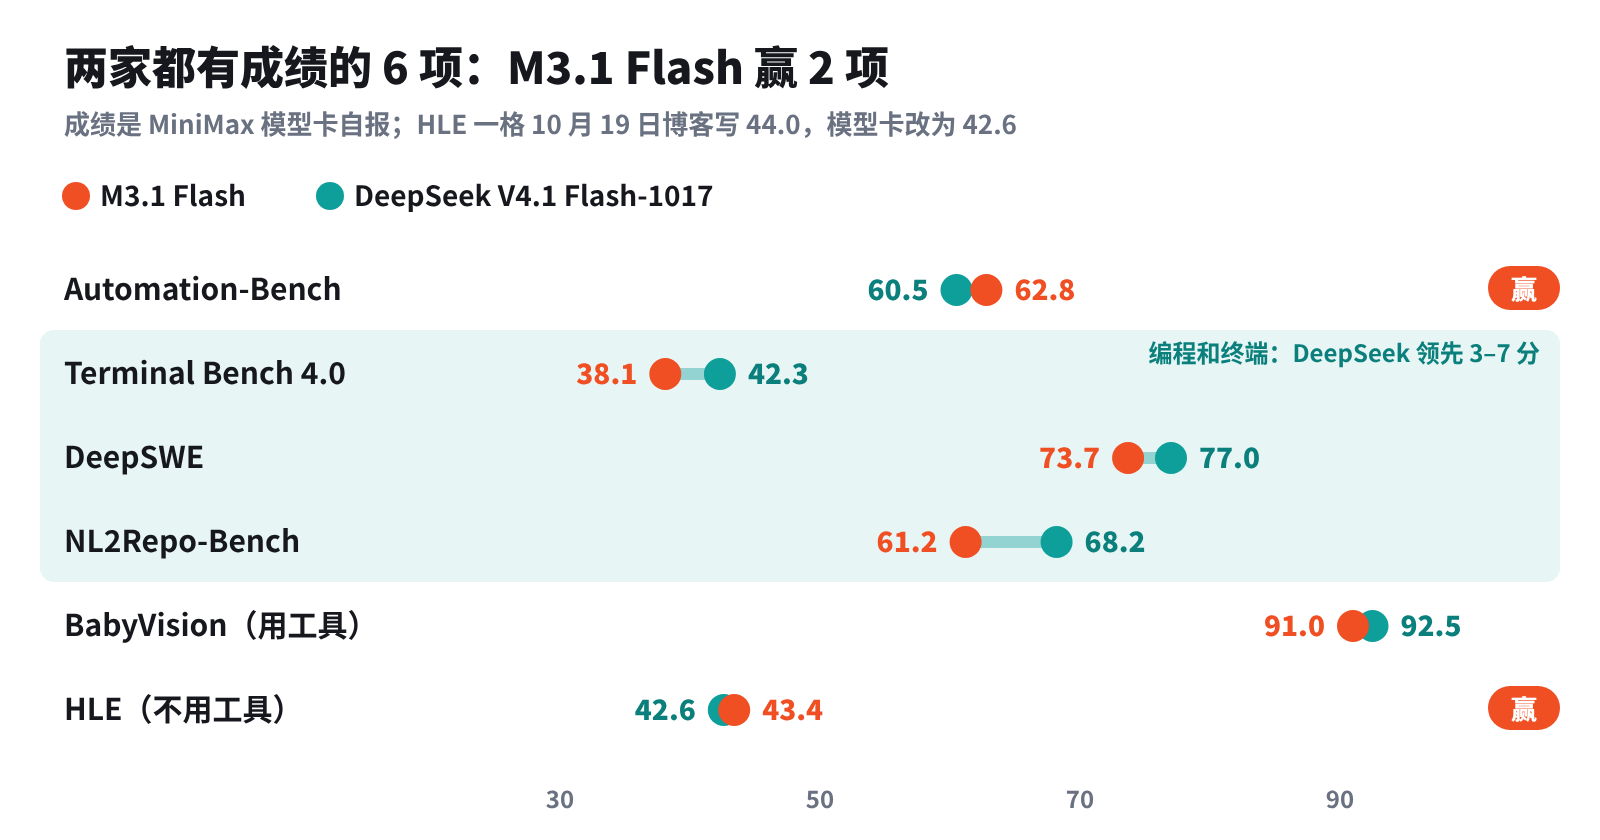
摘要 MiniMax 10 月 23 日开源 M3.1 Flash:总参数约 428B、每个 token 激活约 23B,和上一代 M3 相同,支持文本、图片和视频输入,上下文 100 万 token。这一版的三处改动都冲着推理效率:M3 剩下的 3 层全注意力也换成稀疏注意力,训练时就把专家和注意力按低精度量化,投机解码换成 DSpark 并附上草稿头。和 DeepSeek V4.1 Flash 比,它的总参数约为对方的 56%,但对方每个 token 只激活 8B 到 16B;两家都有成绩的 6 项评测里 M3.1 Flash 赢 2 项,编程和终端操作的三项都是 DeepSeek 更强。权重可以下载,商用要在产品里注明并通知 MiniMax,年收入超过 2000 万美元需要书面授权,比 DeepSeek 用的 MIT 许可证多了几道手续。
10 月 23 日,MiniMax 在 Hugging Face 放出了 M3.1 Flash 的权重。四天前它先以 API 上线,官方博客当时写的是“权重稍后发布”。X 上的 Gorden Sun 发帖时只给了三个数:总参数 428B、激活 23B,比 DeepSeek Flash 的 763B 小不少。三个数都对得上,但第三个数还有另一面:DeepSeek V4.1 Flash 每个 token 只动用 8B 到 16B 参数,比 M3.1 Flash 还少。下面从这两个参数数讲起,再看这一版改了什么、和 DeepSeek 怎么比,以及权重下载之后能拿来做什么。
参数没变:428B 总参数,每个 token 只用 23B
M3.1 Flash 是混合专家模型(MoE,Mixture of Experts):模型里有很多组“专家”子网络,每处理一个 token(模型读写文字的计量单位)只调用其中几组。所以它有两个参数数。总参数约 428B,决定权重文件有多大、部署要准备多少显存;激活参数约 23B,决定每个 token 实际要算多少。两个数都和 6 月发布的 M3 一致。
按仓库里的配置文件,它一共 60 层,除开头 3 层外,每层有 128 个路由专家,每个 token 挑 4 个,另有 1 个所有 token 都要经过的共享专家。输入可以是文本、图片和视频,输出是文本,上下文窗口(模型一次能看到的全部内容)最长 100 万 token。
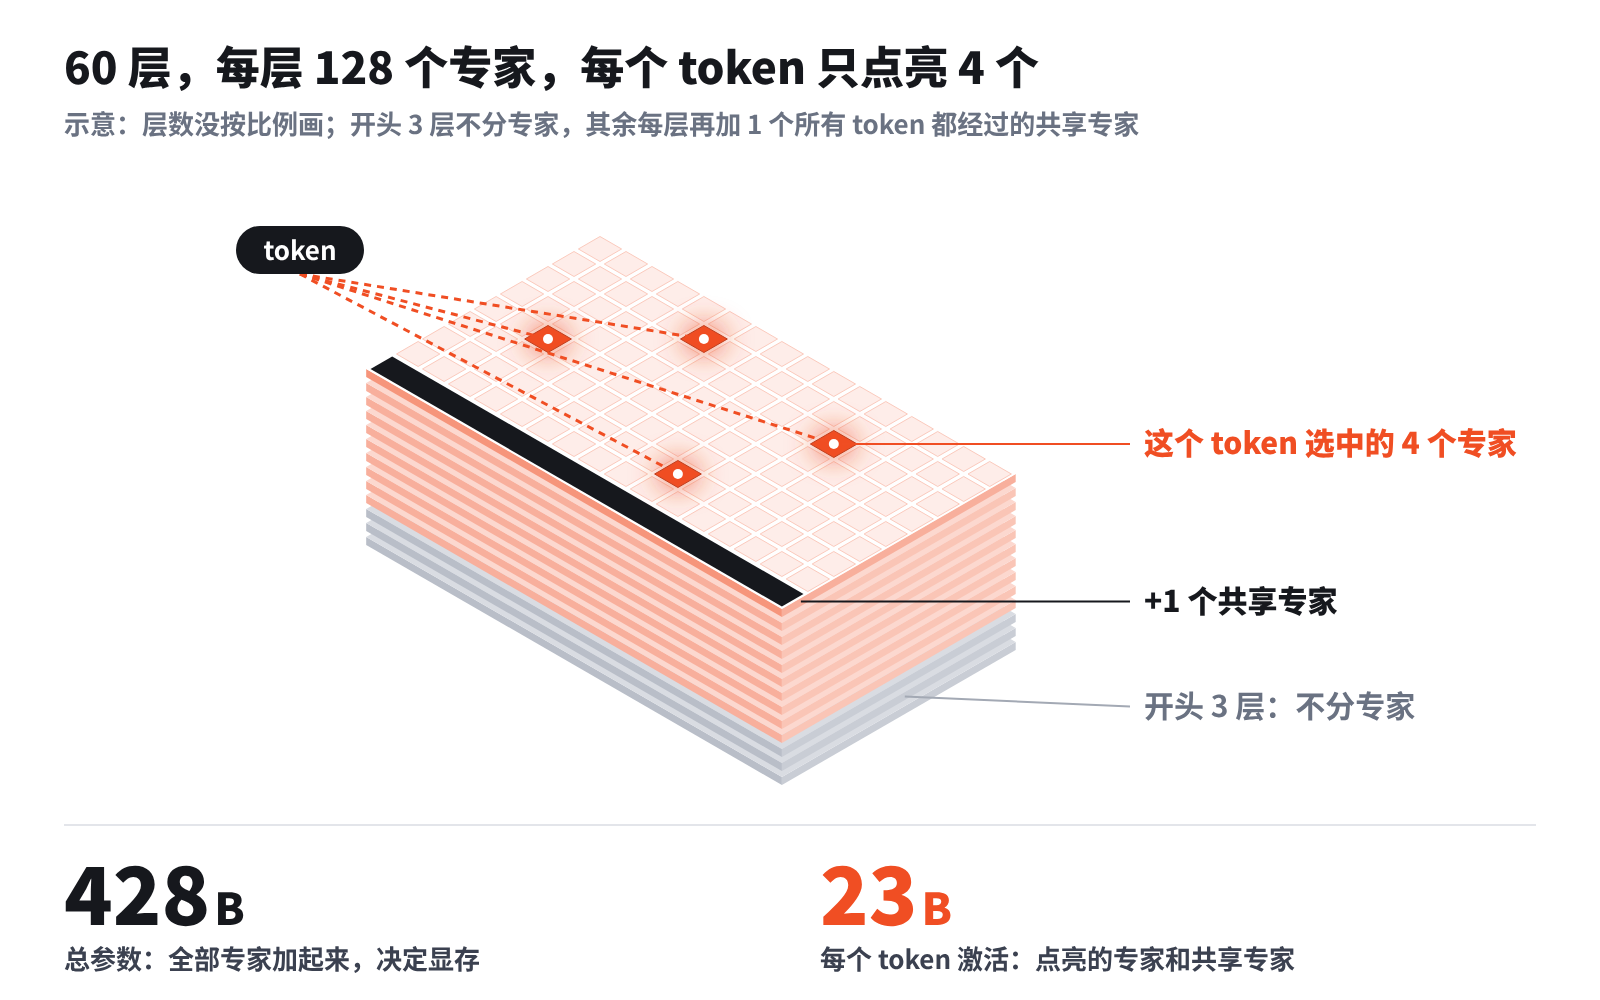
想自己部署,先算权重有多大:48 个分片合计约 250 GB,另有 2.3 GB 的投机解码草稿头。按 428B 参数折算,平均每个参数约 4.7 比特,比常见的 16 比特小得多,这和下一节的“训练时就量化”对得上。
改了三处,都冲着推理效率
模型卡说 M3.1 Flash 保留了 M3 的混合专家架构,改动有三处,目的都是让同一个模型跑得更快、更省:
第一处是全模型稀疏注意力。 注意力是模型生成每个 token 时回头查看前文的机制。全注意力要把前文每个 token 都算一遍,上下文越长越贵,到 100 万 token 时这部分最吃算力。MiniMax 的稀疏注意力 MSA(MiniMax Sparse Attention)先用一个轻量的索引分支给前文分块打分,只挑最相关的几块精算:配置里每块 128 个 token,挑 16 块,再加上紧挨着的一块。M3 已经用上 MSA,但开头 3 层还是全注意力;M3.1 Flash 把这 3 层也换掉,60 层全部稀疏。
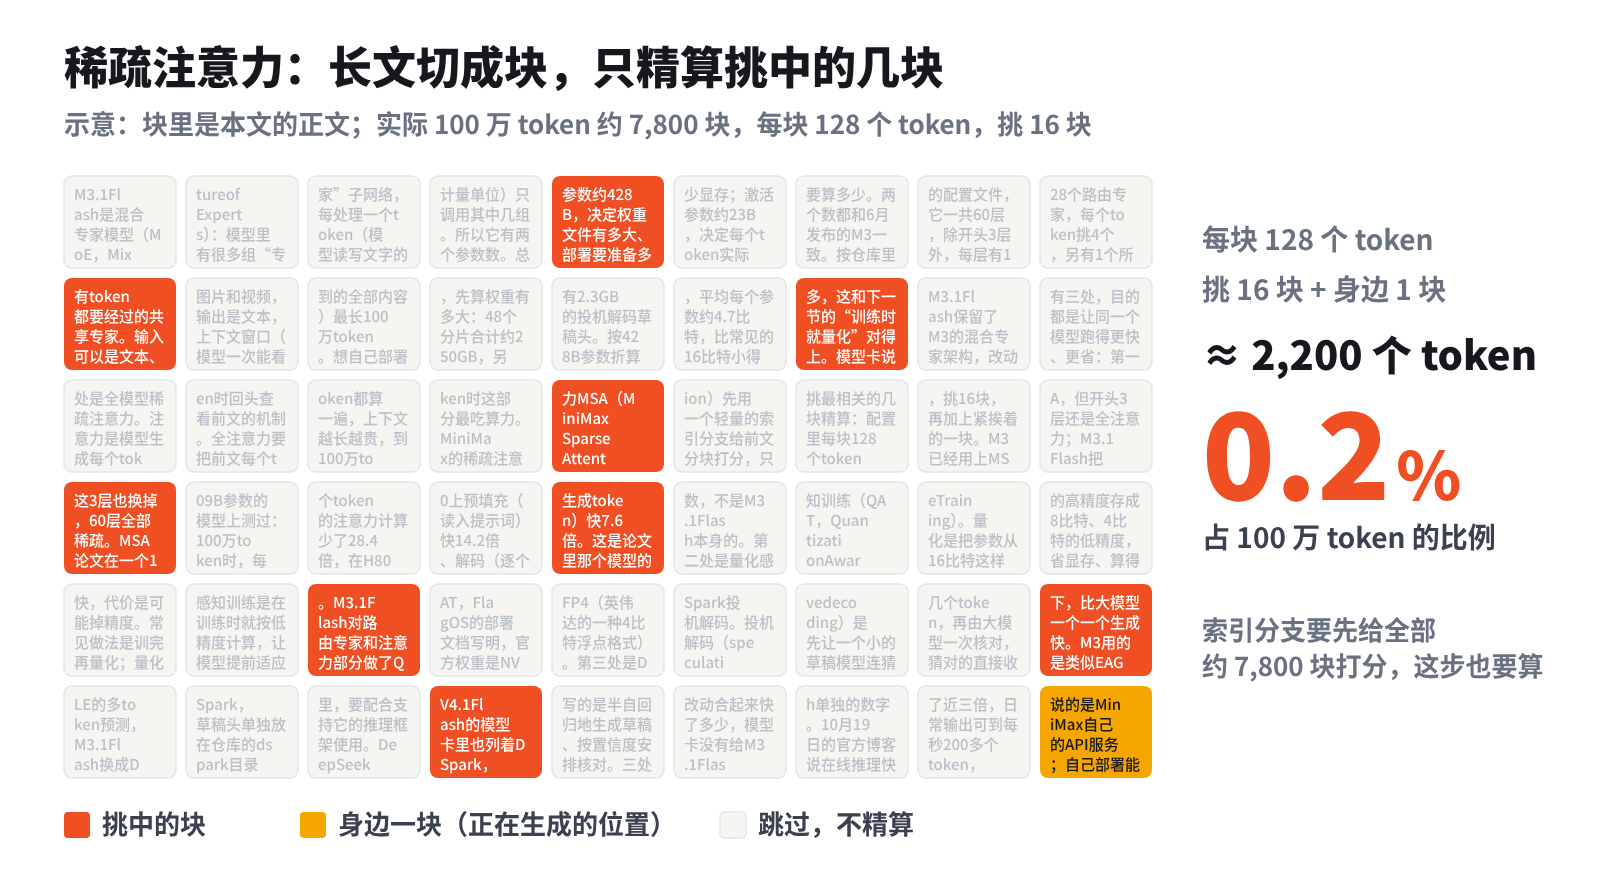
MSA 论文在一个 109B 参数的模型上测过:100 万 token 时,每个 token 的注意力计算少了 28.4 倍,在 H800 上预填充(读入提示词)快 14.2 倍、解码(逐个生成 token)快 7.6 倍。这是论文里那个模型的数,不是 M3.1 Flash 本身的。
第二处是量化感知训练(QAT,Quantization-Aware Training)。 量化是把参数从 16 比特这样的高精度存成 8 比特、4 比特的低精度,省显存、算得快,代价是可能掉精度。常见做法是训完再量化;量化感知训练是在训练时就按低精度计算,让模型提前适应。M3.1 Flash 对路由专家和注意力部分做了 QAT,FlagOS 的部署文档写明,官方权重是 NVFP4(英伟达的一种 4 比特浮点格式)。
第三处是 DSpark 投机解码。 投机解码(speculative decoding)是先让一个小的草稿模型连猜几个 token,再由大模型一次核对,猜对的直接收下,比大模型一个一个生成快。M3 用的是类似 EAGLE 的多 token 预测,M3.1 Flash 换成 DSpark,草稿头单独放在仓库的 dspark 目录里,要配合支持它的推理框架使用。DeepSeek V4.1 Flash 的模型卡里也列着 DSpark,写的是半自回归地生成草稿、按置信度安排核对。
三处改动合起来快了多少,模型卡没有给 M3.1 Flash 单独的数字。10 月 19 日的官方博客说在线推理快了近三倍,日常输出可到每秒 200 多个 token,说的是 MiniMax 自己的 API 服务;自己部署能跑多快,取决于显卡和推理框架。
和 DeepSeek V4.1 Flash 比:总参数小,激活的反而多
推文里拿来对比的 763B,是 DeepSeek V4.1 Flash 在 Hugging Face 上的权重合计。它的模型卡写得更细:主干参数 552B,另有 196B 的 Engram 条件记忆(按 token 查表、只读取少量条目的记忆模块);它采用编码器加解码器的结构,每个 token 读入时只激活 8B,生成时激活 16B。
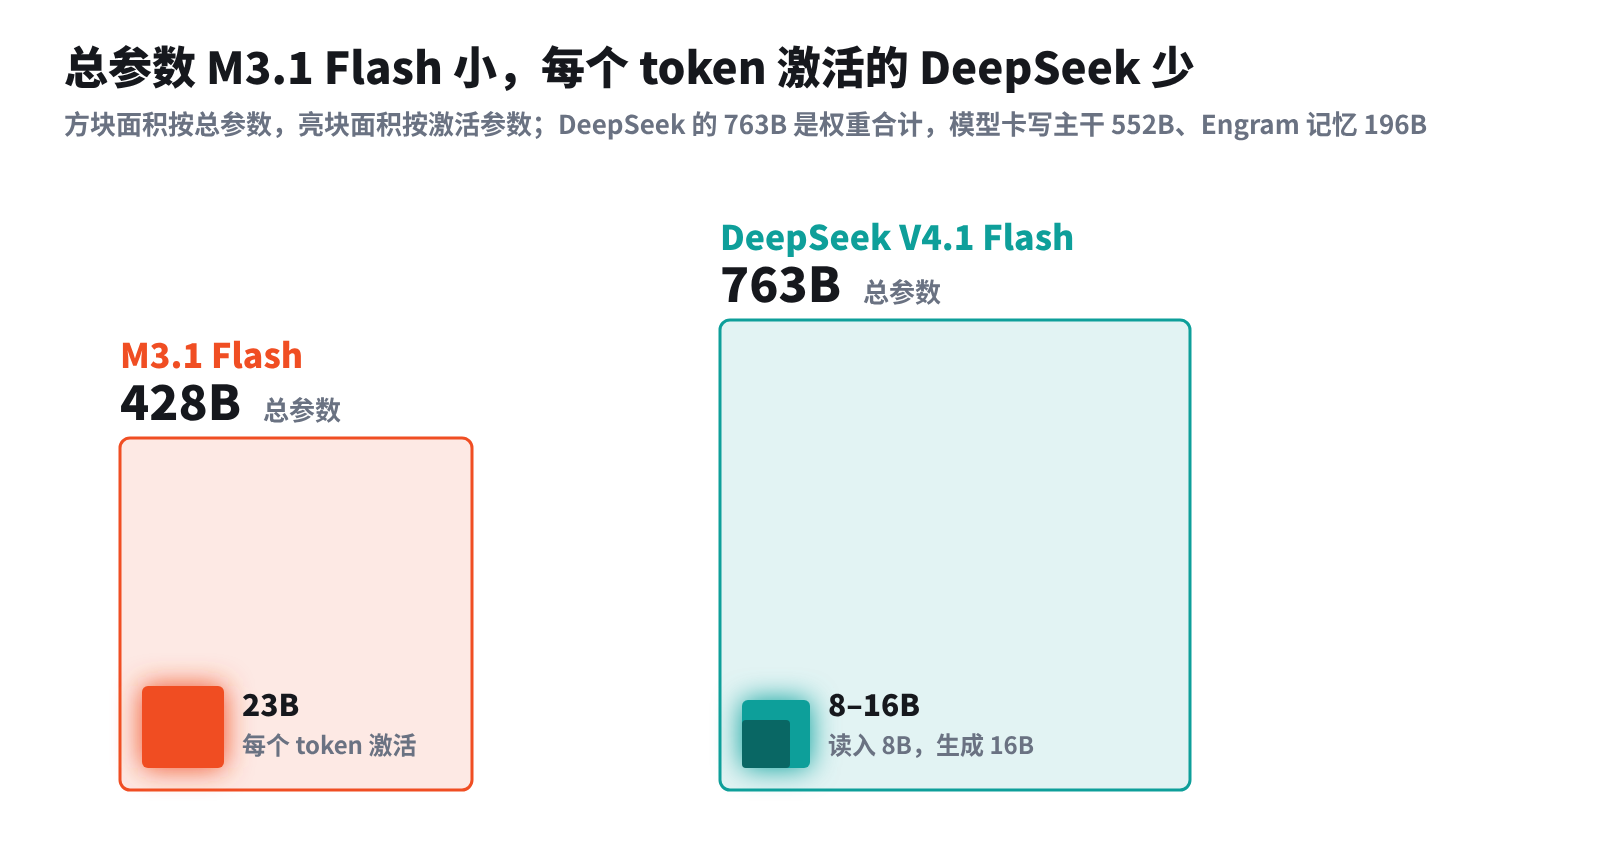
所以“M3.1 Flash 小不少”要分两头看。总参数 428B 约为 763B 的 56%,自己部署时要准备的显存更少;但 M3.1 Flash 每个 token 要动用 23B,比 DeepSeek 生成时的 16B 多四成多,单个 token 的计算并不更省。哪个跑起来更便宜,取决于部署方式和任务里读入、生成各占多少,不能只看总参数。
能力上,MiniMax 在模型卡里放了一张 15 项评测的对比表,对手是 DeepSeek、Kimi、GLM 和 GPT-5.6 Sol、Opus 5,成绩都是 MiniMax 自己报的。表里 DeepSeek 有两列:9 月的 V4.1 Flash 和 10 月 17 日的 V4.1 Flash-1017。
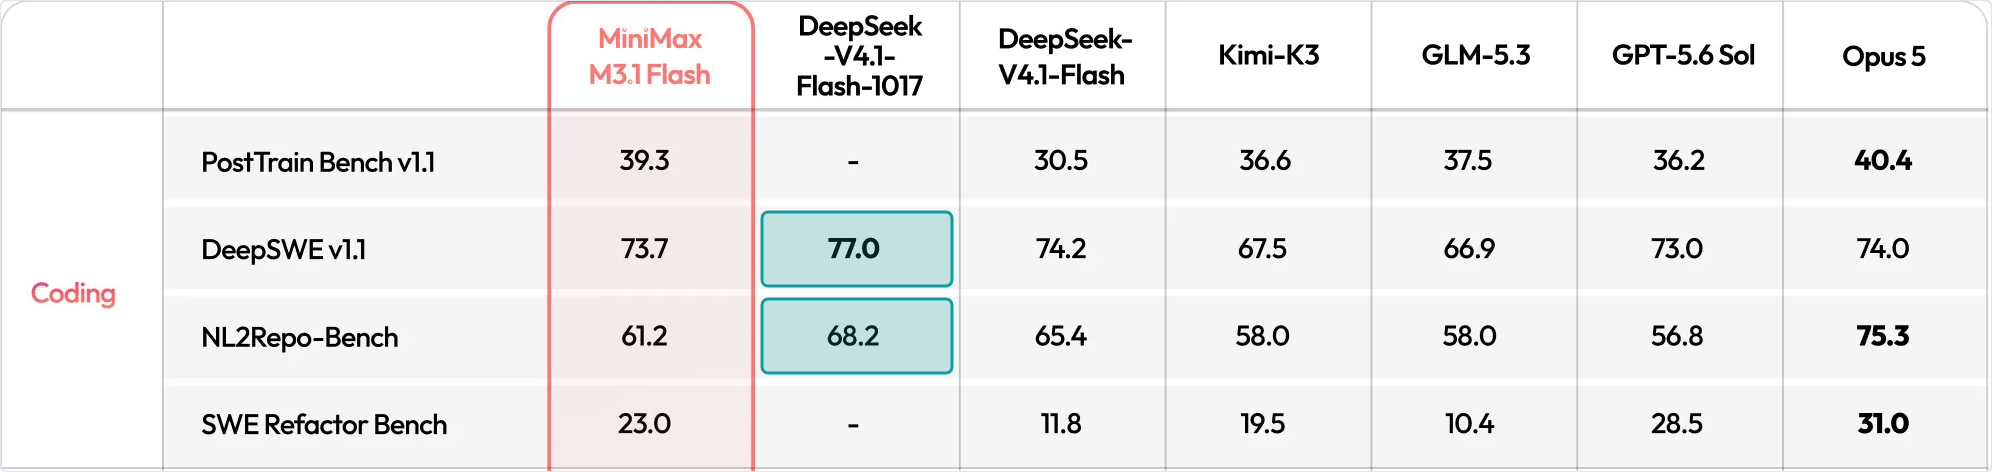
和更新的 1017 版比,两家都有成绩的只有 6 项。M3.1 Flash 赢 Automation-Bench(62.8 对 60.5)和 HLE(43.4 对 42.6),DeepSeek 赢 Terminal Bench 4.0、DeepSWE、NL2Repo-Bench 和 BabyVision,其中编程和终端操作的三项差 3 到 7 分。HLE 这一格,10 月 19 日官方博客里的同一张表写的是 44.0,模型卡改成了 42.6;按博客的数是 1 胜 5 负。
权重能下载,商用要署名、报备
开源说的是权重可以下载、修改、再发布,能不能拿去赚钱要看许可证。M3.1 Flash 用的是 MiniMax 社区许可证,和 M3 同一份:非商业用途可以自由使用;商用要在网站、界面或产品文档里显著标注“Built with MiniMax M3.1-Flash”,并给 MiniMax 发一封通知邮件;产品年收入超过 2000 万美元,要先拿到 MiniMax 的书面授权。许可证对“商用”的定义很宽,收费的产品和服务、商用 API、拿微调过的版本做生意都算,另外还列了禁止用途,比如军事用途。DeepSeek V4.1 Flash 用的是 MIT 许可证,只要求保留版权和许可声明。
部署上,模型卡推荐 SGLang、vLLM 和 TokenSpeed 三个推理框架,Transformers、KTransformers 等还在适配;推荐采样参数是 temperature 1.0、top_p 0.95,推理强度可以在 low 到 max 五档里选。国产芯片方面,智源研究院等联合发起的 FlagOS 社区把官方的 NVFP4 权重重新量化成 W8A8(权重和激活都用 8 比特)版本,覆盖平头哥、英伟达、沐曦、海光、华为昇腾、摩尔线程、天数智芯、昆仑芯和清微智能九家的芯片,示例是在平头哥芯片上 8 卡并行运行。
看一个开源模型,先看这三样
- 两个参数数一起看。 总参数决定要多少显存,激活参数决定每个 token 算多少;M3.1 Flash 和 DeepSeek V4.1 Flash 正好一个总量小、一个激活少。
- 许可证比“开源”两个字重要。 同样能下载,MIT 和需要署名、报备、超过营收门槛要授权的许可证,对做产品的人是两回事。
- 看推理配套给没给全。 草稿头、低精度权重、推理框架和芯片适配,决定自己部署能不能接近官方说的速度。模型卡没有给自部署的速度,正式用之前先在自己的硬件上测。