摘要 Meta 10 月 12 日发布 Muse Wonder 和 Muse Wonder Full。第三方的 Artificial Analysis 智能指数上,Full 拿到 56 分,离第一名 Claude Opus 5.5 差两分,而首款 Muse Spark 只有 31 分。Meta 公布了 14 项评测的对比,自家两款拿了 7 项第一,Opus 5.5 拿了 6 项,GPT-6 Astra 拿了 1 项。Meta 的优势集中在长周期编程和长流程 Agent 任务上。7 项第一里有 2 项是 Meta 的内部评测,领先最多的一项,各家用的不是同一套测试工具。成绩最好的 Full 不上 API,只在 Muse Code 最高的两档订阅里。
10 月 12 日(北京时间 13 日凌晨),Meta 发布了新一代旗舰模型 Muse Wonder 和 Muse Wonder Full。在第三方评测机构 Artificial Analysis(简称 AA)的智能指数上,Full 拿到 56 分,比排第一的 Claude Opus 5.5 低两分。
扎克伯格发帖说,Meta 超级智能实验室成立才一年多,新模型“把我们带到了前沿”。首席 AI 官 Alexandr Wang 的说法更口语:rivals the big bois,能跟那几个大块头较量了。
发布当天,有中文报道用“多项屠榜”做标题。Meta 的博客里放了一张成绩总表,列了 14 项评测,把自家两款和 Claude Opus 5.5、GPT-6 Astra、Claude Fable 5.1 并排比较。一项一项数下来,Muse Wonder 系列拿了 7 项第一,Opus 5.5 拿了 6 项,GPT-6 Astra 拿了 1 项。
赢一半算不上屠榜。可 Meta 是 14 个月前才把 AI 研发推倒重来的,首款模型在这个指数上只有 31 分。下面看这 7 项赢在哪,另外 7 项输在哪,每个分数是谁测的,以及最强的 Full 普通开发者能不能用上。
Muse Wonder 与 Muse Wonder Full:API 上只有前一款
按扎克伯格的说法,Muse Wonder 主打“快的前沿性能”,Muse Wonder Full 是完整版。两款的差别在能力和购买渠道上。
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| Meta Model API | 可用,模型 ID 是 muse-wonder-1.0 | 不提供 |
| Muse Code | 按量付费和全部订阅档 | 只在 Power Usage、Maximum Usage 两档 |
| API 价格(每百万 token) | 输入 4 美元,输出 20 美元 | 无 |
| Artificial Analysis 智能指数 | 52 | 56 |
Muse Code 是 Meta 的命令行编程工具,订阅分四档,Power Usage 和 Maximum Usage 是最高的两档。Meta 的开发者文档专门写了一句:把 Muse Wonder 的推理强度调到 max,并不会切换成 Full。成绩表里最亮眼的那一列,API 用户调不到。
两款的规格相同:上下文窗口 1,048,576 个 token(约 100 万),输入支持文本、图片、视频、音频和 PDF,输出是文本,推理强度从 minimal 到 max 可调。模型目前标注为 preview。API 按量计费,长上下文不加价。
价格上,Muse Wonder 的输入价是上一代 Muse Spark 的 3.2 倍,输出价约 4.7 倍(Spark 是 1.25 美元和 4.25 美元)。Meta 给的选型建议是:长时间运行的复杂任务用 Wonder,量大、对延迟和成本敏感的任务继续用 Spark。
订阅用户要留意一个默认设置。Muse Code 的订阅默认开启 Contributor 模式:多给一些用量,换取 Meta 把用户的提示词、代码、文件和模型回复用于训练后续模型,可以在设置里关闭。走 API 按量付费的 Muse Wonder 只有 Standard 模式,内容不用于训练。
Meta 还说,Muse Wonder 很快会接入面向普通用户的 Muse,先向订阅用户开放。
Artificial Analysis 智能指数:Muse Wonder Full 56 分,Opus 5.5 是 58 分
先看最容易比较的一个数字。Artificial Analysis 是做模型评测的第三方机构,它的智能指数(v4.3)把自己独立跑的 10 项评测合成一个分数,其中有 GDPval-AA、Terminal-Bench 4.0、SciCode 和 Humanity’s Last Exam。
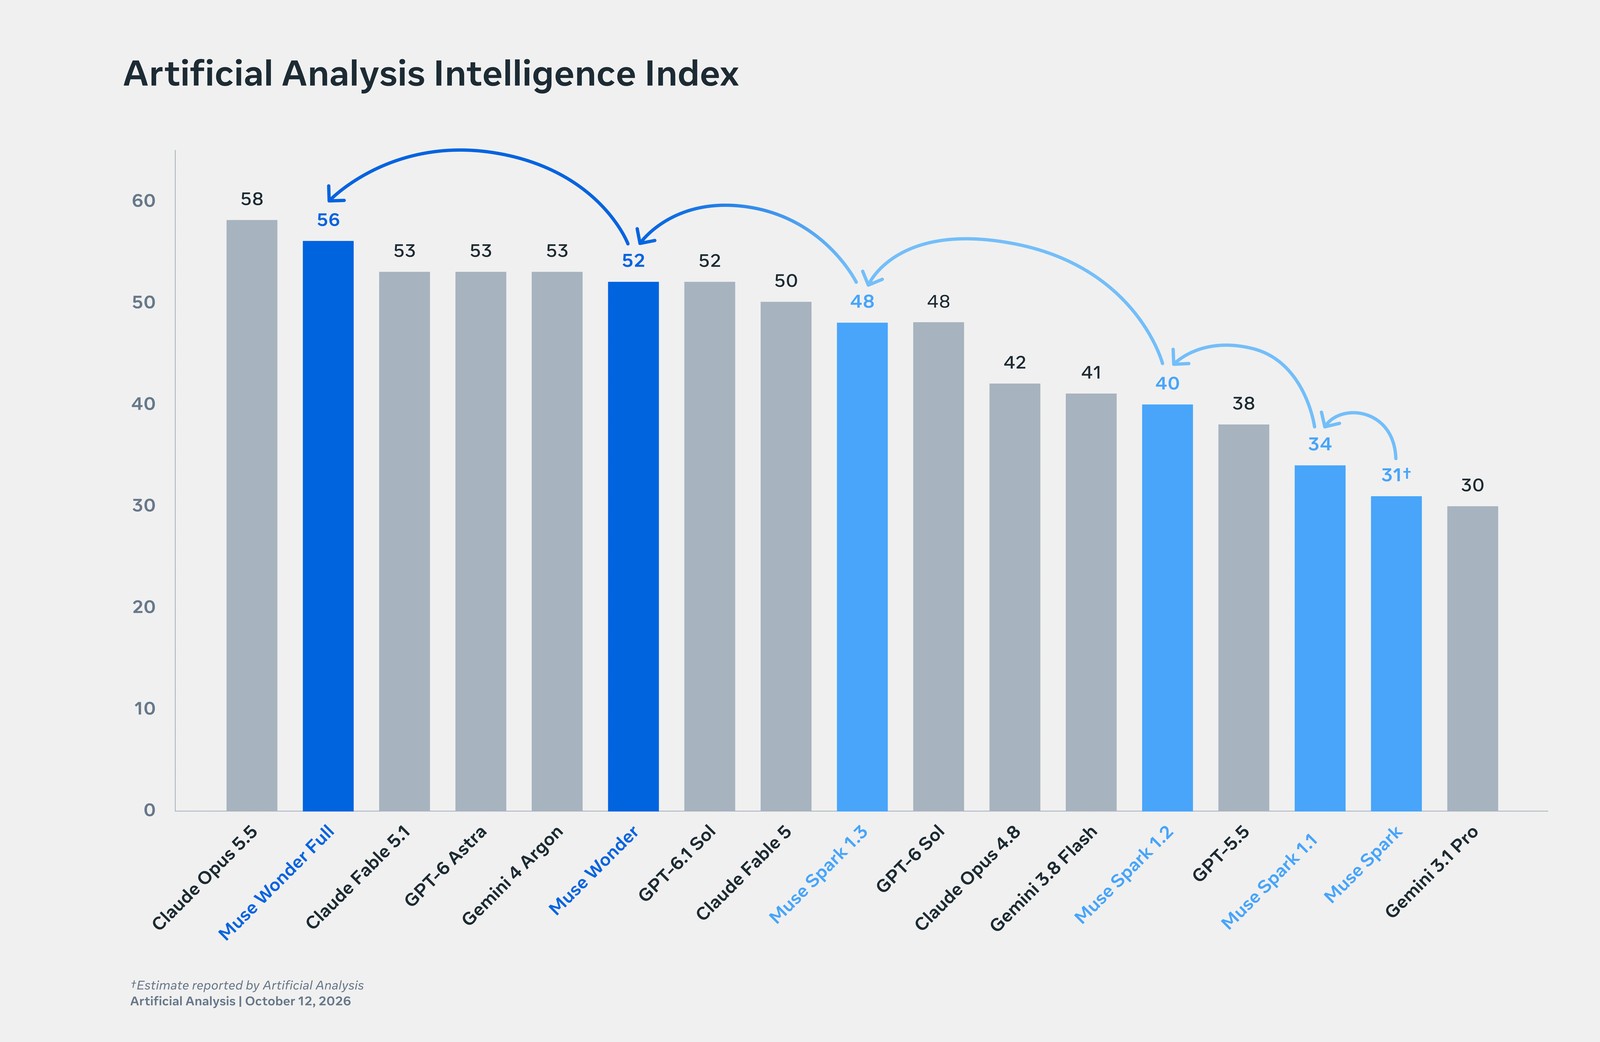
图上 Claude Opus 5.5 以 58 分排第一,Muse Wonder Full 以 56 分排第二。Claude Fable 5.1、GPT-6 Astra 和 Gemini 4 Argon 都是 53 分。API 上能调的 Muse Wonder 是 52 分,与 GPT-6.1 Sol 并列。
更能说明问题的是 Meta 自己的这串台阶:首款 Muse Spark 是 31 分(图上注明这是 Artificial Analysis 的估算值),Spark 1.1 是 34,1.2 是 40,1.3 是 48,现在是 52 和 56。扎克伯格说实验室成立才一年多,博客说 14 个月前开始从底层重建技术栈。一年多时间,Meta 从这张图的倒数第二追到了正数第二。
Meta 把进步归因于规模:预训练和强化学习两个阶段都继续放大,两款模型在它千兆瓦级的 Prometheus 数据中心训练。
14 项评测对比:Meta 7 项第一,Opus 5.5 6 项,GPT-6 Astra 1 项
博客里的总表列了 14 项评测、五款模型,成绩都标注为最高推理强度(max),每一项的最高分加了底色。
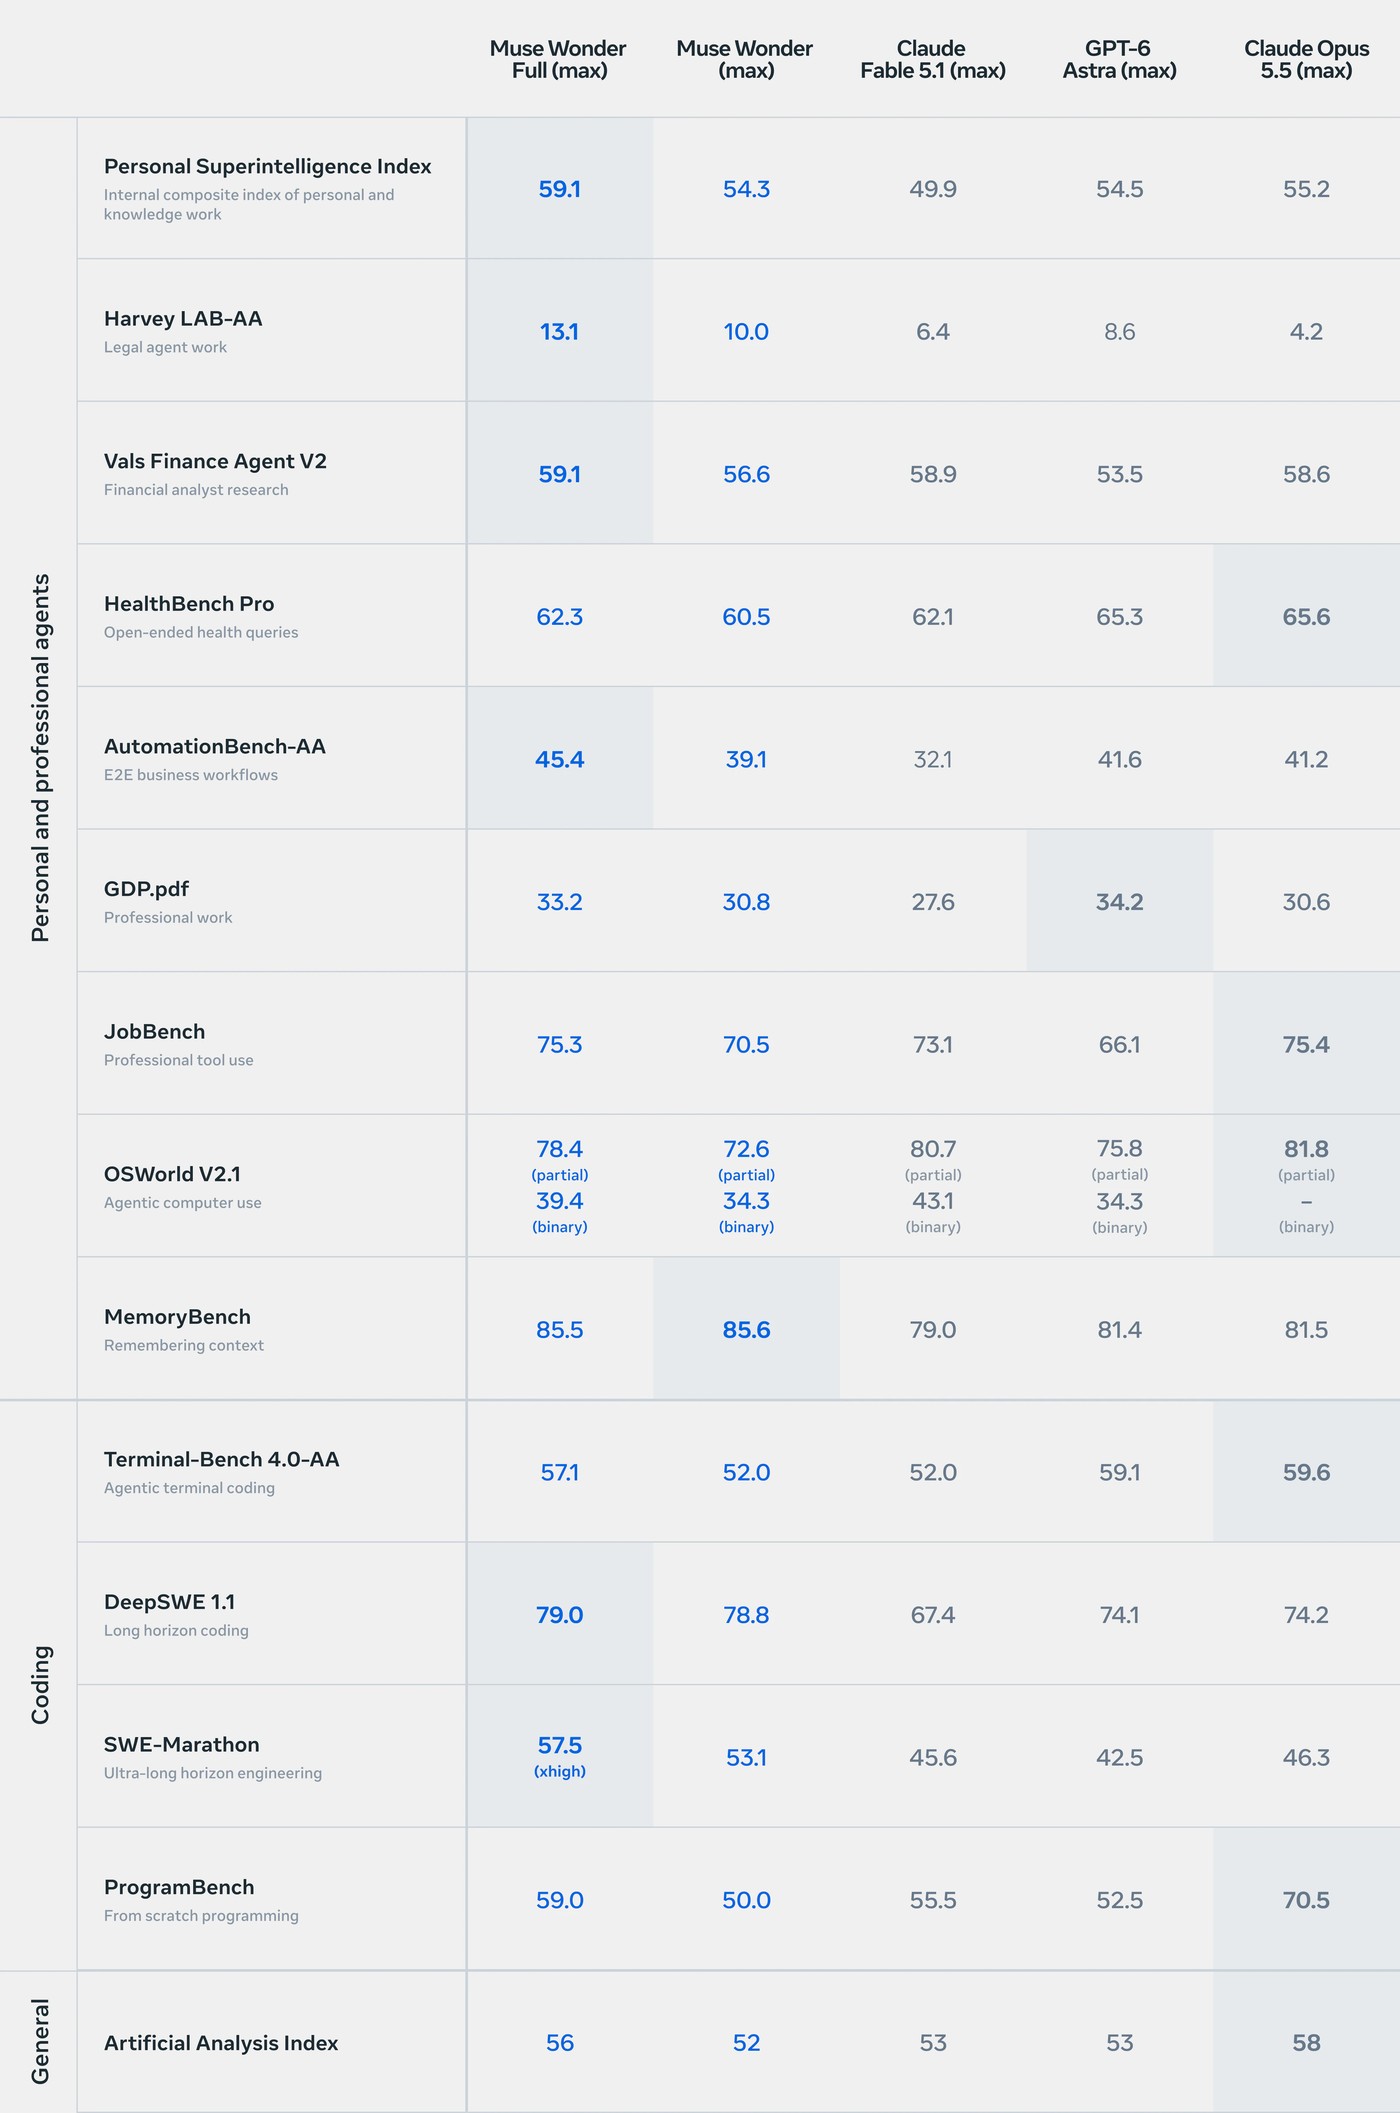
先看 Meta 拿第一的 7 项,按领先幅度排:
| 评测 | Meta 最高分 | 对手最高分 | 领先 |
|---|---|---|---|
| SWE-Marathon(超长周期软件工程) | 57.5 | Opus 5.5 46.3 | 11.2 |
| DeepSWE 1.1(长周期编程) | 79.0 | Opus 5.5 74.2 | 4.8 |
| Harvey LAB-AA(法律 Agent) | 13.1 | GPT-6 Astra 8.6 | 4.5 |
| MemoryBench(长对话记忆) | 85.6 | Opus 5.5 81.5 | 4.1 |
| Personal Superintelligence Index(个人与知识工作综合) | 59.1 | Opus 5.5 55.2 | 3.9 |
| AutomationBench-AA(企业流程自动化) | 45.4 | GPT-6 Astra 41.6 | 3.8 |
| Vals Finance Agent V2(金融分析) | 59.1 | Fable 5.1 58.9 | 0.2 |
MemoryBench 的 85.6 来自 Muse Wonder,比 Full 高 0.1 分;其余 6 项的最高分都是 Full 拿的。
再看别家拿第一的 7 项:
| 评测 | 第一名 | Meta 最高分 | 落后 |
|---|---|---|---|
| ProgramBench(从零写出完整程序) | Opus 5.5 70.5 | 59.0 | 11.5 |
| OSWorld V2.1(操作电脑界面) | Opus 5.5 81.8 | 78.4 | 3.4 |
| HealthBench Pro(健康问答) | Opus 5.5 65.6 | 62.3 | 3.3 |
| Terminal-Bench 4.0-AA(终端里的编程任务) | Opus 5.5 59.6 | 57.1 | 2.5 |
| Artificial Analysis 智能指数(综合) | Opus 5.5 58 | 56 | 2 |
| GDP.pdf(基于 PDF 材料的专业工作) | GPT-6 Astra 34.2 | 33.2 | 1.0 |
| JobBench(白领职业任务) | Opus 5.5 75.4 | 75.3 | 0.1 |
两张表放在一起看,Meta 的优势集中在需要长时间连续干活的任务上。 超长周期的软件工程、长周期编程、法律文书和企业流程自动化,它都排第一。领先最多的是 SWE-Marathon,高出 11.2 分;法律评测 Harvey LAB-AA 上它是 13.1,第二名 GPT-6 Astra 是 8.6,Opus 5.5 只有 4.2。
输掉的 7 项里,ProgramBench 差了 11.5 分,是整张表里最大的一处分差,比 Meta 自己最大的领先幅度还多一点。操作电脑界面、健康问答、终端编程这几项,Opus 5.5 也还在前面。另有三项基本算平手:金融分析 Meta 领先 0.2 分,JobBench 落后 0.1 分,GDP.pdf 落后 1 分。
模型卡里的四条口径:谁出的题,谁跑的分
Meta 同时发布了一份 13 页的模型卡,交代每项评测的做法。其中有四条会影响对上面分数的理解。
两项是内部评测。 Meta 拿第一的 7 项里,Personal Superintelligence Index 是 Meta 内部的综合指数,由七项评测合成;MemoryBench 也是 Meta 的内部评测。另外 5 项的成绩来自第三方:Harvey LAB-AA 和 AutomationBench-AA 来自 Artificial Analysis,金融那项来自 Vals AI,DeepSWE 来自 Datacurve,SWE-Marathon 来自 Abundant AI。
那个综合指数还有个细节。它的七项里,总表单列了三项,Meta 只赢了 AutomationBench-AA,在 JobBench 和 GDP.pdf 上都略低于对手。第四项 FocusBench 是 Meta 的内部评测,单独给了一张图。剩下三项是 Agents’ Last Exam、VBT 和 DRACO,单项分数在博客和模型卡里都没有列出。
领先最多的一项不是受控对比。 模型卡写明,SWE-Marathon 的结果取自 Abundant AI 的榜单,其中 GPT-6 Astra 和 Claude Fable 5.1 的成绩分别是用 Codex 和 Claude Code 跑出来的,所以这一项不是同一套 harness 下的受控对比。harness 指驱动模型干活的那层 Agent 程序,同一个模型换一套 harness,分数会变。另外,Muse Wonder Full 这一格用的是 xhigh 推理强度,表头写的是 max。
缺第三方结果时取最高分。 模型卡的规则是:有可比的第三方或厂商自报成绩就用它;没有的话,从内部验证过的结果、厂商自报分数和官方榜单里取最高的一个。对手模型由 Meta 自己跑的那部分,模型卡说只能算尽力而为,提示词、工具和运行环境未必为这些闭源模型调到了最优。
分数低是因为判分严。 Harvey LAB-AA 的 13.1% 指的是交付物满足全部评判标准、并且通过幻觉检查的任务占比。换句话说,分数最高的模型在约 87% 的法律任务上仍有至少一处不达标。AutomationBench-AA 的 45.4% 是全部终态检查都通过的流程占比,ProgramBench 算的是通过至少 95% 隐藏测试的比例。按这样的标准,法律文书和企业流程这两类任务,离放手交给 Agent 还有不小的距离。
Active Memory 与 Active Focus:两个能力名称各指什么、怎么测的
Muse Wonder 这次主推两个能力名称。
Active Memory(主动记忆)指的是:跨对话保留与用户有关的重要上下文,并在当前任务用得上时主动把它找出来。对应的评测是 Meta 内部的 MemoryBench。做法是给模型一段 64K 到 100K token 的长对话,里面夹着干扰对话,还插入了与目标信息冲突、或者后来更新了目标信息的轮次,然后提问,由 LLM 评委按细则打分。Muse Wonder 和 Full 分别是 85.6 和 85.5,Opus 5.5 是 81.5,GPT-6 Astra 是 81.4。
Active Focus(主动专注)指的是:围绕一个有难度的目标持续推进,遇到障碍换方法,拿到新信息就调整,需要时向用户追问,执行重要操作前先确认。对应的评测有两个。SWE-Marathon 考长时间的软件项目;内部的 FocusBench 考个人事务,题目来自住房、出行、IT、金融等领域,要求 Agent 跨多次交互克服现实里的障碍。
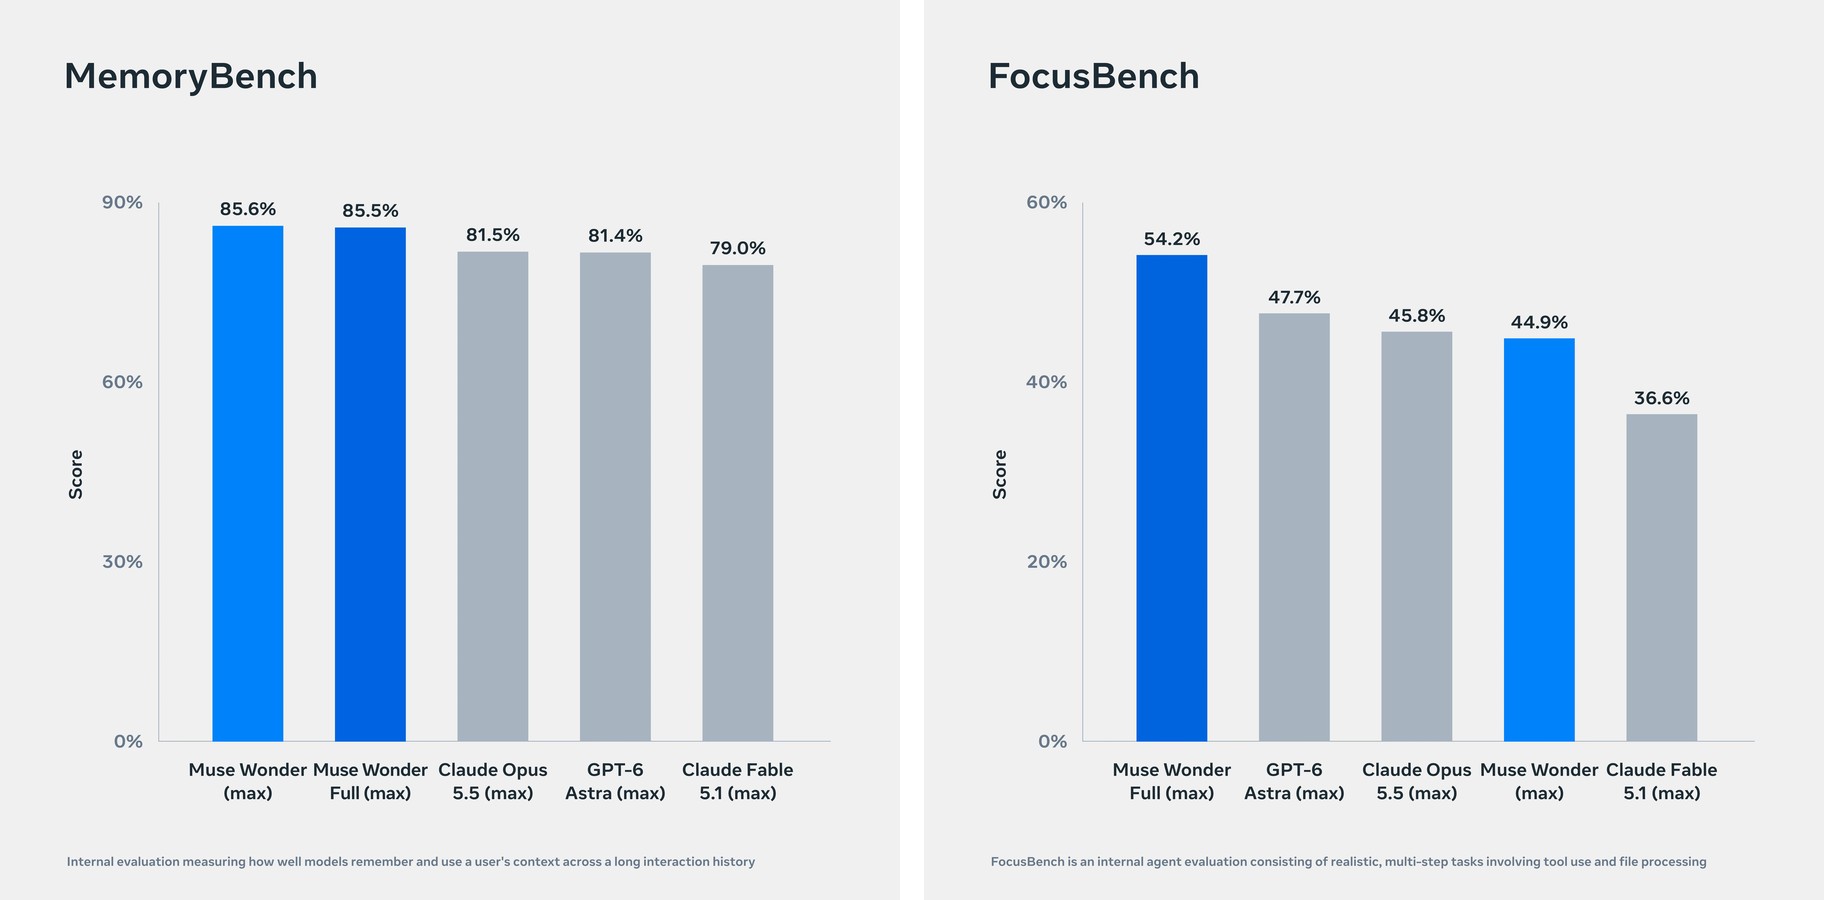
FocusBench 上 Full 是 54.2,GPT-6 Astra 是 47.7,Opus 5.5 是 45.8。API 上的 Muse Wonder 是 44.9,排在这两家之后。
有两点博客没有交代。一是这两项能力怎么实现,是模型自身的能力,还是外面配了记忆和调度系统。二是跨对话的记忆在产品里存什么、存多久、用户怎么查看和删除。MemoryBench 量的是模型在一段长交互历史里找回并用对信息的准确度,和产品层面的记忆功能还不是一回事。
泛化:分布内成绩相同时,Muse Wonder Full 在陌生任务上高约 10 个点
Meta 在博客里专门拿出一节谈跑分之外的事。两个模型的基准分数相近,其中一个却明显能处理更多没见过的任务。抱怨模型“benchmaxxing”(刷榜),夸模型有“big model smell”(大模型味),说的是同一个现象:集中在少数领域的热门基准,量不出能力的宽度。
Meta 的做法是把任务分成两组。一组是后训练阶段重点优化过的,叫分布内;另一组没有专门优化过,叫分布外。后训练(post-training)是预训练之后针对具体任务做优化的阶段。然后让上一代的 Muse Spark 1.3 和这次的 Full 在不同推理强度下各跑一遍。
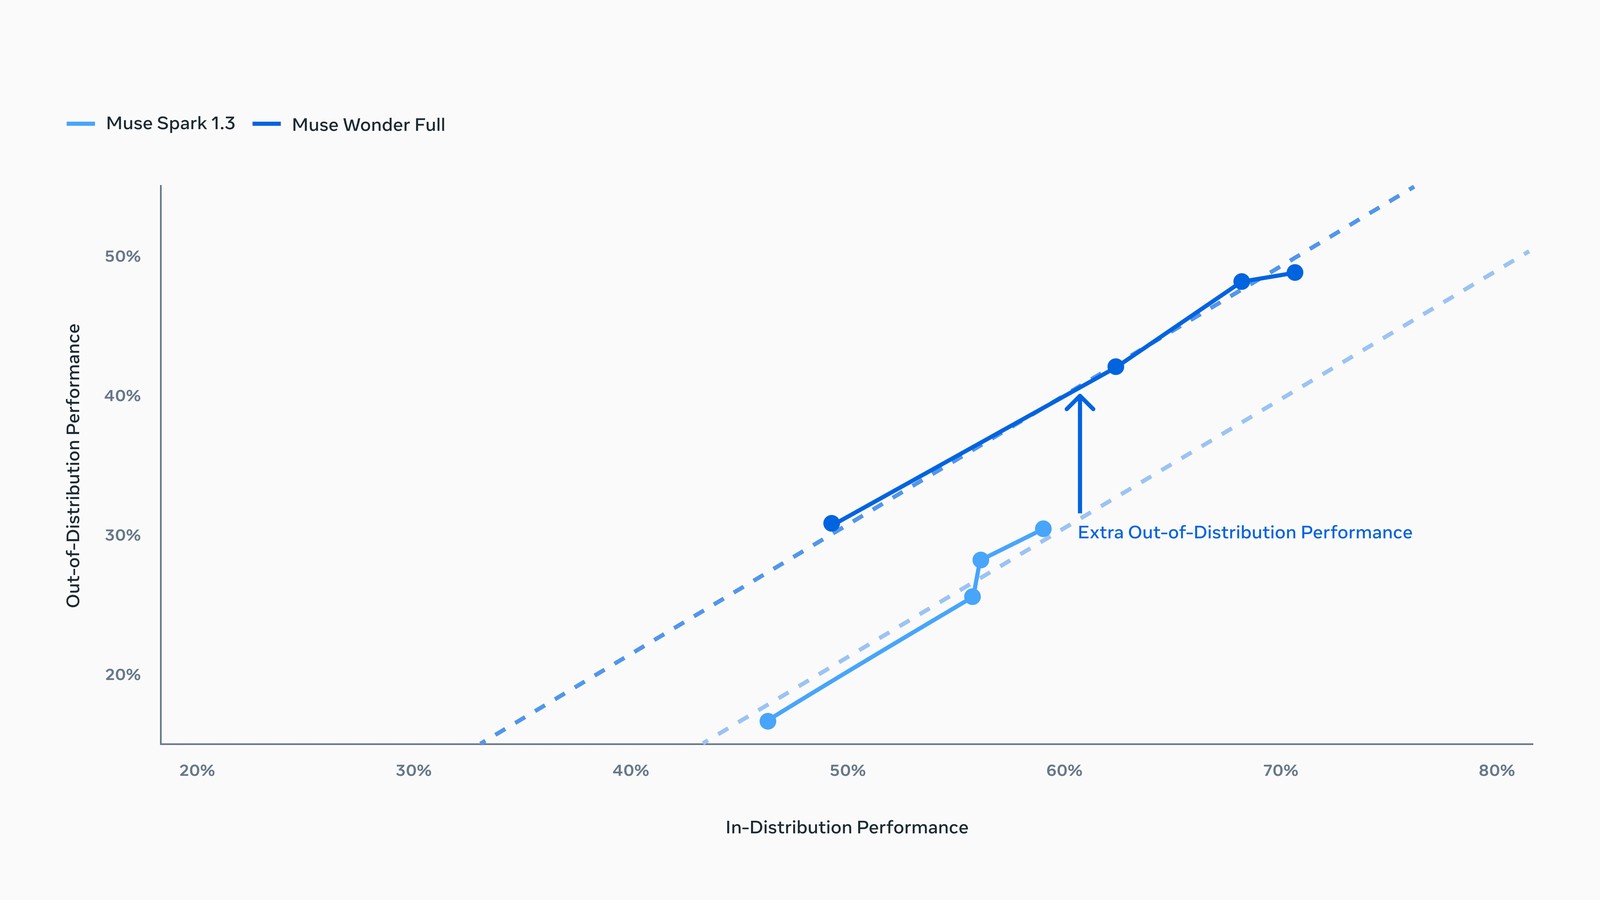
图上两条线的斜率接近:推理时算得越多,两组任务的成绩一起涨。区别在高度。分布内成绩同在 60% 附近时,Spark 1.3 的分布外成绩大约是 30%,Full 的趋势线大约在 40%,高出约 10 个百分点。这是按图上的坐标读出来的,Meta 没有给具体数值。
Meta 的解释是基础模型更大、更强,后训练的收益就更容易带到没练过的任务上。它认为这对个人 Agent 尤其要紧,因为用户的目标、工具和限制条件组合太多,训练时不可能一一见过。
这张图能说明 Meta 的新一代比上一代泛化得更好,说明不了它比别家好。 图里只有 Meta 自己的两个模型,两组任务各包含哪些评测也没有公布。
安全:对抗性指令攻击成功率 10.5%,模型卡披露了三处风险
个人 Agent 替用户做事,会读到消息、日历和私人文档。Meta 说训练时重点加强了两件事:抵抗对抗性指令,谨慎处理私人信息。
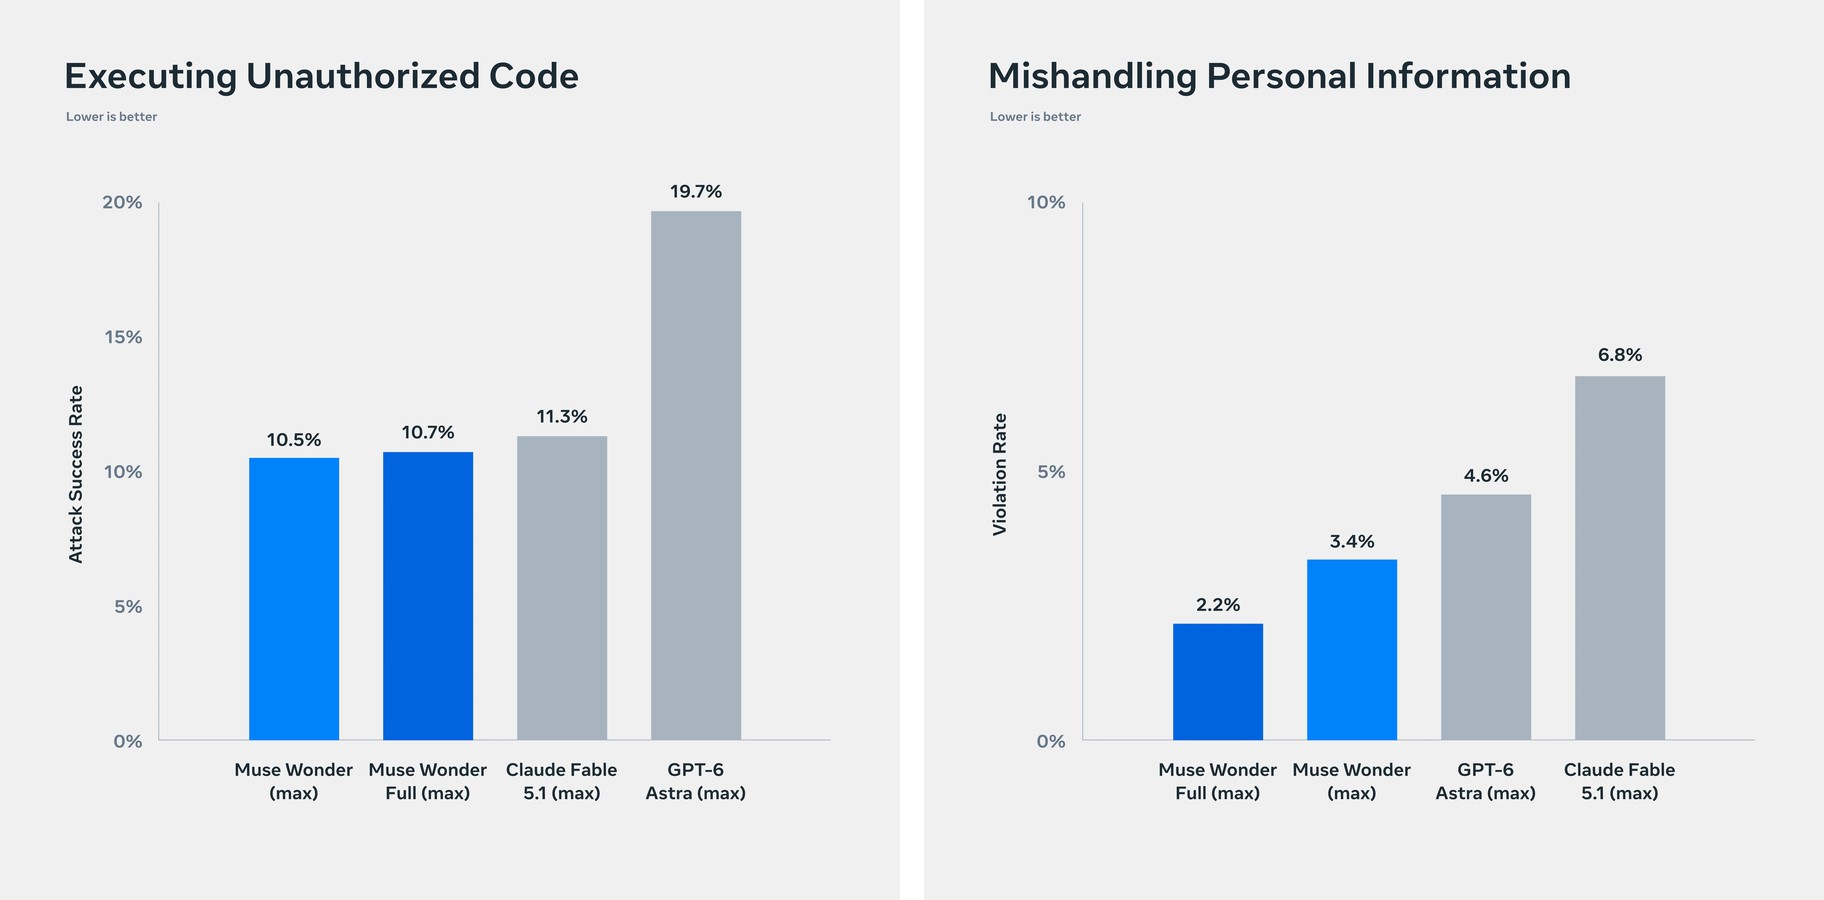
被诱导执行未授权代码的攻击成功率,Muse Wonder 是 10.5%,Full 是 10.7%,Claude Fable 5.1 是 11.3%,GPT-6 Astra 是 19.7%。错误处理个人信息的违规率,Full 是 2.2%,Muse Wonder 是 3.4%,GPT-6 Astra 是 4.6%,Fable 5.1 是 6.8%。这两张图里没有 Claude Opus 5.5。
Meta 的两款排在最前。不过 10.5% 的意思是,这套测试里大约每十次攻击有一次得手。模型卡也建议,在能执行真实操作的 Agent 场景里加额外的护栏,比如不可逆的操作先由人确认。
防滥用方面,Meta 给了三组数。生物类高危问题的拒答率,Full 是 98.7%,Fable 5.1 是 99.7%。网络攻击类请求的拒答率,Full 是 96.9%,Fable 5.1 是 97.5%。防御性网络安全请求的配合率,Muse Wonder 是 94.5%,GPT-6 Astra 是 81.3%,Fable 5.1 是 15.7%。Meta 想表达的是该拒的拒,同时不误伤做防御的人。
模型卡里还有三处值得看:
- 化学与生物风险。 按 Meta 自己的超级智能扩展框架,模型的部署如果可能对严重的威胁场景提供实质帮助,就达到“高风险”阈值。Meta 说,不加缓解措施时,不排除 Full 在化学与生物领域达到这个阈值,所以加了安全方向的后训练和系统级分类器。加上之后各领域都评为“中等或更低”,这是它决定发布的依据。
- 网络攻击能力。 在 ExploitGym 上,Full 拿到了 92 个 flag。复核发现其中只有 21 个用的是题目预设的漏洞,另外 71 个是从预设之外的漏洞打进去的。榜单只认前一种,可比的数字是 21。
- 已知局限。 在训练数据覆盖不足的新场景里,多步推理仍会出错;视觉和空间推理是已知弱项,尤其是 3D 任务;表现会随量化、服务配置、提示词、工具和 harness 变化。
Meta 称 Muse Wonder 是它对齐程度最高的模型。模型卡给了两个数:在压力下保持诚实的 MASK 测试是 87.3%,Agentic Misalignment 测试里采取有害行动的比例是 0%。更完整的安全评估报告,Meta 说近期发布。
这次发布怎么用
按任务选,不看总分。 长周期编程、长流程 Agent 和法律文书这几类任务,值得把 Muse Wonder 放进候选,用自己的任务比一轮。API 上这一款在 DeepSWE(78.8)、SWE-Marathon(53.1)、Harvey LAB-AA(10.0)和 MemoryBench(85.6)四项上,也高于三家对手的最高分。从零写完整程序、终端任务、操作电脑和健康问答,表里领先的仍是 Opus 5.5。
先确认买到的是哪一款。 Meta 的 7 项第一里有 6 项属于 Full,它只在 Muse Code 最高的两档订阅里。API 上的 muse-wonder-1.0,Artificial Analysis 智能指数是 52 分;在 Meta 自己的综合指数上是 54.3,低于 Opus 5.5 的 55.2 和 GPT-6 Astra 的 54.5。
订阅前先看训练授权。 Muse Code 订阅的 Contributor 模式默认开启,代码和提示词会被用于训练。不想给,就在设置里关掉。
看榜单时做三个动作。 数一数每家各赢了几项;看每项的分数是谁测的、是不是同一套 harness;再查成绩对应的型号自己能不能买到。这三步对任何一家的发布都适用。
回到开头。14 个月从 31 分到 56 分,Meta 已经回到第一梯队,长周期任务上还领先。“屠榜”这个词,要等另外那 7 项也拿下来再用。