摘要 Akshay Pachaar 的长文解释了本地大模型为什么慢,以及 Mirai 的开源推理引擎 Uzu 怎么提速。单路生成时,每出一个 token 都要把全部权重从内存读一遍,速度被内存带宽封顶:base M5 上 4-bit 的 Qwen3.5 9B 约 29 tok/s,llama.cpp 和 MLX 实测是 22 和 25。Uzu 用推测解码让主模型一趟确认多个 token,一次起草 16 个,每趟平均落地约 8 个,同一台机器跑到 92 到 117 tok/s。成绩限于 M5 系列芯片和 Mirai 发布的检查点,并且随内容类型变化。
2023 年 8 月,Andrej Karpathy 发过一条长帖,解释 llama.cpp 为什么能在笔记本上跑大模型。里面有句很形象的话:只生成一路文本时,芯片上的计算单元在干等,权重像是“用一根吸管从内存里吸过来的”。两周后他又发了一条,介绍绕开这个瓶颈的办法,叫推测解码(speculative decoding),原话是“this one weird trick”。
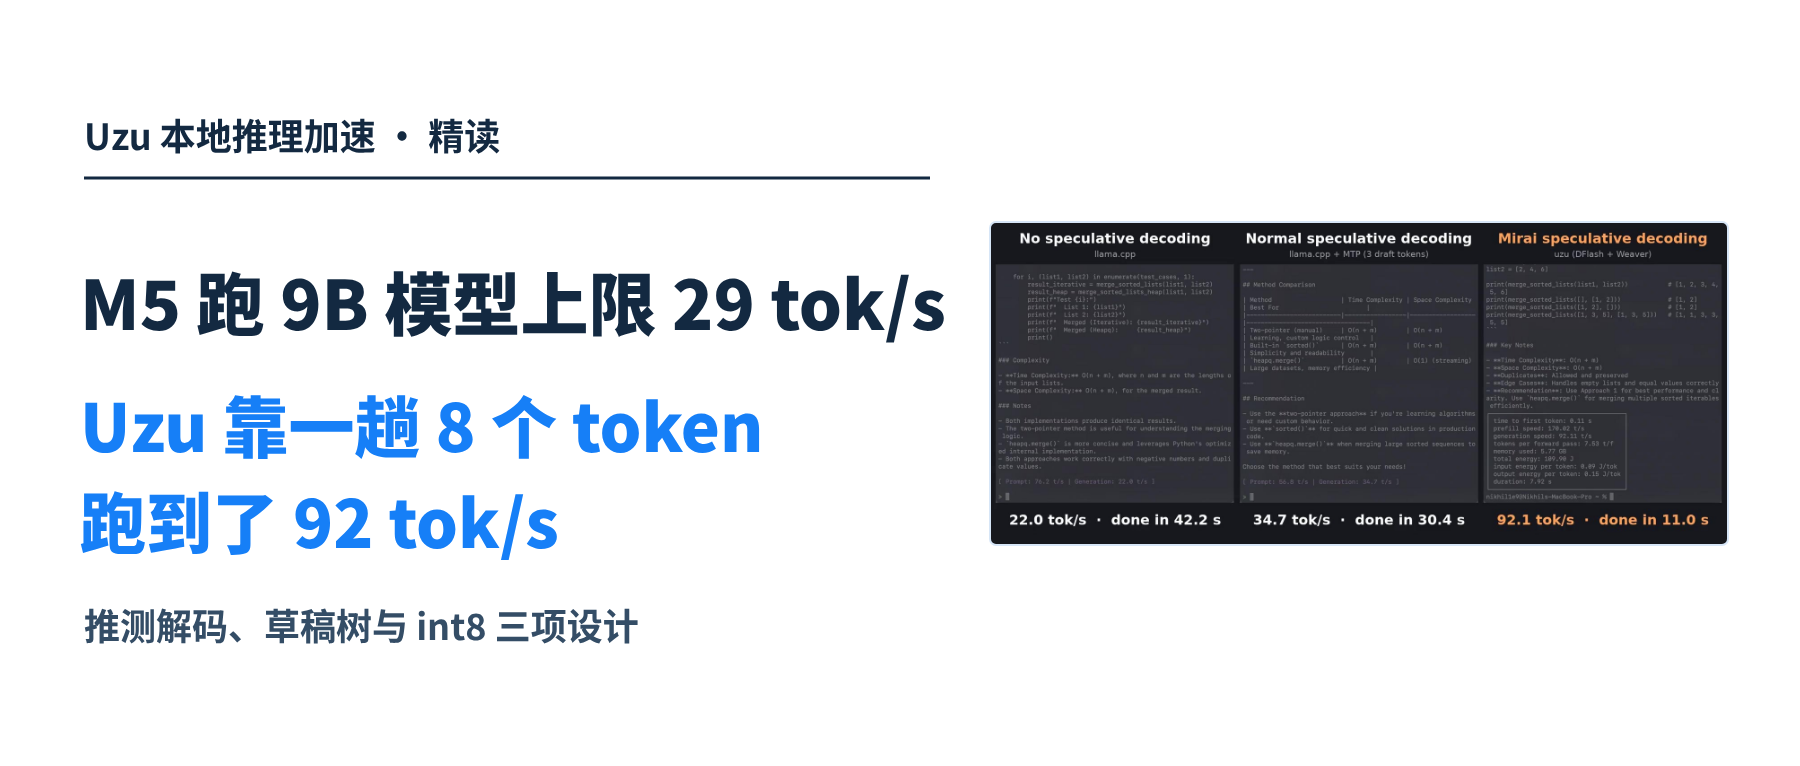
三年过去,这个瓶颈还在。Daily Dose of Data Science 的联合创始人 Akshay Pachaar 10 月 8 日发了一篇长文,在一台 16 GB 内存的 base M5 MacBook Pro 上算了笔账:4-bit 量化的 Qwen3.5 9B,每秒最多出 29 个 token,llama.cpp 和 MLX 实测是 22 和 25。同一台机器、同一个模型,Mirai 开源的推理引擎 Uzu 跑出了 92 到 117。
内存并没有变快。下面按这篇长文的顺序,看 29 这个上限怎么算出来,Uzu 用哪三项设计绕过去,以及这组数字在什么条件下成立。
内存带宽:base M5 跑 4-bit Qwen3.5 9B,上限约 29 tok/s
大模型推理分两个阶段。Prefill 读提示词,所有 token 可以并行处理;Decode 写回答,每出一个 token,都要把模型完整算一趟。本地跑模型觉得慢,慢的是 Decode。
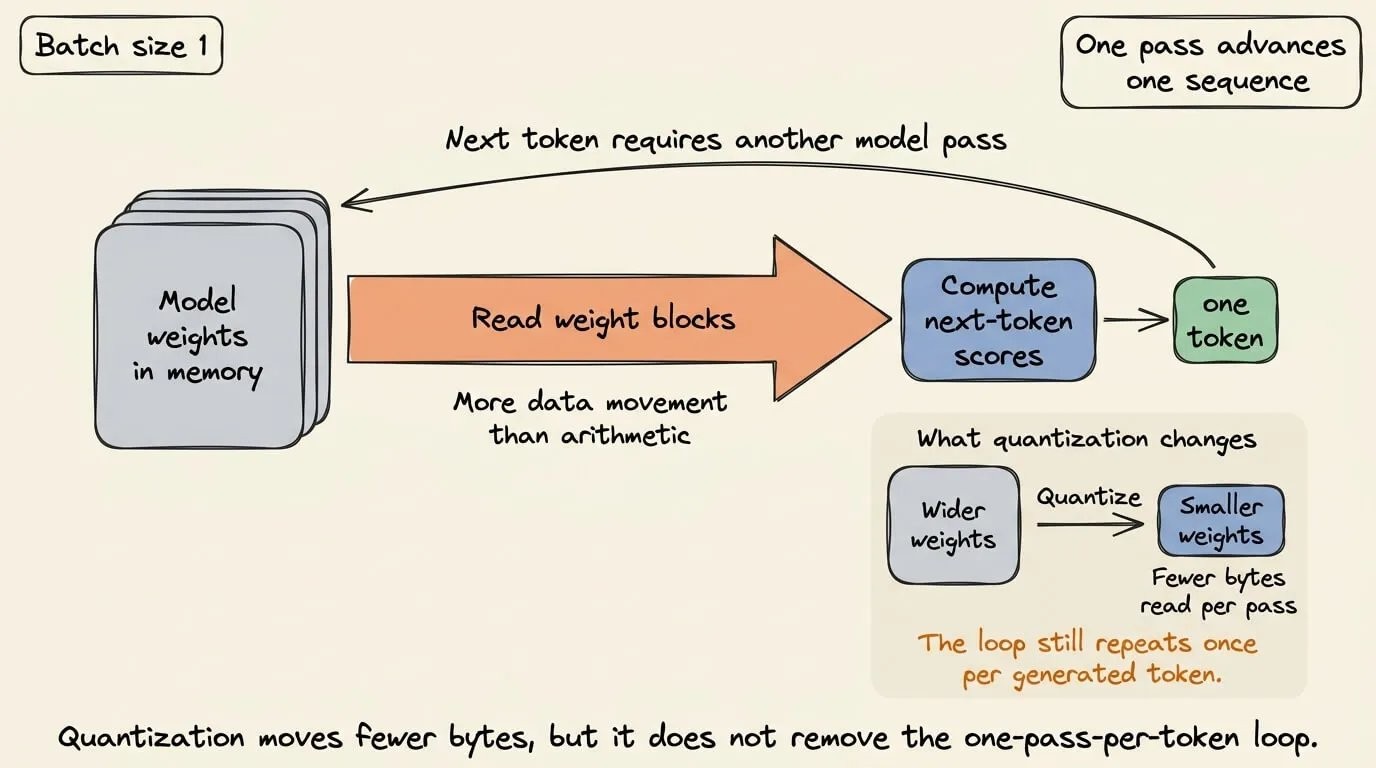
单路生成(batch size 1)时,一趟计算只推进一条序列。每出一个 token,芯片要把全部权重从内存读进 GPU 一遍,每个权重大致只做一次乘加。算得快,读得慢,GPU 常常算完了手头的,下一块权重还没送到。速度于是由内存带宽决定,和算力关系不大。
云端没有这个烦恼:服务器可以把很多用户的请求拼成一批,读一遍权重同时推进许多条序列。本地设备上只有一条序列,拼不了批。
这就有了一个用除法能算出来的上限。base M5 的内存带宽是 153 GB/s,4-bit 的 Qwen3.5 9B 约 5.2 GB:
153 ÷ 5.2 ≈ 29 token/秒
GPU 再快也过不了这条线。实际的引擎每趟还要读历史 token 的缓存等数据,会再低一些。作者在这台机器上用同一条提示词实测,llama.cpp 是 22.0 tok/s,MLX 是 25.1 tok/s。
量化(把权重存成更少的位数)是最常见的优化。它让每趟要读的字节变少,上限随之抬高,但循环没变,还是一趟一个 token。4-bit 量化已经是本地推理的标配,再想快,得让一趟计算产出不止一个 token。
Speculative decoding:草稿模型先猜,主模型一趟验证多个 token
推测解码在主模型旁边加一个小的草稿模型(draft model)。草稿模型便宜地往前猜几个 token,主模型把这几个位置放进同一趟里验证,接受其中连续正确的前缀,从第一个不认可的位置接着往下写。
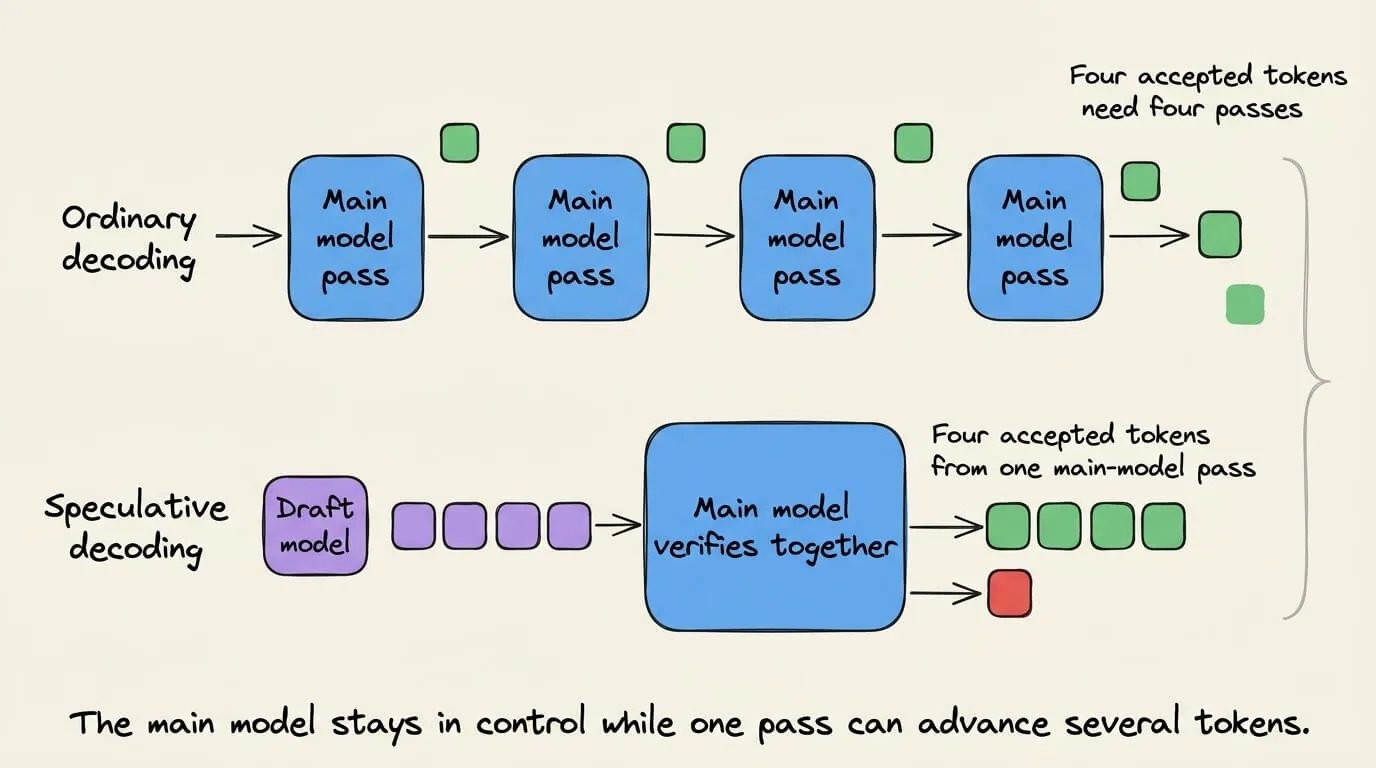
举个例子:草稿给出 5 个 token,主模型认可前 4 个。这一趟让序列前进了 5 个 token,其中 4 个是被接受的草稿,第 5 个是主模型自己在那个位置给出的。普通解码要跑 5 趟。
最终输出仍然由主模型决定。按原文的说法,只要接受规则正确,输出的概率分布和主模型逐个生成时一致,草稿模型只影响速度。
一趟验证多个位置,比只算一个 token 费算力。这笔买卖在本地划算,靠的是上一节那个事实:算力本来就闲着。推测解码把闲着的算力花出去,换来更少的读权重趟数。这个办法出自 Google 和 DeepMind 研究者的论文,Karpathy 那条帖子引的就是它们。
代价在接受率上。草稿越长,一趟要验证的越多,前面错一个、后面全部作废的机会也越多。所以常见的做法都保守:MTP(multi-token prediction,训练时加进模型里的几个额外预测头)一次只猜 3 到 4 个 token,llama.cpp 的 MTP 模式用的就是它。
Uzu 在 M5 上把草稿预算开到 16 到 32 个 token,文中测试的 Qwen3.5 9B 用的是 16。要让这么长的草稿不白猜,它在起草、验证和数值格式上各做了一项设计。
DFlash+Weaver:16 个位置各猜各的,怎么连成一句话
长草稿要起得快,Uzu 用的是并行草稿模型 DFlash:一次算出后面每个位置各自最可能的候选。
并行的毛病是各猜各的。每个位置都看得到已有的上下文,却看不到前面几个位置选了什么。原文的例子:提示以“She went to the store to buy”结尾,四个位置可能分别选出 a、few、of、milk,单看都合理,连起来是“a few of milk”。第二个词就对不上,后面全部作废。草稿越长,这样的机会越多,接受率跟着往下掉。
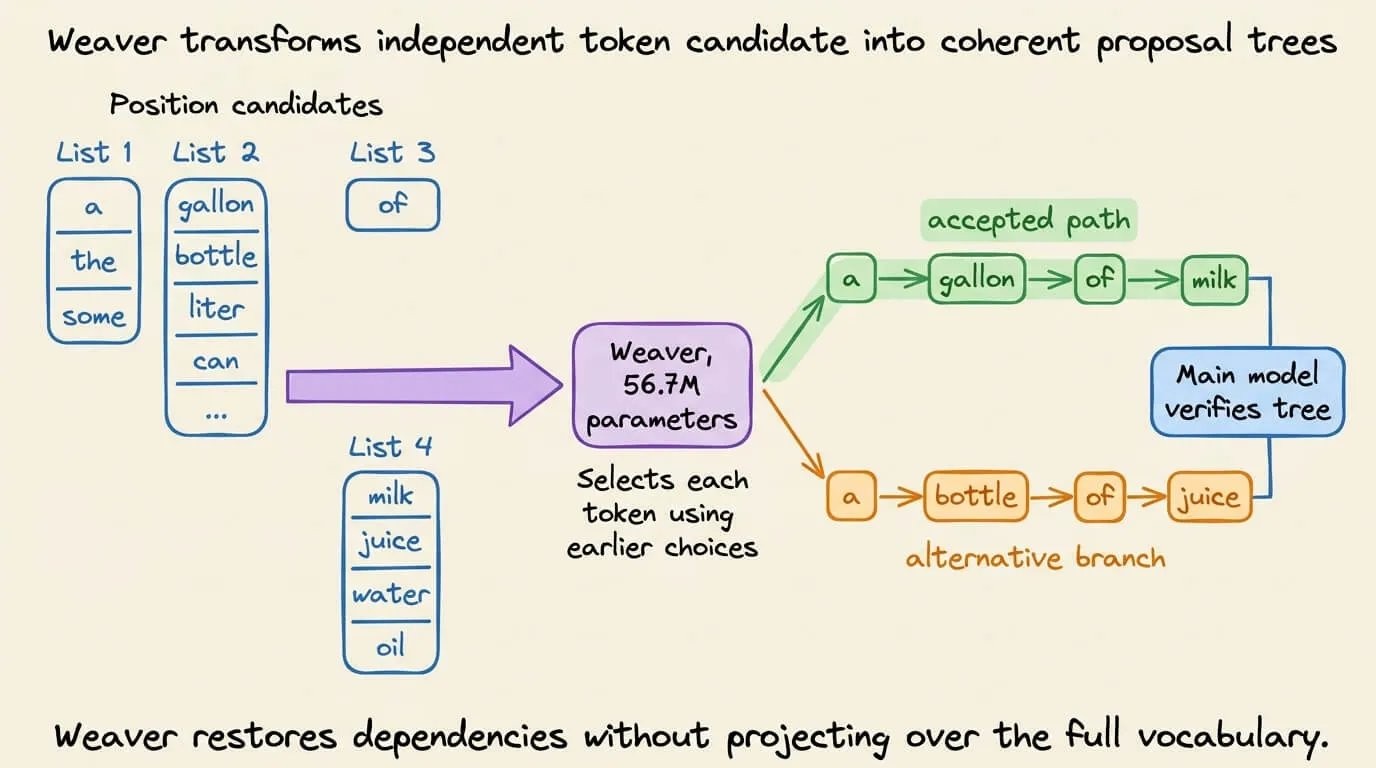
Weaver 是补这个缺口的小模型,出自论文《Trees from Marginals》,论文里的版本有 5,670 万参数。DFlash 先给每个位置出一份候选短名单,Weaver 再按顺序从名单里挑,每挑一个都参考前面已经挑定的,于是得到“a gallon of milk”。它只在短名单里选,不在整个词表上做投影。
Weaver 还能同时留下几条说得通的路径,比如另一条“a bottle of juice”,合起来是一棵草稿树。主模型验证整棵树,接受其中最长的那条正确路径。树的形状随内容变:代码这类好猜的内容,树又长又窄;开放式写作,树短而分叉多。
论文报告的成绩是比逐 token 解码快 4.37 倍,比优化过的 DFlash 基线再高 24.7%。原文特意注明,这是在 CUDA 和 SGLang 上做的研究实验,不能当作 Uzu 的成绩。还有一点原文没有提:论文的四位作者都在 Mirai 那篇实现说明的署名里,这是同一个团队的工作。
Rollback-free 验证:Gated DeltaNet 的状态只提交一次
草稿树带来一个新问题,出在 Qwen 的模型结构上。注意力层给每个历史 token 留一份缓存,只增不改。Qwen3.5 和 Qwen3.6 里另有一种 Gated DeltaNet 层,它把看过的内容压进一个固定大小的状态,每接受一个 token,状态就被改写一次。Qwen3.5 9B 的 32 层里,24 层是这种层。
草稿树的每条分支都会把状态改成不同的样子。验证一条分支时如果直接改了状态,验下一条之前就得先恢复原状。树一大,反复保存、恢复的内存操作和重复计算,会把推测解码省下的时间吃回去。
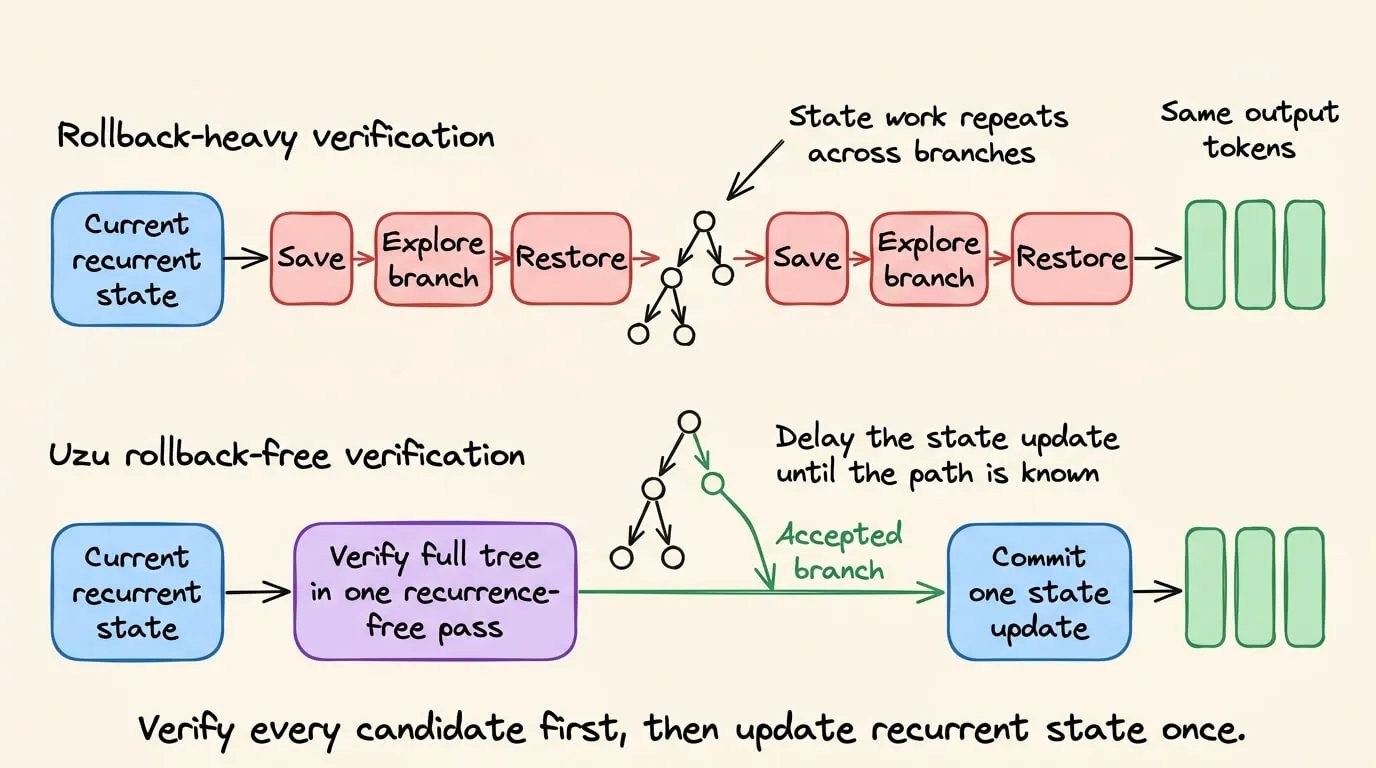
Uzu 把“验证”和“提交状态”分开。验证时,一次算出整棵树上每个候选需要的值,不动正在使用的状态;主模型选定路径后,只对被接受的那几个 token 提交状态更新。Mirai 的实现说明把它叫作 rollback-free tree verification,由专门为 Metal 写的 GPU 内核完成。没有错误的更新,也就没有什么需要回滚。
int8 与 Hadamard 变换:数值格式跟着 M5 的硬件走
第三项设计在数值格式上。Mirai 给同一个模型发布两档检查点:Mirai-M 用 4-bit 非对称整数量化,体积小;Mirai-L 用 8-bit 对称量化,精度高。两档都是整数格式,这是有意的选择。
原因在 M5 的硬件。和更早的 Apple GPU 不同,M5 在 int8(8 位整数)精度下算术吞吐最高,它的每个 GPU 核心里都有一个叫 Neural Accelerator 的矩阵单元。Uzu 在运行时把激活值(层与层之间传递的中间结果)也量化成 8 位,矩阵乘法两边都是整数,验证这一步就能走硬件加速的 int8 通路。原文配图引的是 Mirai 的数字:这条通路的矩阵乘法吞吐是浮点通路的 2 倍。
这种矩阵单元要矩阵够大才划算。一次验证 16 个候选,等于给它 16 行的活;一趟只算 1 个 token,就只有 1 行。长草稿和整数格式是配套设计的。
精度低了,舍入误差会变大。分组量化时,一组数值共用一个缩放比例,这个比例要照顾组里绝对值最大的那个;组里一旦有个离群的大值,其余小值能用的整数档位就很少。Uzu 在量化前做一次块对角的随机 Hadamard 变换(block-diagonal Random Hadamard Transform):把每 32 个值混在一起,一个大的离群值被摊成许多中等大小的值。变换完全可逆,除了舍入之外不改变模型算出的结果。32 这个块大小对应 Apple GPU 内核的 SIMD 宽度,一组线程正好处理一块。
实测:base M5 上 22.0 → 34.7 → 92.1 tok/s
作者在那台 base M5、16 GB 内存的 MacBook Pro 上,用同一个 Qwen3.5 9B、同一条提示词“Write a python function to merge two sorted lists”跑了三种配置,都是 4-bit 权重。
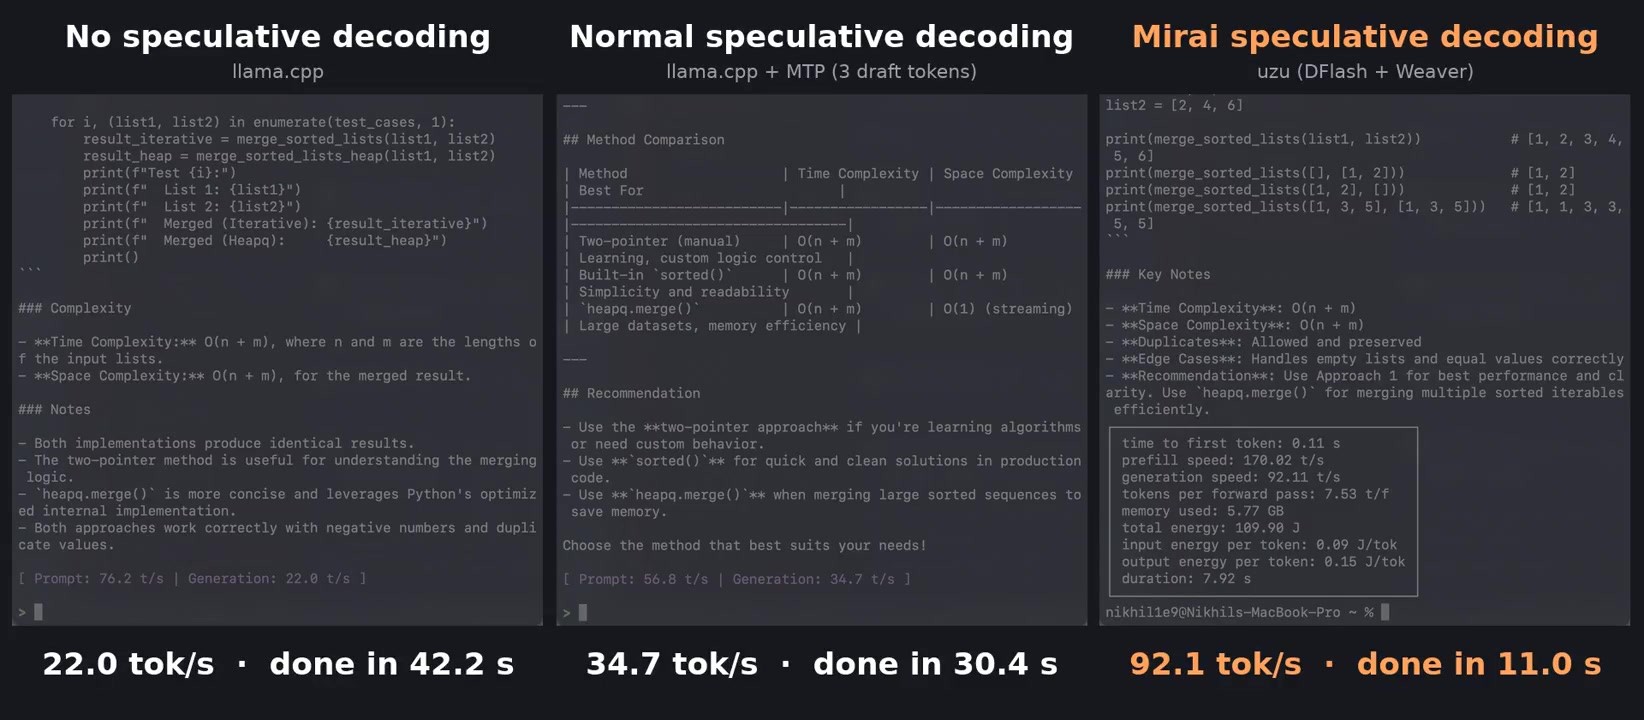
不开推测解码的 llama.cpp 是 22.0 tok/s;打开 MTP、一次起草 3 个 token,是 34.7;Uzu 是 92.1。作者说多次运行 Uzu,速度在 92 到 117 之间。
Uzu 的命令行会打印每趟前向计算平均产出几个 token。普通解码这个数恒为 1.00;文中贴出的一次运行是 8.39,对应生成速度 98.10 tok/s,多次运行在 7.5 到 9.6 之间。
把这两个数相除,能看出时间花在了哪:98.10 ÷ 8.39 ≈ 每秒 11.7 趟,而 llama.cpp 逐 token 解码是每秒 22 趟。按这个推算,Uzu 的一趟(含起草和验证)耗时接近普通解码的两倍,但一趟落地 8 个 token。内存带宽的限制原封未动,变的是每读一遍权重的产出。
更大的模型上,原文引的是 Mirai 自己公布的测试:Qwen3.6 27B 的 Mirai-M 检查点(15.6 GB),机器是 M5 Max、128 GB 内存,9 月 16 日测得,原文注明未经独立复现。Uzu 开推测解码是 114 tok/s,MTPLX 55,llama.cpp 30,MLX 26;Uzu 不开推测解码是 35.54。也就是说,不开推测时 Uzu 只比 llama.cpp 快不到两成,那 3.2 倍来自推测解码。
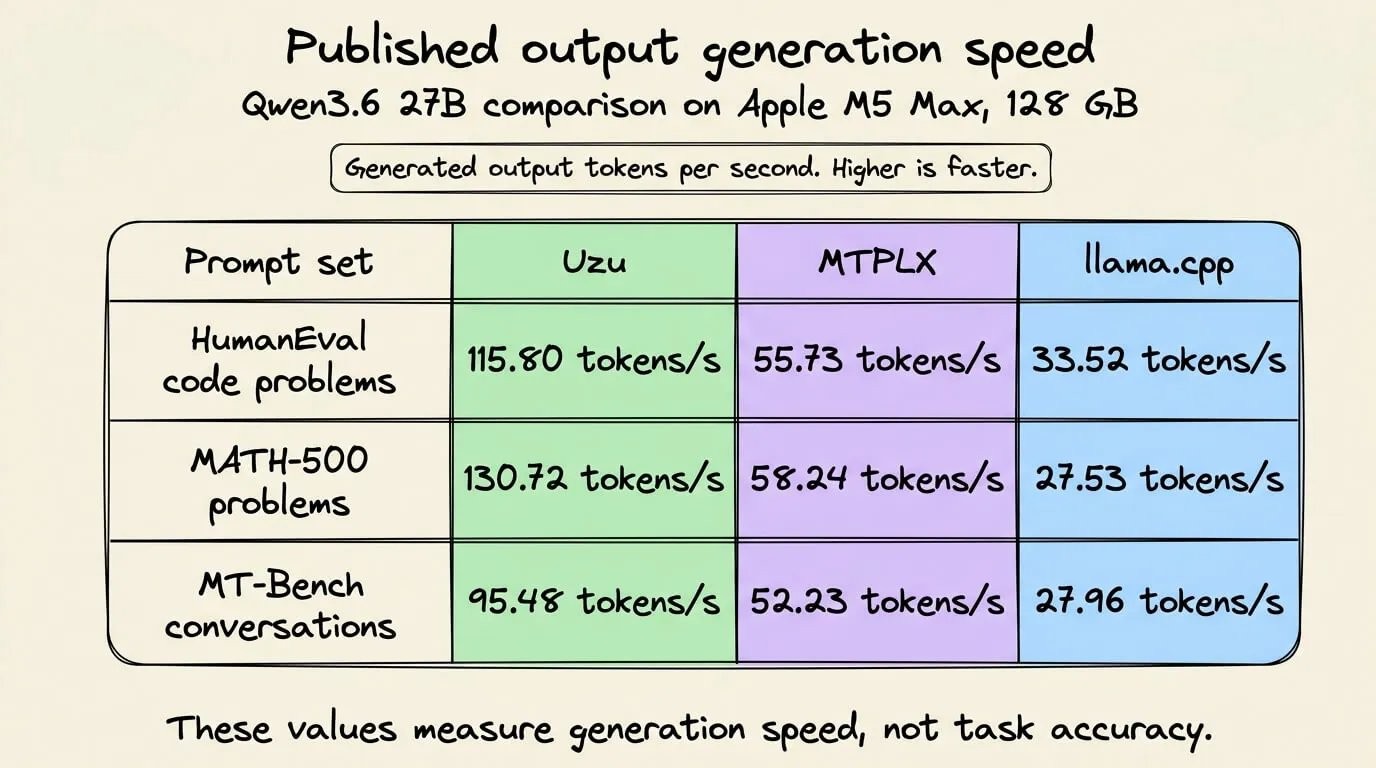
按题型拆开,差别很明显:数学题 130.72 tok/s,代码题 115.80,日常对话 95.48。代码和数学里可预测的续写多,对话留给草稿模型的把握少。原文的总结是,推测解码的速度是工作负载的属性,不是模型的固定参数。
这组数字已经有了新版本。Mirai 的模型页在 10 月 11 日换成了 21 个数据集的混合测试,M5 Max 上的推测解码成绩变成:Uzu 116.42,MTPLX 58.02,oMLX 48.74,llama.cpp 39.00。新版里 llama.cpp 用的是带 MTP 头的模型文件,它逐 token 解码的成绩是 30.55,和旧版的 30 接近。照新版算,Uzu 对 llama.cpp 的领先是 3.0 倍,原文引用的旧版是 3.8 倍。
这组数字怎么用
上限自己能算。 内存带宽除以模型文件大小,就是逐 token 解码的上限。挑本地模型和机器时,这个除法比看芯片算力管用:同一台机器上,模型文件大一倍,上限就低一半。
只有 M5 系列能开推测解码。 文中这份检查点的推测配置只列了 M5、M5 Pro、M5 Max。在 M1 到 M4 的 Mac 上,同一条命令不带草稿模型,每趟仍是 1.00 个 token。模型也得用 Mirai 发布的检查点;Mirai 9 月初发布这项功能时,说的是先支持 Qwen3.6 27B。
比的是整条引擎。 三家用的量化文件不一样:Uzu 是 Mirai-M,MLX 是自己的 4-bit 转换,llama.cpp 是 Q4_K_S。Mirai 的命令行没有关掉推测解码的开关,所以这组对比分不出多少来自 DFlash+Weaver、多少来自量化和内核,原文自己也这样说明。最接近同引擎对照的,是 llama.cpp 开和不开 MTP 那一组:22.0 对 34.7。
速度之外要看质量。 原文的图表只量速度。Mirai 的模型页另外给了量化质量的对比,指标是和未量化模型输出分布的 KL 散度,越低越接近原模型:在 Qwen3.6 27B 上,Mirai-M 是 0.012,llama.cpp 的 Q4_K_S 是 0.011,MLX 的 4-bit 是 0.034。这是 Mirai 用自有数据集测的自报结果。
测试提示词是最有利的一类。 base M5 上的 92 到 117,来自一条写 Python 函数的短提示词,约 20 个 token。长上下文、聊天类内容、机器发热之后的速度,原文都没有测。它的结论里也提醒:要用自己产品里的真实请求来测,并且同时量质量。原文后半部分给了完整的复测命令和测试纪律,整理在文末附录。
回到开头那根吸管。吸管没有变粗,Uzu 做的是每吸一口多落地几个 token。在 base M5 上用 Qwen3.5 9B 写一段代码,它是 llama.cpp 的 4 倍左右;换芯片、换模型、换成聊天,要自己测过才知道。
附录|在自己的 Mac 上复测:原文给的命令和测试纪律
以下命令和输出照录自原文,供手边有 M5 机器的读者自己验证;正文第 6 节的数字就是这样测出来的。
一条命令看速度。 Mirai 的命令行通过 Homebrew 安装,第一次运行会下载模型:
brew install mirai

mirai --model trymirai/Qwen3.5-9B-M \
  -m "Write a python function to merge two sorted lists"
原文环境是 Mirai CLI 0.6.1、macOS 26.6.2、base M5、16 GB 内存。回答结束后打印的统计(原文贴出的一次运行,节选):
time to first token: 0.12 s
prefill speed: 161.11 t/s
generation speed: 98.10 t/s
tokens per forward pass: 8.39 t/f
memory used: 5.77 GB
total energy: 114.90 J
duration: 7.36 s
读数时看两行:generation speed 是 Decode 阶段的速度,tokens per forward pass 是主模型每趟平均产出的 token 数,普通解码恒为 1.00。prefill speed 在这里参考意义不大,提示词只有约 20 个 token。
三个引擎用同一个客户端比。 Uzu、MLX LM 和 llama.cpp 都能起一个 OpenAI 兼容的本地服务,分别占 8000、8001、8002 端口:
mirai server --model trymirai/Qwen3.5-9B-M --port 8000 --no-prefix-cache

mlx_lm.server --model mlx-community/Qwen3.5-9B-4bit --port 8001

llama-server -hf unsloth/Qwen3.5-9B-MTP-GGUF:Q4_K_S \
  --alias qwen3.5-9b-q4-k-s -ngl 99 -fa on -c 8192 -np 1 --port 8002
几个参数的用意:
--no-prefix-cache:Uzu 默认会缓存处理过的提示词前缀,重复请求能跳过大部分 Prefill;关掉它,每次请求才做全量计算。-c 8192:不加的话 llama.cpp 会按模型的 262K 上下文预留内存,16 GB 的机器放不下。-np 1:只开一个并发槽位。要打开 llama.cpp 的 MTP 起草,再加--spec-type draft-mtp --spec-draft-n-max 3。
原文另给了一个只用 Python 标准库的测速脚本:固定同一条提示词,temperature 设为 0,最多输出 1,024 个 token,关闭思考,流式接收,记录首 token 时间、总时长和 Decode 速度。
原文的测试纪律:
- 一次只开一个服务,内存里只留一份模型,不让两个引擎抢内存带宽。
- 每个引擎跑两次,第一次含预热,丢掉,记第二次。
- 固定机器和电源模式、提示词和对话模板、输出 token 上限、采样设置、预热次数和测量次数。
- 客户端测到的速度包含 HTTP 流式传输,会比引擎自己日志里的略低;客户端的数字只和客户端的数字比。