摘要 MiniMax 10 月 19 日发布 M3.1 Flash,匿名走红一个月的 Space Bunny 是它的早期版本。API 标价每百万 token 输入 0.15 美元、输出 0.60 美元,和 DeepSeek V4.1 Flash 1017 的闲时价相同。“Agent 国产第一”指电脑操作类的 OSWorld 2.0 和 ALE 两项,仍低于 Opus 5 和 GPT-5.6 Sol;编程评测 DeepSWE 是 73.7%,低于 DeepSeek 的 77.0%。“比 Opus 5.5 便宜 88 倍”出自一位开发者做落地页的单次测试,约 30 倍来自单价,约 3 倍来自用量。Agent 每一步都要重读前文,账单大头是读缓存,比单价更该看的是做完一件事的总账。
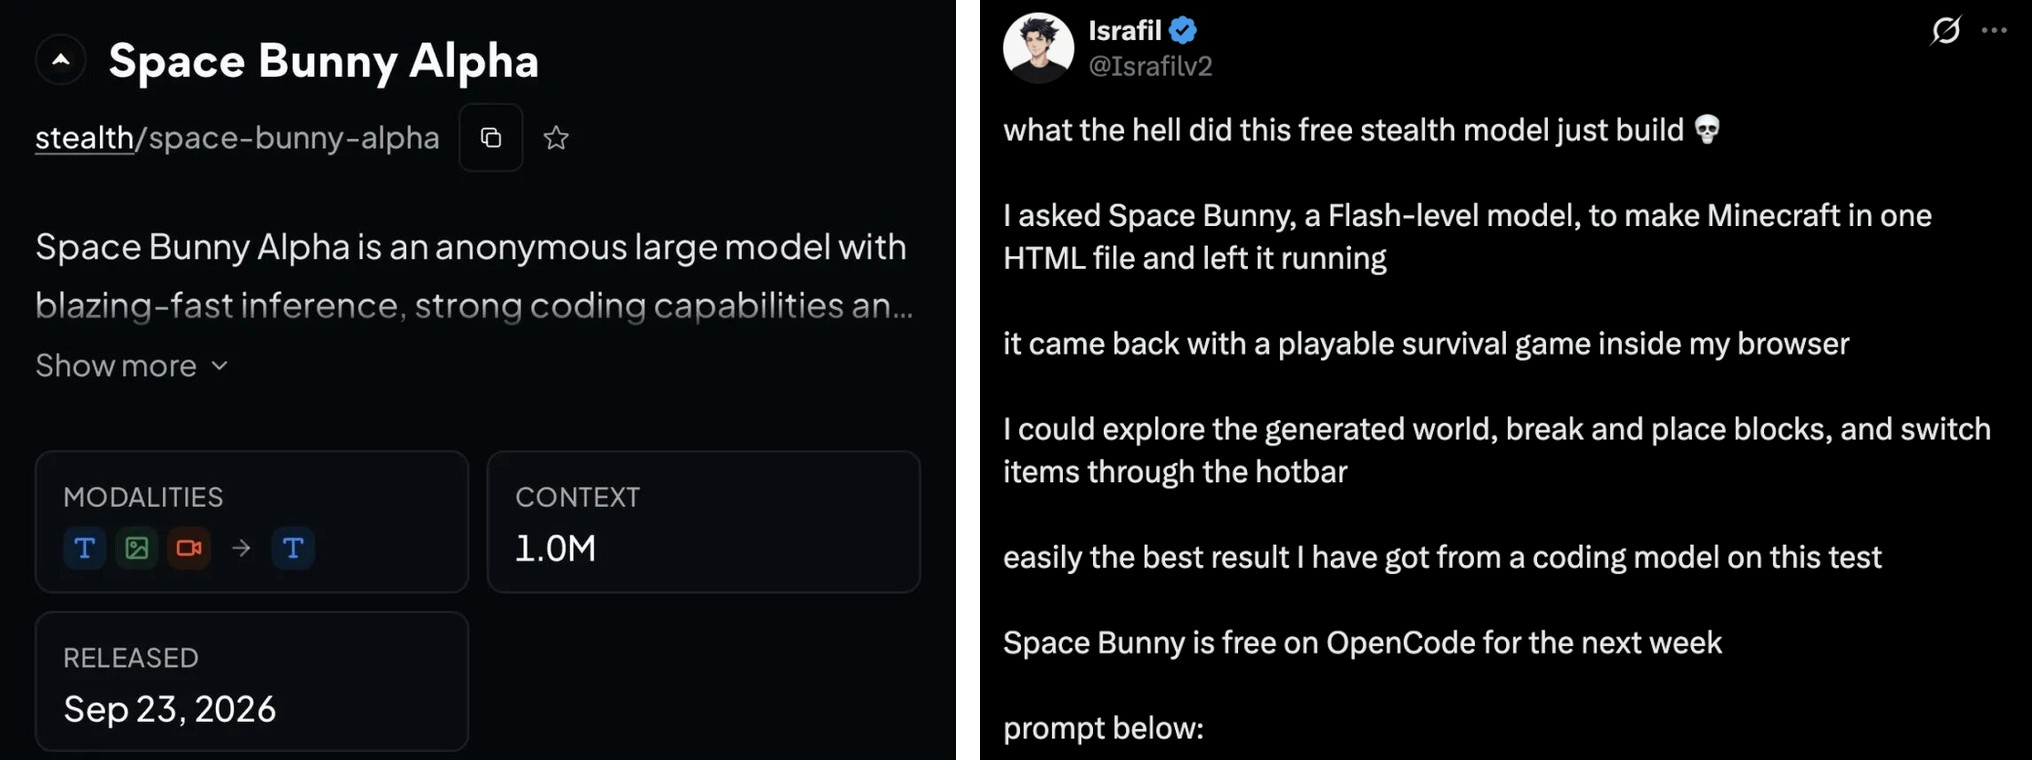
9 月 23 日,一个叫 Space Bunny 的匿名模型悄悄上线,简介写着“推理极快、编程能力强”,网友叫它“太空兔”。开发者 Israfil 让它用一个 HTML 文件做《我的世界》,放着它自己跑,回来时浏览器里已经有一个能挖方块、放方块、用快捷栏切换物品的生存游戏。10 月 19 日,MiniMax 发布 M3.1 Flash,同时认领了太空兔:它是 M3.1 Flash 的早期版本,匿名期间处理了超过 200 万亿 token(模型读写文字的计量单位,也是按量计费的单位)。Flash 是各家模型里主打便宜、快的那一档。
发布当天,Together AI 的开发者体验负责人 Hassan 发帖说,他让 M3.1 Flash 和 Claude Opus 5.5 各做一张硬件发布会的落地页,MiniMax 花了 0.014 美元,Opus 花了 1.22 美元,“便宜 88 倍”。这个倍数和“Agent 国产第一”是这次发布传得最广的两句话。Agent 指能自己调用工具、一步步把活干完的 AI,M3.1 Flash 主打的就是这类任务。下面逐一看这两句话在什么条件下成立,以及一个便宜模型干一件活,账单到底由什么决定。
“Agent 国产第一”:第一在 OSWorld 和 ALE
Agent 和聊天不同:它要打开软件、读工具返回的结果、决定下一步,一件事往往走几十上百步。Flash 档过去多用来问答和补全代码,MiniMax 这次想证明 Flash 也能干这种长活。官方对比表放了 15 项评测,对手是 DeepSeek、Kimi、GLM 的国产模型,以及 Opus 5 和 GPT-5.6 Sol 两个海外旗舰:
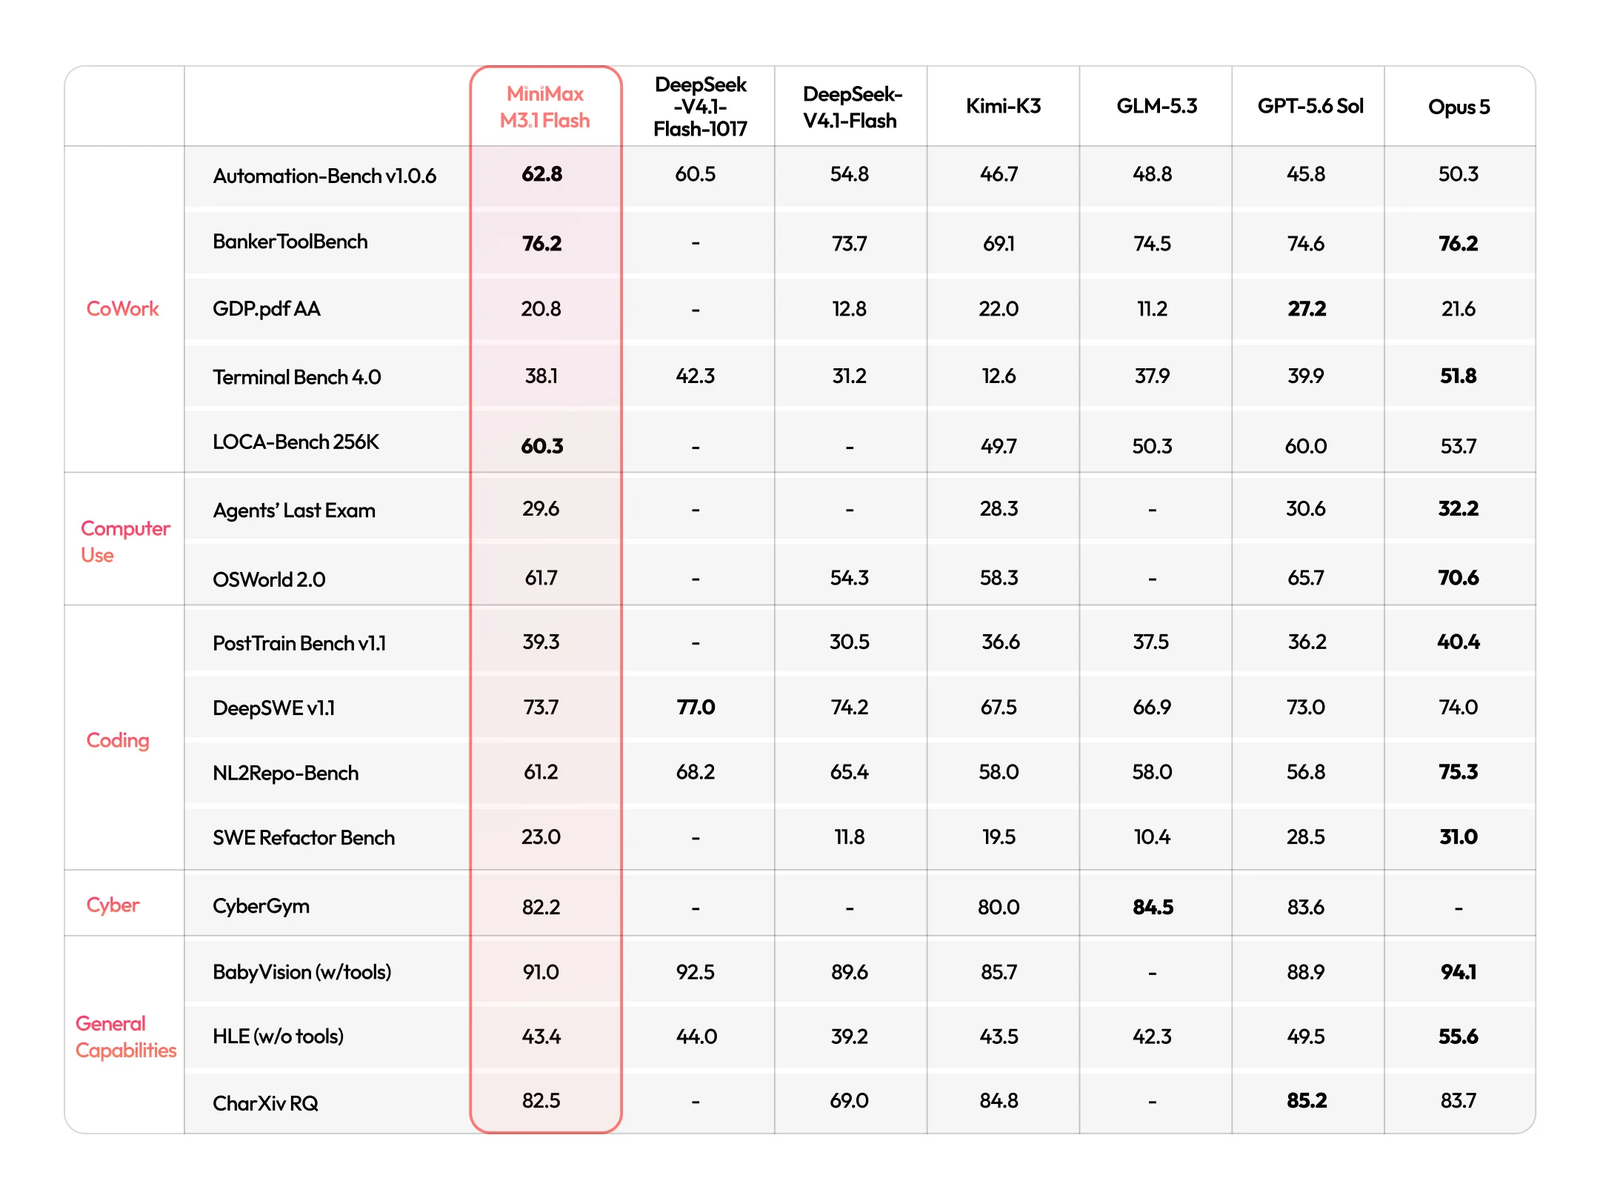
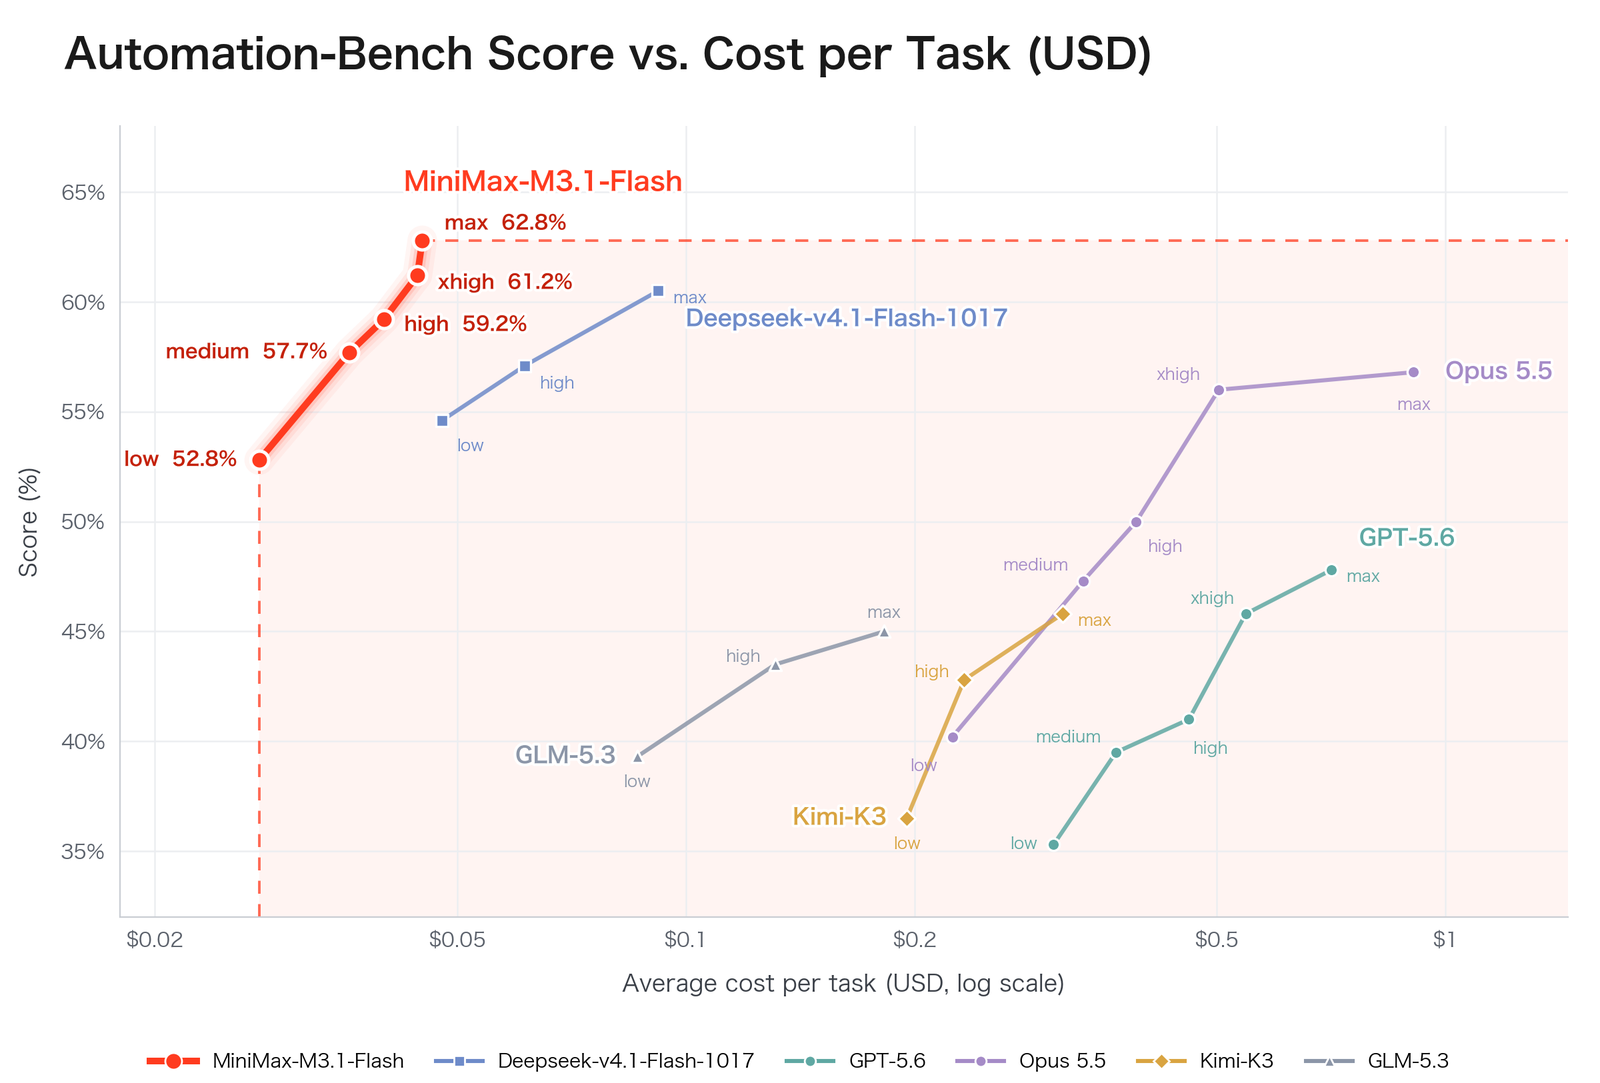
“国产第一”指的是电脑操作类的两项:OSWorld 2.0 考在真实桌面里操作软件,M3.1 Flash 得 61.7 分;Agents' Last Exam(ALE)考调用工具、查资料完成真实专业工作,它的通过率是 29.6%。两项都高于表里的 Kimi-K3 等国产模型,但低于 GPT-5.6 Sol(65.7、30.6)和 Opus 5(70.6、32.2),而这两个还不是海外最新的旗舰;10 月 17 日刚发布的 DeepSeek V4.1 Flash 1017 这两项还没有成绩。更亮眼的是 Zapier 出题的 Automation-Bench,让 AI 在销售、客服、财务等 SaaS 系统(按月订阅的在线业务软件)之间跑完 600 个真实业务流程,M3.1 Flash 得 62.8 分,是整张表的最高分。
编程是它的短板。DeepSWE 给模型一个真实代码库,让它自己定位问题、改代码、跑测试,M3.1 Flash 是 73.7%,DeepSeek V4.1 Flash 1017 是 77.0%;终端操作 Terminal Bench 4.0 也是 DeepSeek 高,42.3 对 38.1。第三方评测机构 Artificial Analysis 的综合智能指数(把多项评测加权成一个总分)上,M3.1 Flash 是 43 分,在国产模型里排第七;但在该机构独立跑的 AutomationBench 上,M3.1 Flash 的 72.5% 排所有模型第二,只低于 Gemini 4 Argon。
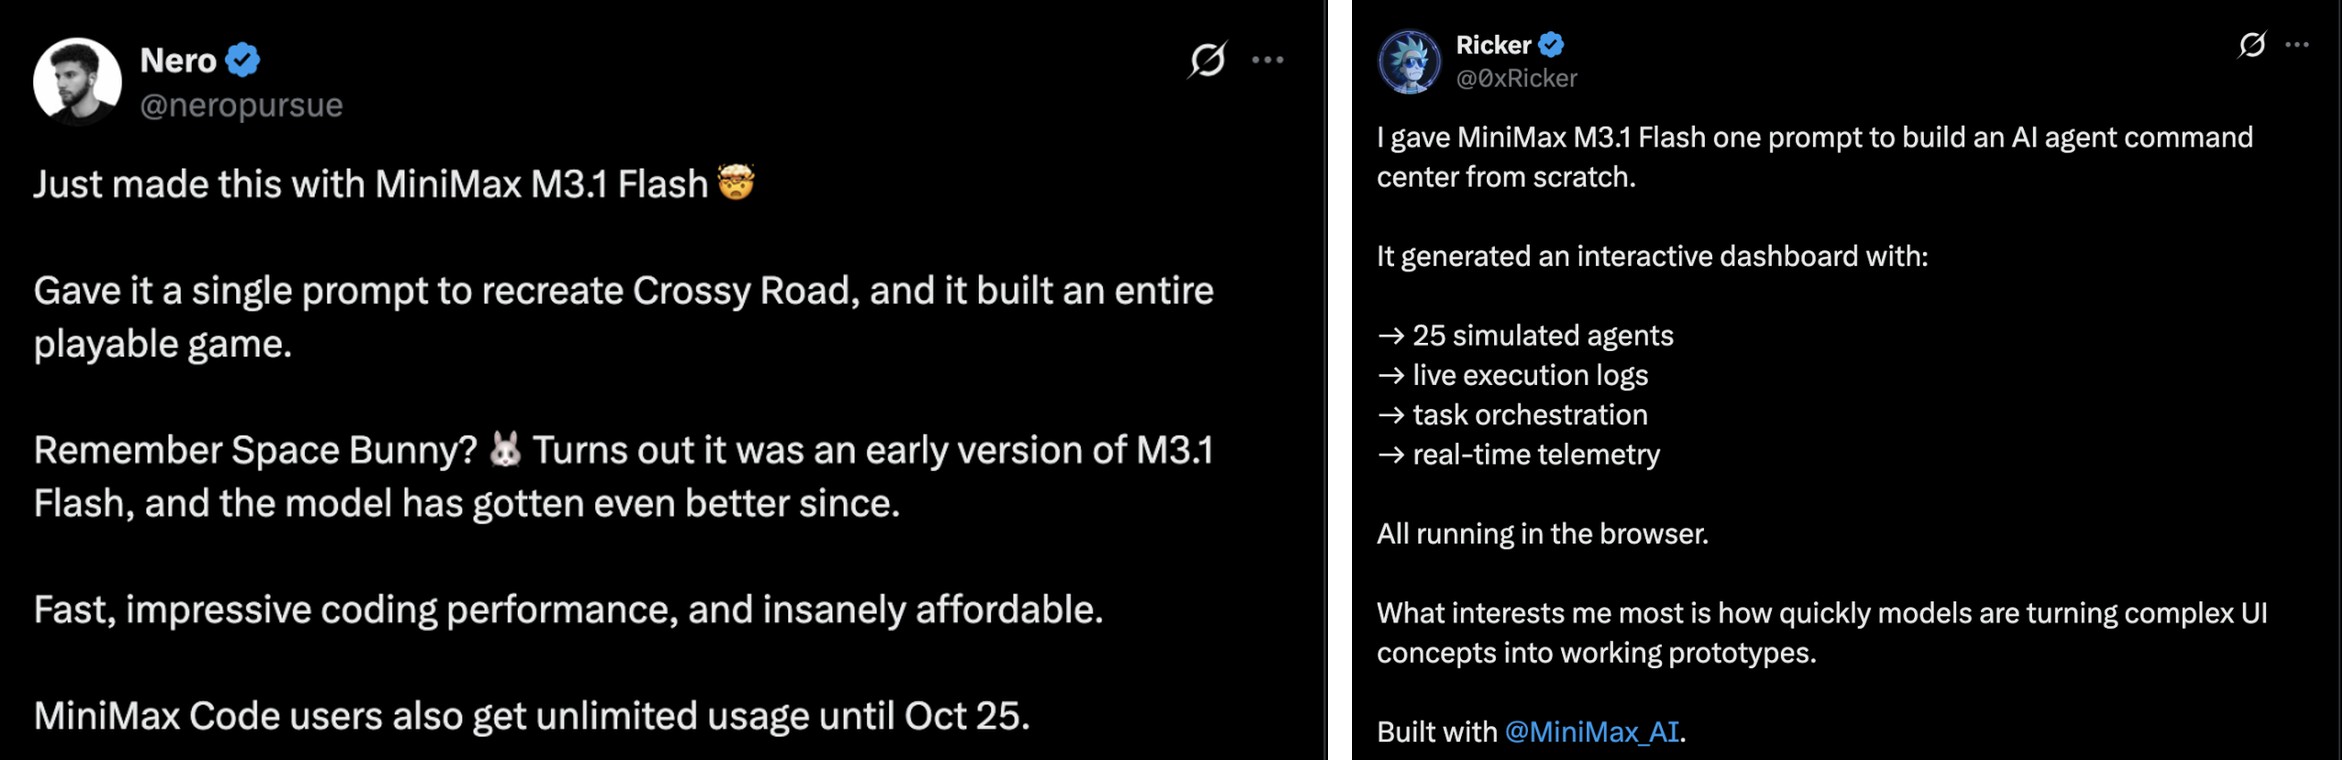
评测之外,开发者晒出的演示多是“一句话做出能用的东西”。有人只给一句指令,让它复刻小游戏《天天过马路》(Crossy Road),得到一个完整可玩的版本;有人让它从零搭一个 AI 代理指挥中心,生成的网页里有 25 个模拟代理、实时执行日志、任务编排和实时遥测,全部在浏览器里运行;还有人用它写出纯 three.js、不用任何外部素材的第一人称射击游戏。这些演示说明它能把一句模糊的需求拆成模块、组织代码、交付一个能点的原型,但都是单次结果,看不出成功率和返工次数。
价格:每百万 token 0.15 美元,和 DeepSeek 闲时价一样
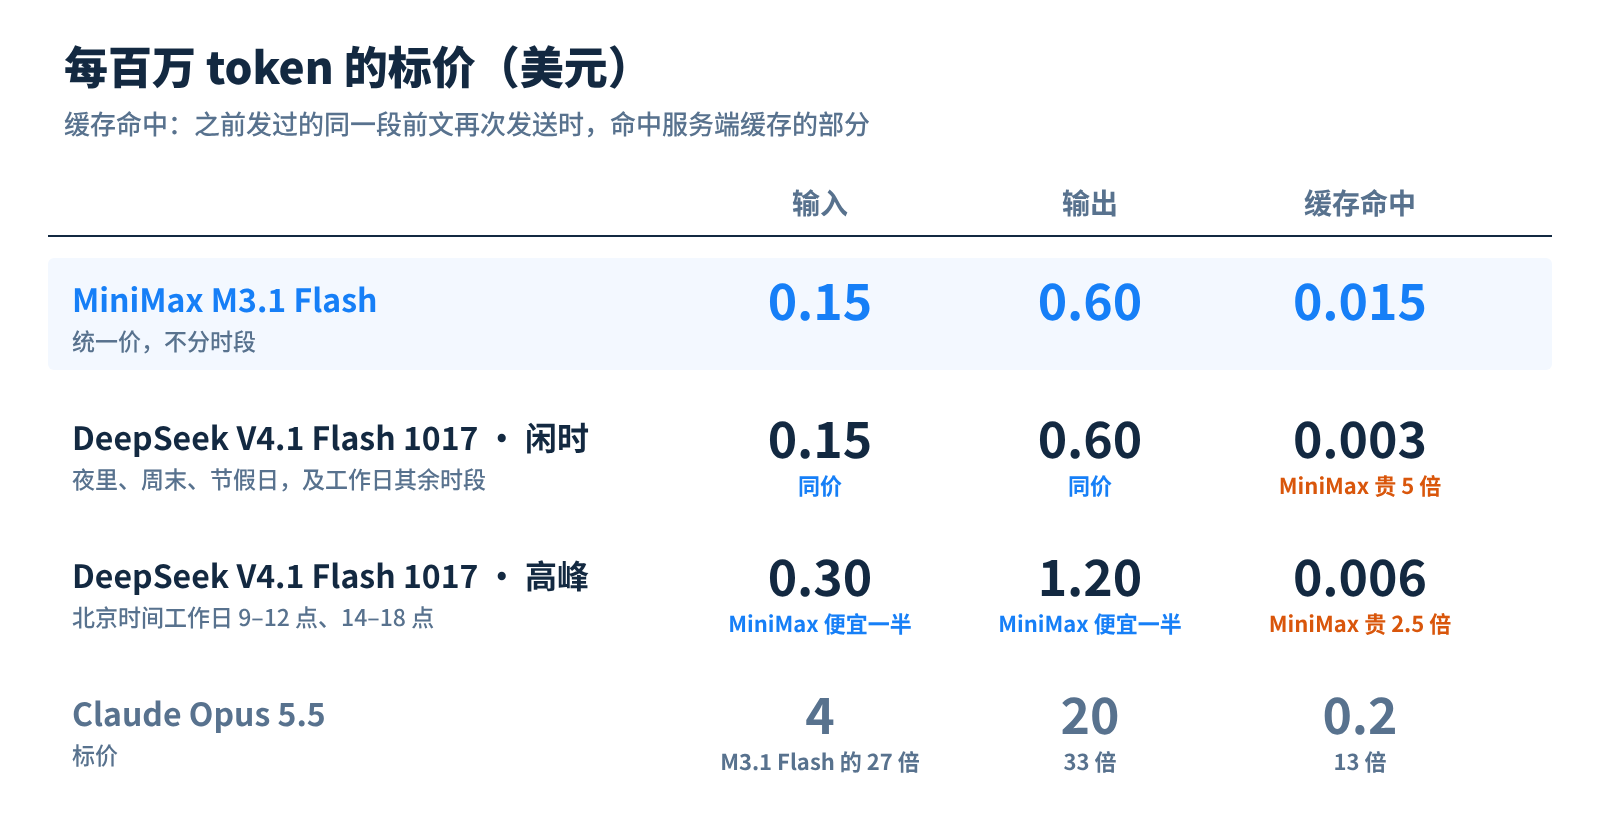
M3.1 Flash 的 API 标价是每百万 token 输入 0.15 美元、输出 0.60 美元、缓存输入 0.015 美元。缓存输入指之前发过的同一段前文再次发送、命中服务端缓存的部分,按一折计费。按标价算,一次输入 10 万 token、输出 2 万 token、不命中缓存的调用,费用是 1.5 美分加 1.2 美分,不到 3 美分。MiniMax 还说,Agent 任务的整体使用成本比上一代降了 70%;Artificial Analysis 跑综合指数时,每道题的成本从上一代 M3 的 0.51 美元降到 0.22 美元,降了 57%,方向一致。
国内最直接的对手是 DeepSeek V4.1 Flash 1017。它分时计价:北京时间工作日 9–12 点、14–18 点是高峰,输入 0.30、输出 1.20 美元;其余时间,包括夜里、周末和法定节假日,都是半价 0.15 和 0.60 美元,和 M3.1 Flash 一模一样。国内社交媒体上于是有句调侃,大意是“闲时用 DeepSeek,忙时用 MiniMax”。不过缓存价 DeepSeek 更低,高峰 0.006、闲时 0.003 美元,M3.1 Flash 的 0.015 美元是它的 2.5 到 5 倍。这个差别在下文算 Agent 账单时很要紧。
“便宜 88 倍”:单价差约 30 倍,剩下的是用量
Hassan 的测试只有一个任务:让两个模型各做一张硬件发布会的落地页。他给的账是 M3.1 Flash 0.014 美元、Opus 5.5 1.22 美元,M3.1 Flash 还快 4 倍,token 也用得更省。
一个任务的费用,等于各类 token 的用量乘以各自的单价。Opus 5.5 的标价是每百万 token 输入 4 美元、输出 20 美元,分别是 M3.1 Flash 的 27 倍和 33 倍。所以 88 倍里,单价能解释约 30 倍,剩下约 3 倍只能来自 M3.1 Flash 这次用的 token 更少,和 Hassan 说的“token 效率更高”对得上。这是按单价反推的,原帖没有给出 token 数。
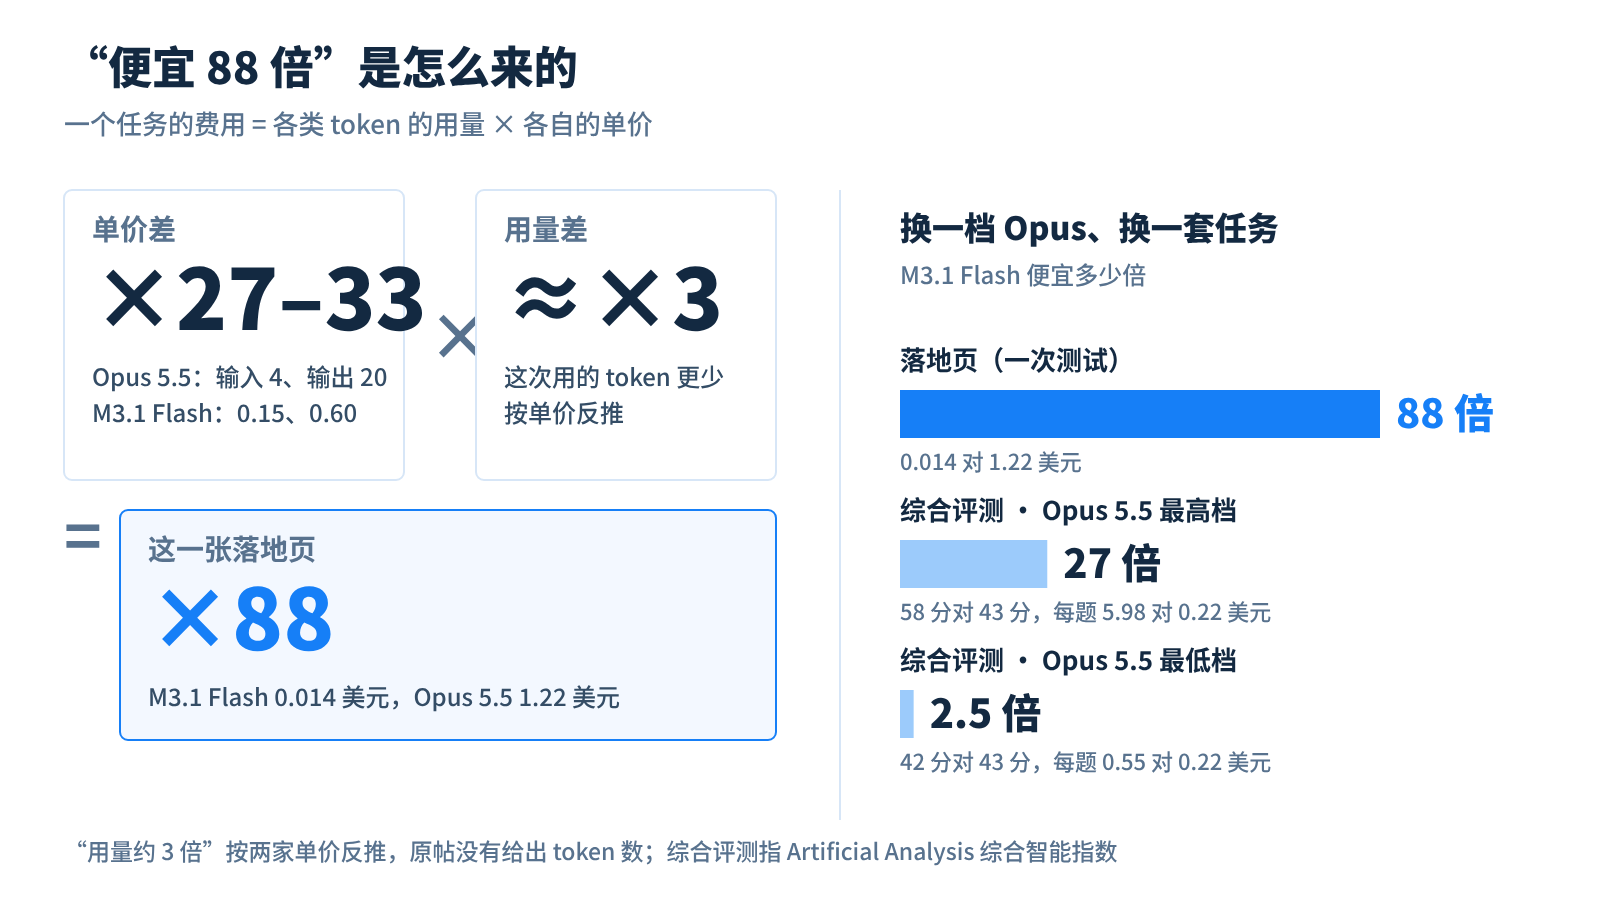
换一个任务、换一档 Opus,倍数会差很多。Opus 5.5 可以设推理强度,强度越低想得越少、花得越少。在 Artificial Analysis 的综合指数上,Opus 5.5 开最低档得 42 分,和 M3.1 Flash 的 43 分相当,每道题花 0.55 美元,是 M3.1 Flash 的 2.5 倍;开到最高档得 58 分,每道题 5.98 美元,是 27 倍。所以“88 倍”是一张落地页上的真实账单,不是两个模型的固定差价;水平相当时,这套评测里的差距是 2.5 倍左右。
单价不等于账单:Agent 的钱花在反复读前文
Agent 干活是一个循环:读任务、调工具、读工具返回的结果、决定下一步,而每一步都要把前面的对话和结果重新发给模型。前文越滚越长,输入 token 就远多于输出。Artificial Analysis 跑完整套综合指数,M3.1 Flash 共读入约 80 亿 token、写出约 1.8 亿,输入是输出的 44 倍。这些重复的前文大多命中缓存,缓存价于是成了账单的大头:M3.1 Flash 平均每道题 0.22 美元,读缓存就占 0.12 美元,输出只占 0.05 美元。
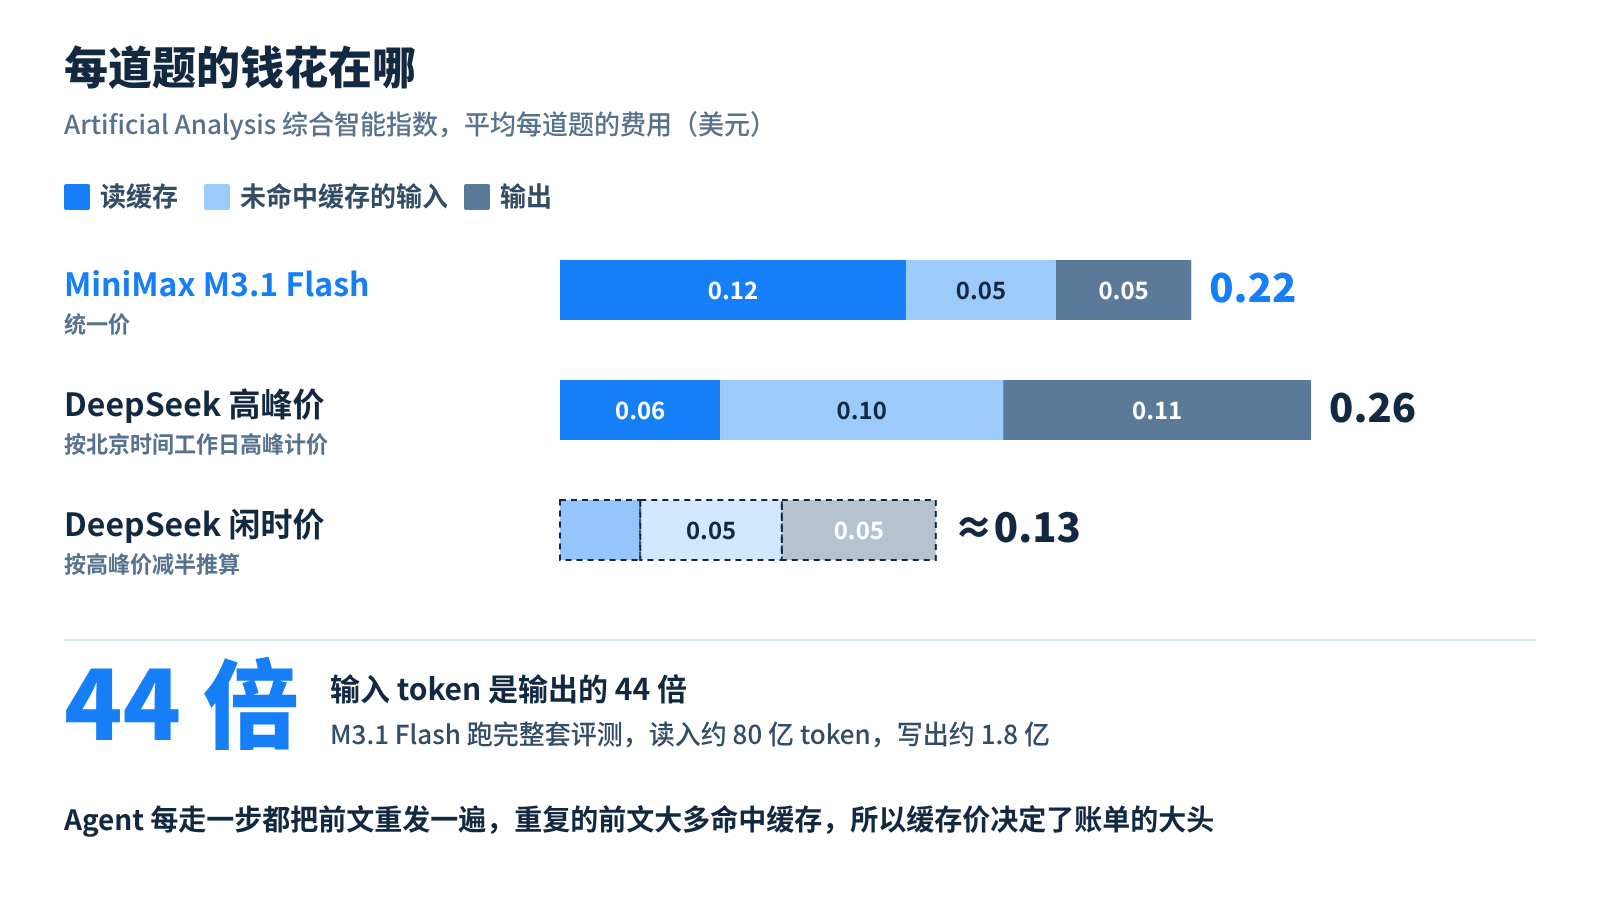
和 DeepSeek 比价时,口径就在这里。Artificial Analysis 按 DeepSeek 的高峰价计费,DeepSeek V4.1 Flash 1017 每道题 0.26 美元,比 M3.1 Flash 贵;按闲时半价推算约 0.13 美元,反过来比 M3.1 Flash 便宜。M3.1 Flash 输出写得少、输出单价也低,但读缓存贵 2.5 到 5 倍,抵掉了一部分优势。MiniMax 官方的成本对比图同样按 DeepSeek 高峰价计算:在 Automation-Bench 上,M3.1 Flash 每题不到 5 美分,分数最高、成本最低。
单价和用量之外,还有三笔账不在价目表上。一是重试:模型误解需求、调用工具失败或代码没过测试,就得重新规划和执行,单次便宜不代表试几次之后还便宜。二是时间:除了模型生成的快慢,还要等工具执行和环境响应。三是人工接管:交付的东西要人检查、返工,成本只是从模型挪到了人身上。
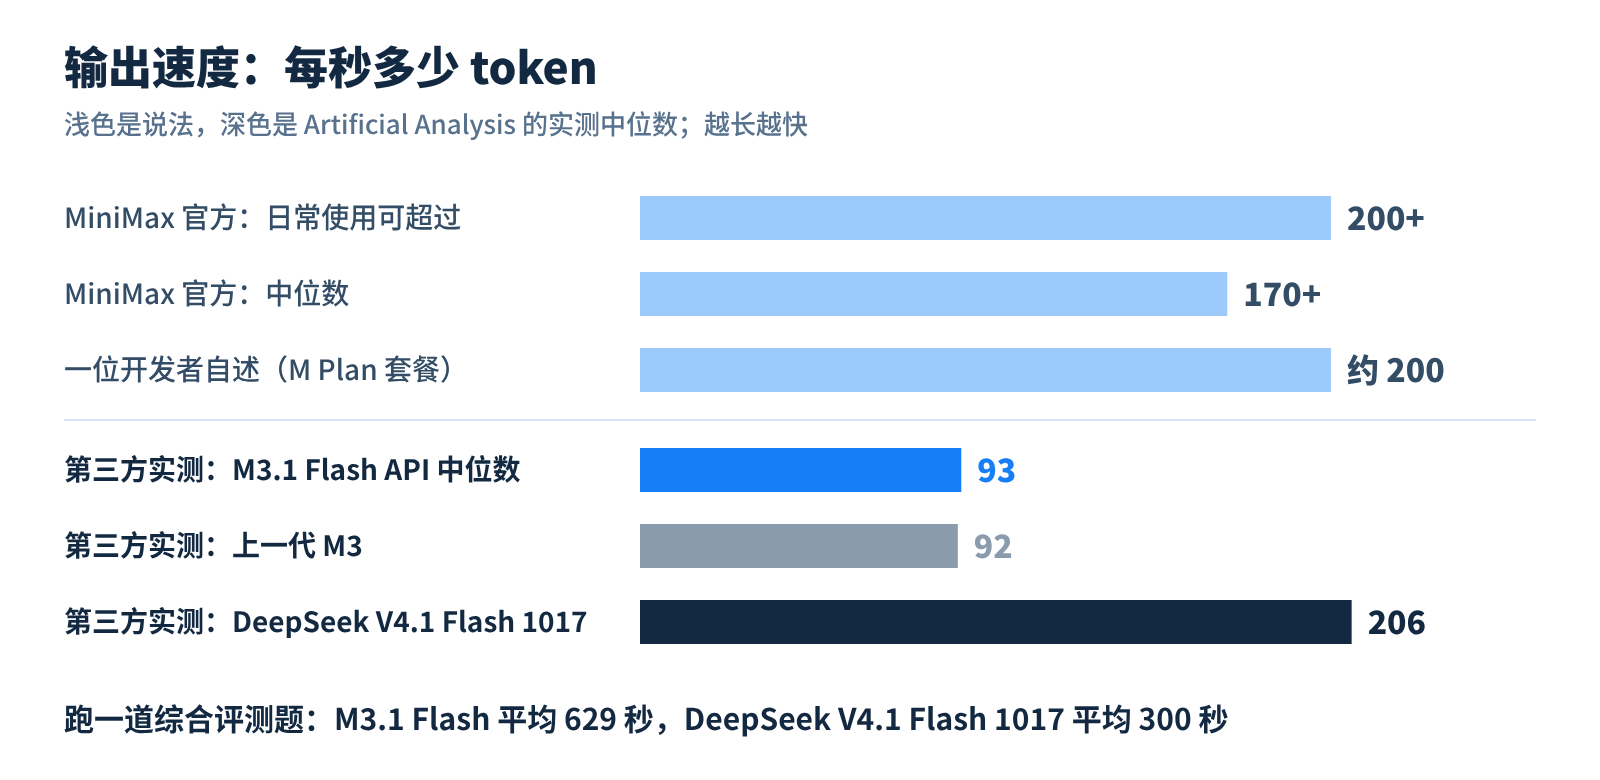
时间这笔账,官方和第三方的数字对不上。MiniMax 说 M3.1 Flash 日常输出速度能超过每秒 200 token,中位数稳定在 170 以上,在线推理比上一代快近 3 倍。Artificial Analysis 测 MiniMax 自家 API,中位数却只有每秒 93 token,低于它统计的平均值 111,和上一代 M3 的 92 几乎一样;DeepSeek V4.1 Flash 1017 是 206。落到任务上,M3.1 Flash 跑一道题平均 629 秒,DeepSeek 是 300 秒。差别可能来自渠道、发布初期的负载或测法,正式选用前值得自己测一次。
和 DeepSeek V4.1 Flash 1017 怎么选
两款国产 Flash 前后脚发布,价格几乎一样,强项不同。把两家都有成绩的评测放在一起看:
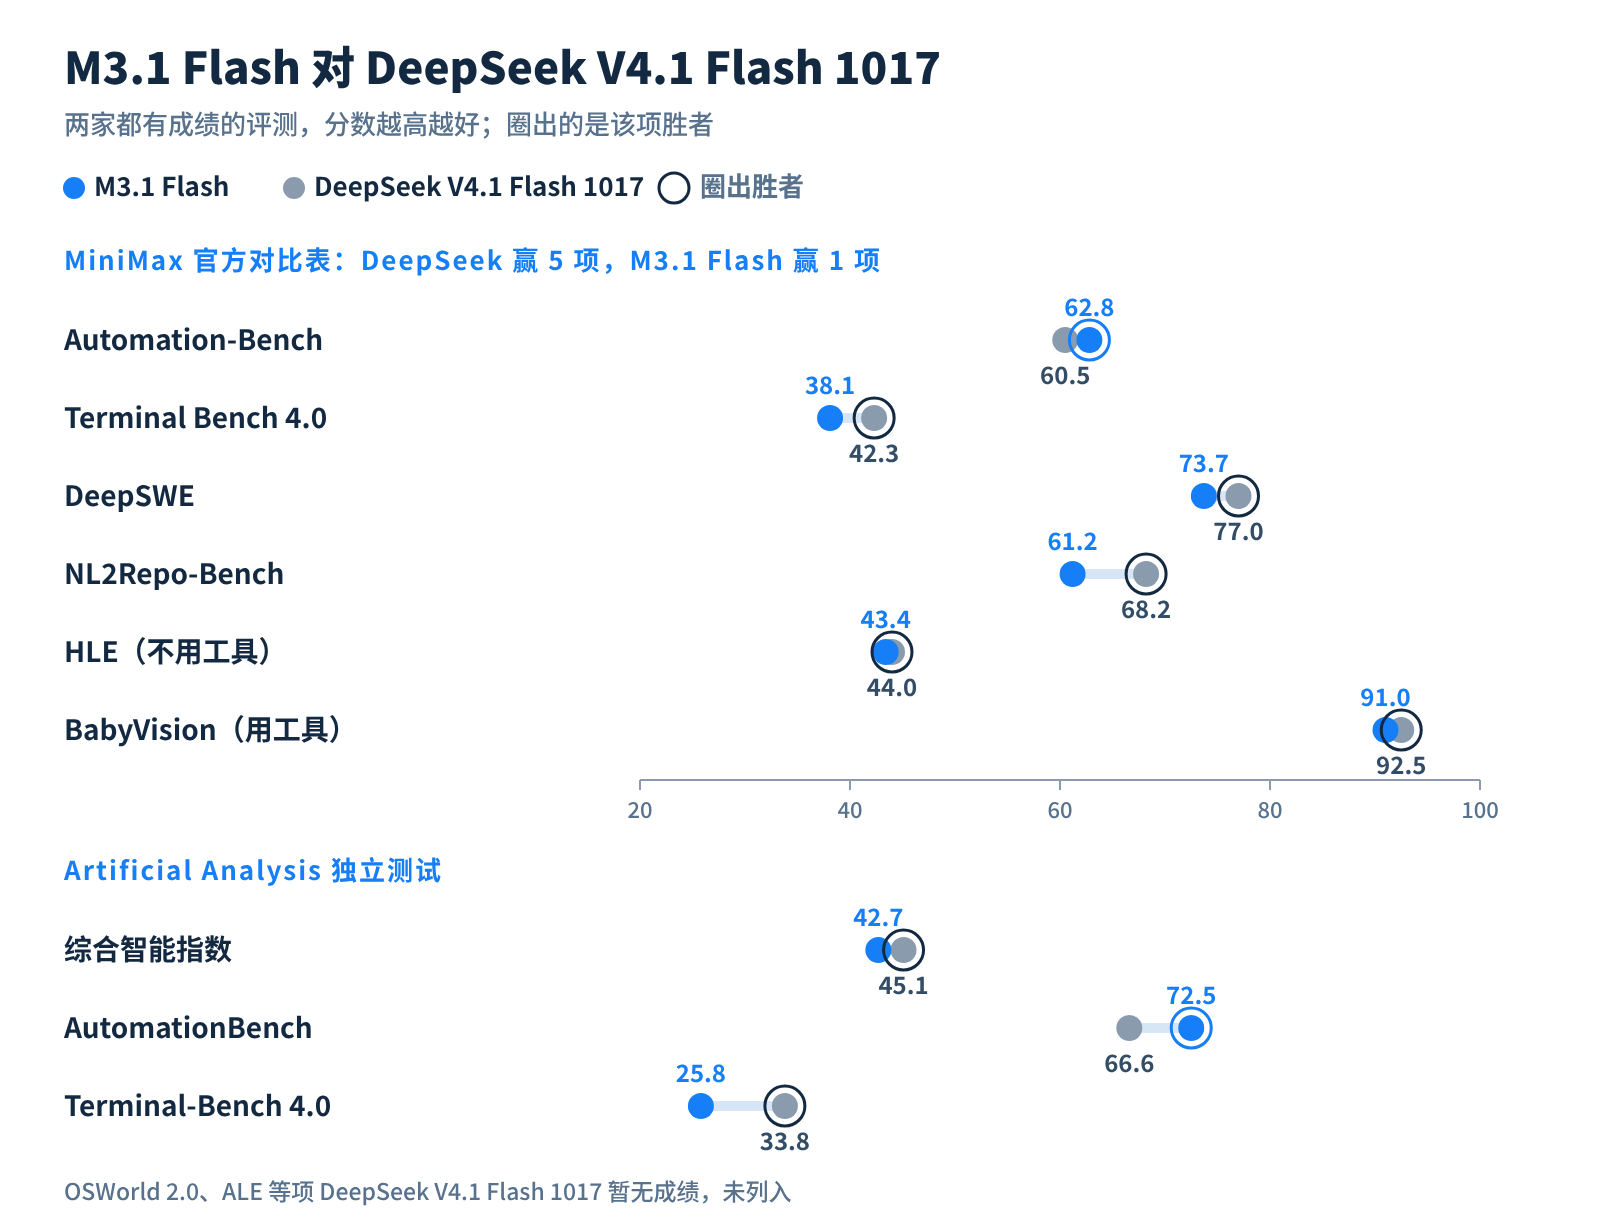
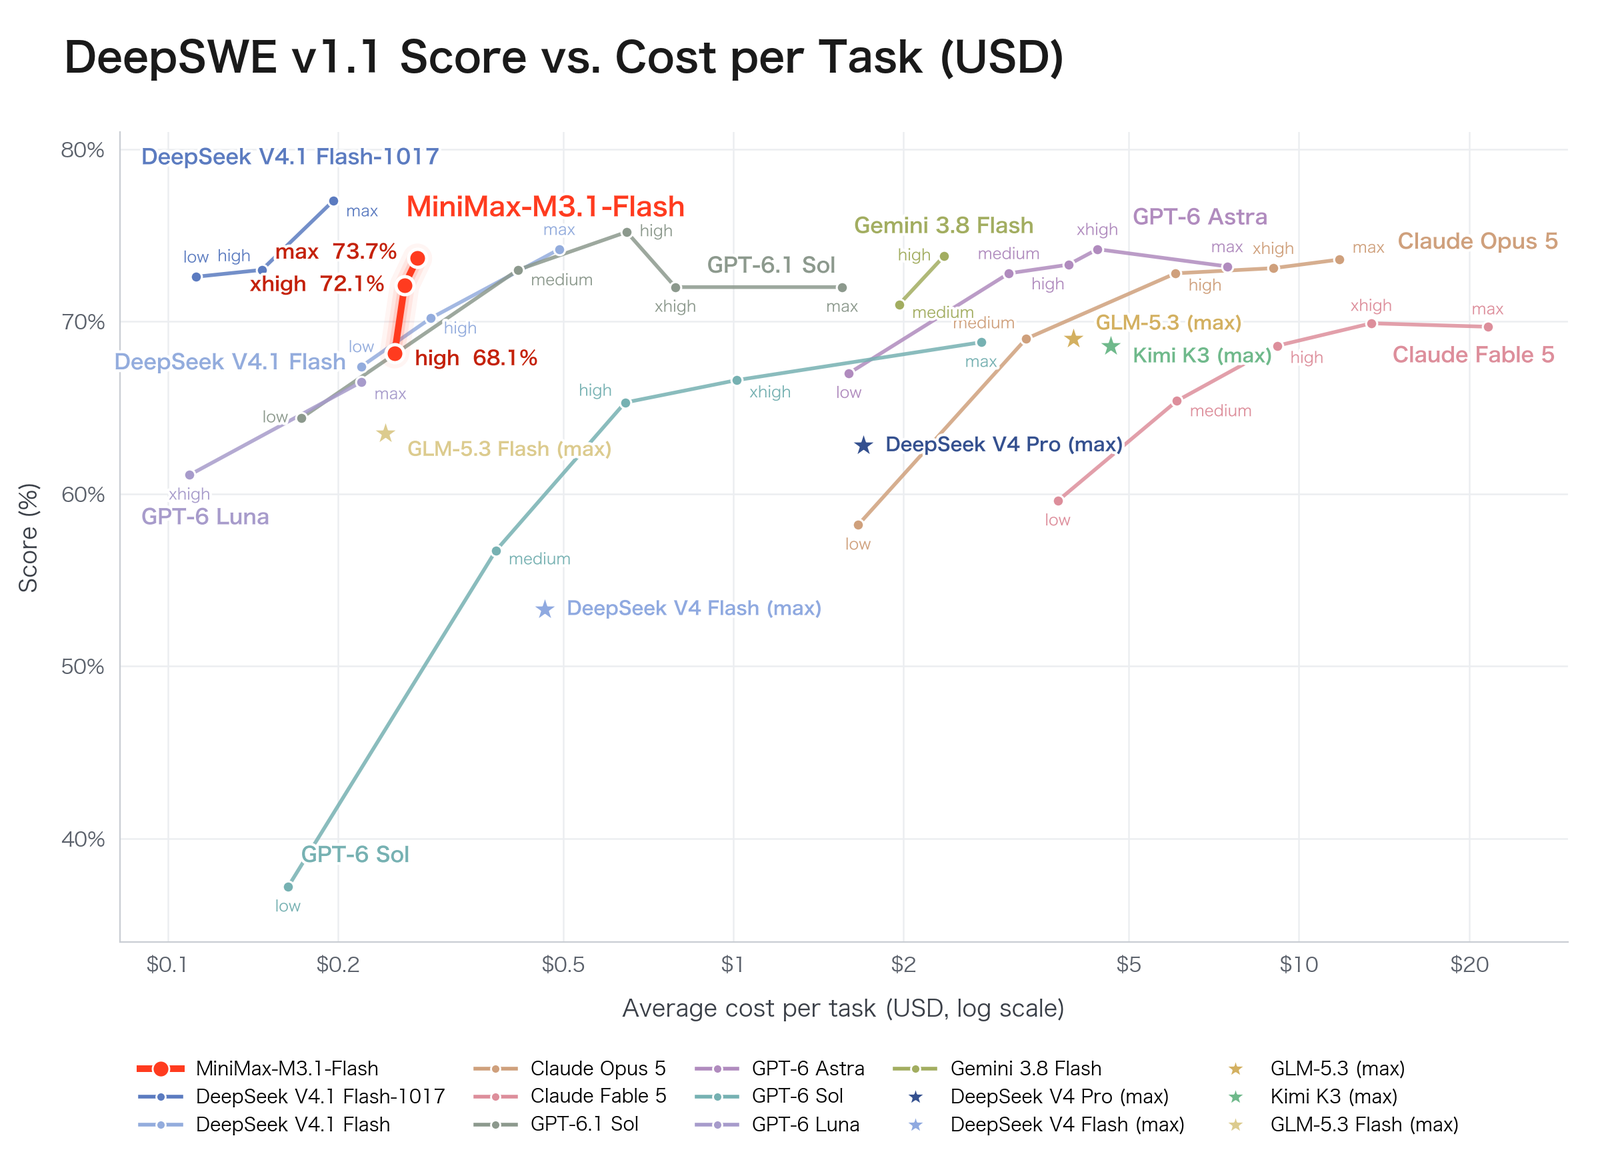
MiniMax 自己的表里,两家共同测过的 6 项中 DeepSeek 赢了 5 项,M3.1 Flash 只赢 Automation-Bench;Artificial Analysis 的独立测试也是 DeepSeek 综合分和终端操作更高,M3.1 Flash 在 AutomationBench 上领先 6 个百分点。MiniMax 自己画的 DeepSWE 成本图里,DeepSeek 甚至分更高、每题也更便宜:
两者还有一个差别:DeepSeek V4.1 Flash 1017 已经按 MIT 许可证开源权重,可以自己部署;M3.1 Flash 目前只能通过 MiniMax 的 API、M Plan 订阅和 MiniMax Code 使用,官方说权重稍后发布,更强的 Pro 版也在后面。所以粗略的分法是:以写代码、跑终端为主,DeepSeek 的公开分数更高、闲时更便宜,还能自部署;跨 SaaS 系统的业务自动化和操作电脑的任务,M3.1 Flash 有成绩优势;主要在北京时间工作日白天跑量的话,M3.1 Flash 的单价是 DeepSeek 高峰价的一半。
但榜单替代不了自己的账本:拿一组真实任务,在相同工具、相同环境、相同验收标准下让两个模型各跑一遍,记下成功率、token 消耗、端到端耗时、重试次数和人工介入时间,算出每完成一件事花多少钱。88 倍和国产第一都只是线索,便宜模型值不值,要看做完一件事的总账,不看价目表上的单价。