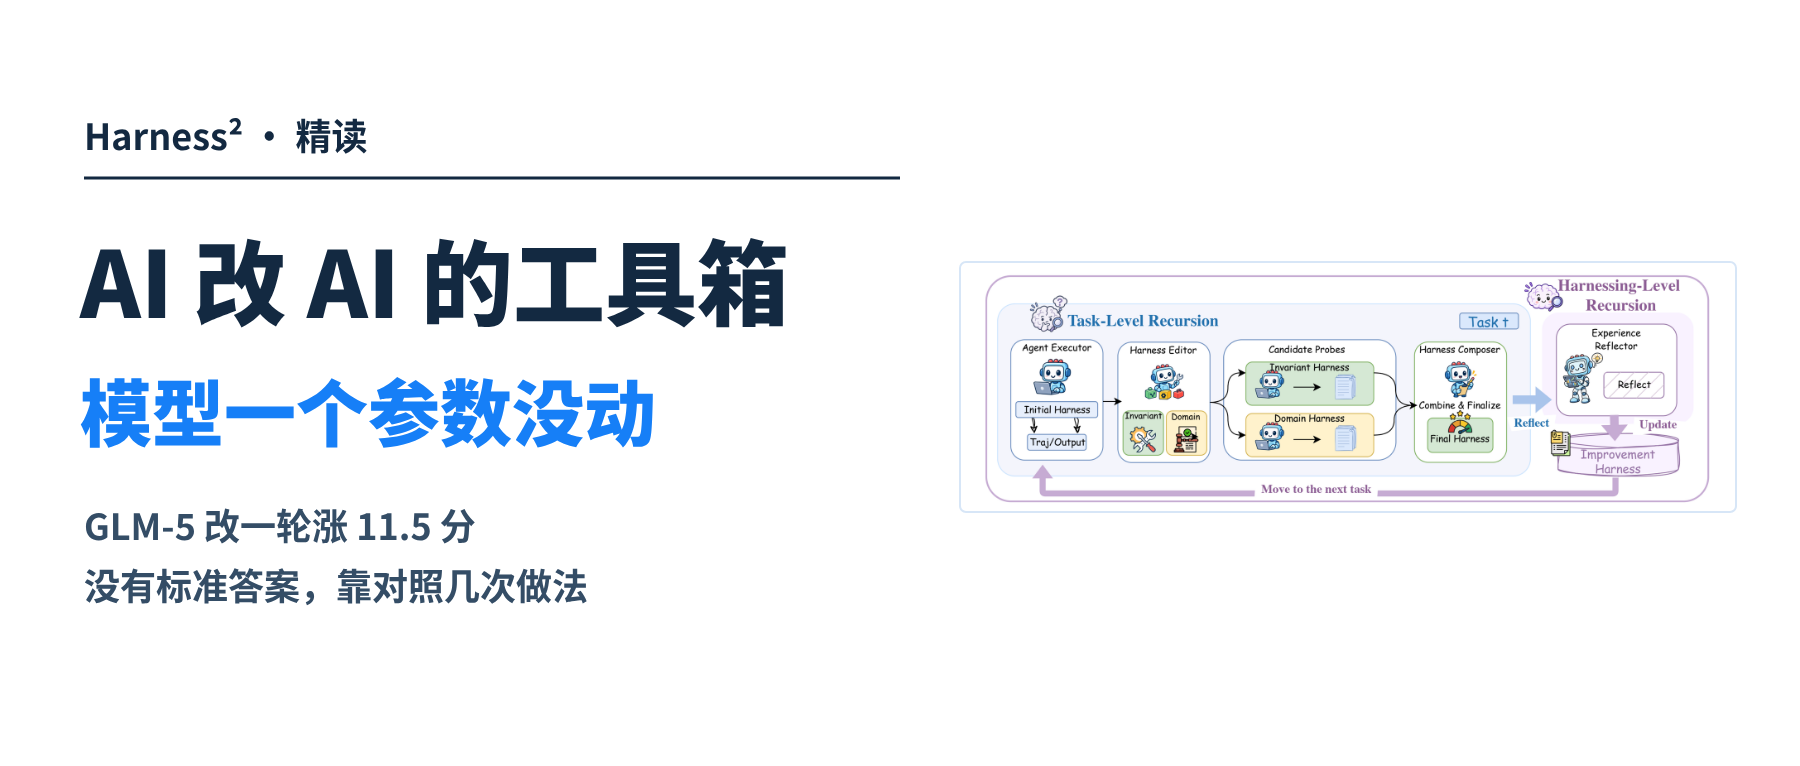
摘要 Harness² 是 Google Cloud AI Research 和西北大学 10 月开源的研究:模型权重不动,由 AI 改模型外面的“工具箱”(harness),也就是系统提示词、规则、技能、脚本、插件等八个文件。新任务没有标准答案,它的办法是同一道题先按原样跑一遍,写两版改法各跑一遍,对照几次的过程决定留下哪些改动;做完一题,再把“改了什么、为什么有用”记进经验库,下一题仍从原版起步、按需参考。在三个职业任务评测、四种模型和工具箱组合上,改一轮全部涨分,GLM-5 在 WorkBuddy-Bench 上从 64.2 涨到 75.7。代价是每题要多跑几遍,总 token 是原版的数倍。
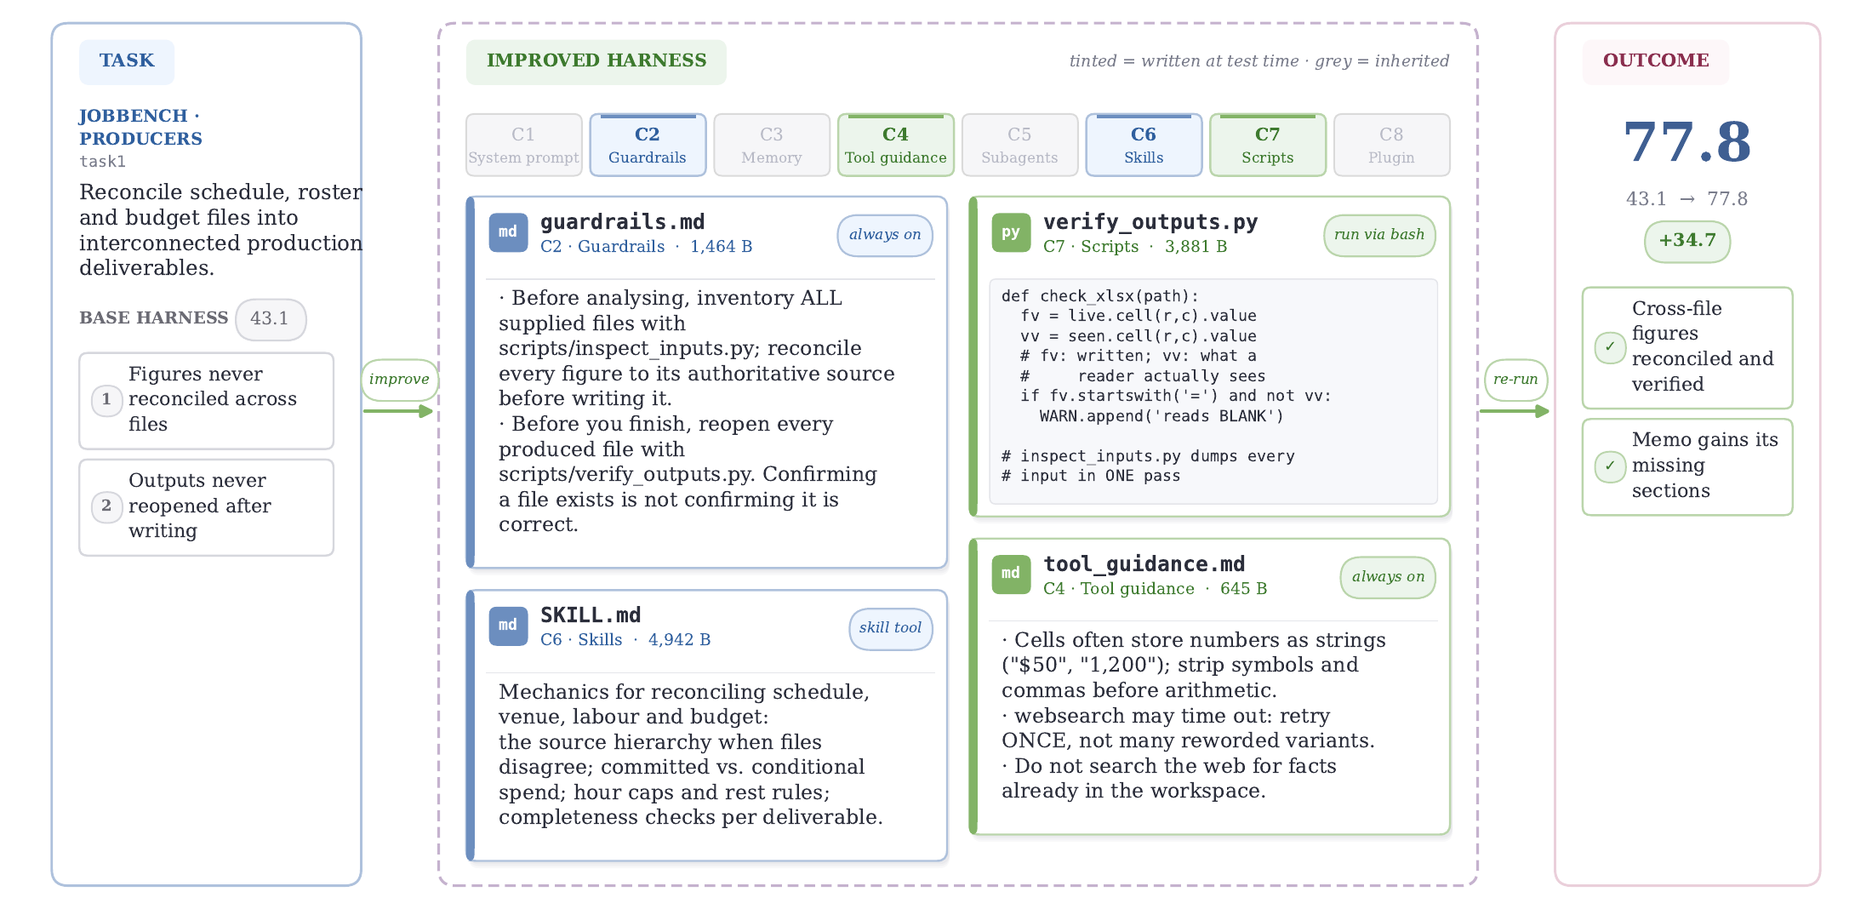
JobBench 评测里有一道制片岗位的题:把排期、人员名单和预算几份文件对齐,交出一套互相关联的制片文件和一份备忘录。Gemini 3.5 Flash 在原版 OpenCode 里做完,得了 43.1 分。翻它的执行记录,问题不在不懂行,而在做事的步骤:几份文件里的数字从没互相核对过,文件写完也从没再打开看一眼。
Harness² 没有动模型,只在模型外面添了几样东西。一条常驻规则:开工前先清点全部输入文件,每个数字追到出处;收尾前用脚本把产出的文件逐个重新打开,原话是“确认文件存在,不等于确认它是对的”。一份对账技能:几份文件对不上时以哪份为准,已确定和待定的开支怎么分。一段工具说明:表格里的“$50”“1,200”要先去掉符号和逗号再算。同一个模型重做一遍,得了 77.8 分。
模型外面这一整套东西叫 harness,可以理解成模型的工具箱。Harness² 是 Google Cloud AI Research 和西北大学的研究,10 月开源,它把改工具箱的活交给 AI,要回答两个问题:新任务没有标准答案,凭什么知道改对了;改完一道题,怎样让下一道题改得更好。
Harness 是模型外面的八个文件,常驻文字最贵
论文用一个式子定义 agent:Agent = Model + Harness。模型权重冻结不动,harness 是让它能当 agent 干活的其余部分。Harness² 把它拆成八个可改的组件,每个组件是运行时挂载的一个文件,所以每次修改都是一份 diff。
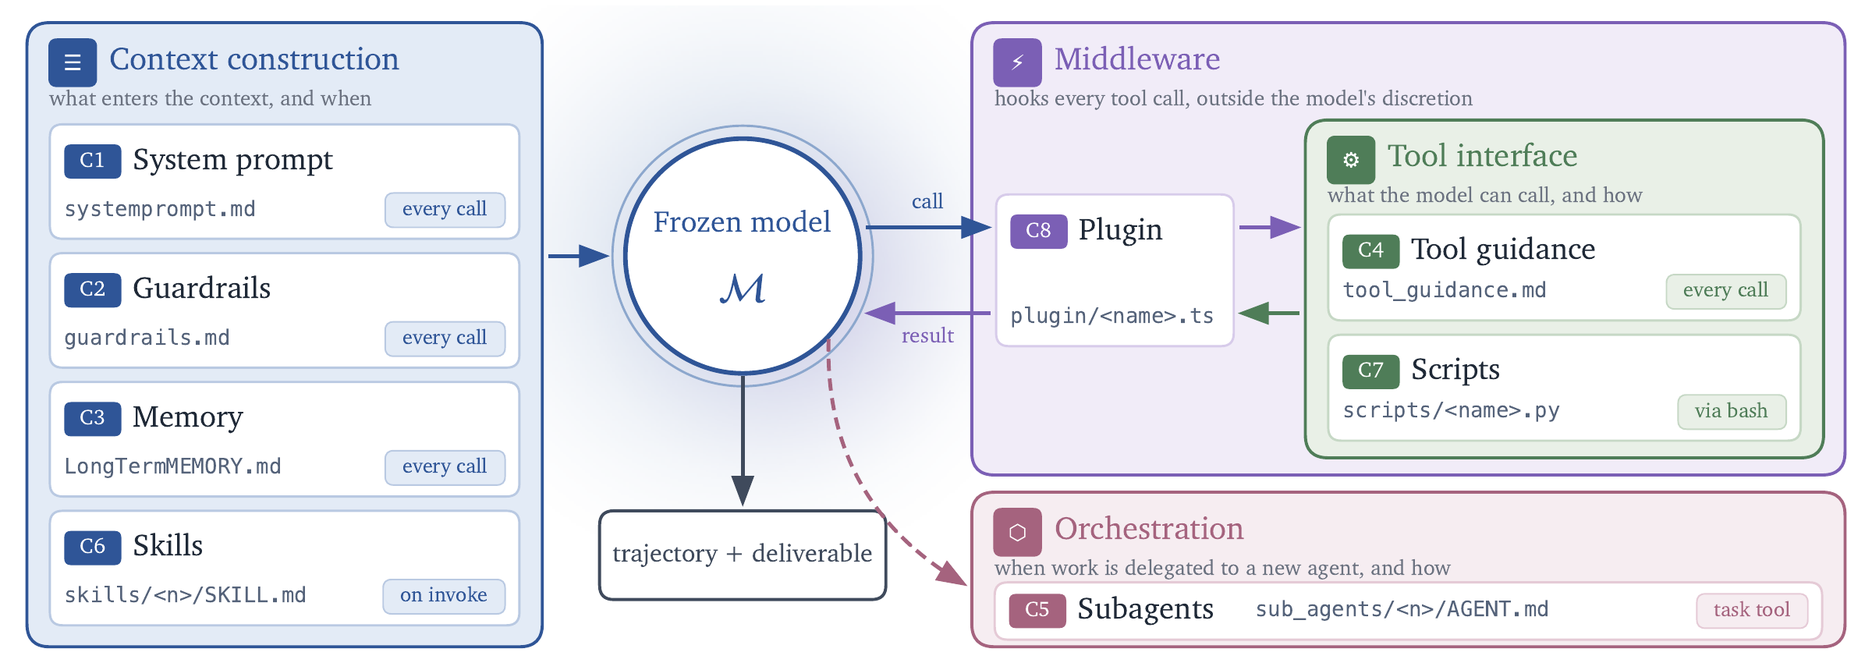
- 构建上下文:系统提示词、规则(guardrails)、长期记忆每次调用都在;技能(skills)被调用时才加载。
- 工具接口:工具说明每次都在;脚本通过 shell 按需运行。
- 分工:子智能体在自己的上下文里干活,只交回文字结果。
- 中间件:插件挂在每次工具调用上,模型想跳也跳不过去。
改哪一个,代价不同。给改写者的指令里有一张成本表,结论很直白:常驻文字最贵,每个字每次都占着上下文,和模型自己的输出预算抢位置。所以指令定了先后:有明确触发场景的流程写成技能,模型手写又写错的确定性操作写成脚本,输入大、答案小的调查交给子智能体,工具循环里反复出现的机械问题交给插件,比如截掉过长的工具输出、写完文件立刻校验;最后才轮到常驻文字,而且“加了常驻文字,就得删掉别的来付账”。事后拆组件的实验和这条规矩对得上:从改好的工具箱里拿掉技能,WorkBuddy-Bench 三类题平均掉 5.3 分,拿掉脚本掉 3.7 分,拿掉提示词类组件只掉 1.5 分。
难处有两个。开放环境里的任务事先没见过,没有标准答案,也没有可靠的自动检查器告诉你改得对不对;为一道题量身改的东西,换一道题又常常失效。Harness² 用两层循环分别对付这两件事。
没有标准答案:跑一遍、改两版、对照着合
打个比方:模型是一位不换人、也不送去培训的员工,harness 是他手边的员工手册和工具。Harness² 像一位带教主管,手里没有答案卷,只能看员工怎么做、交了什么,再决定手册怎么改。
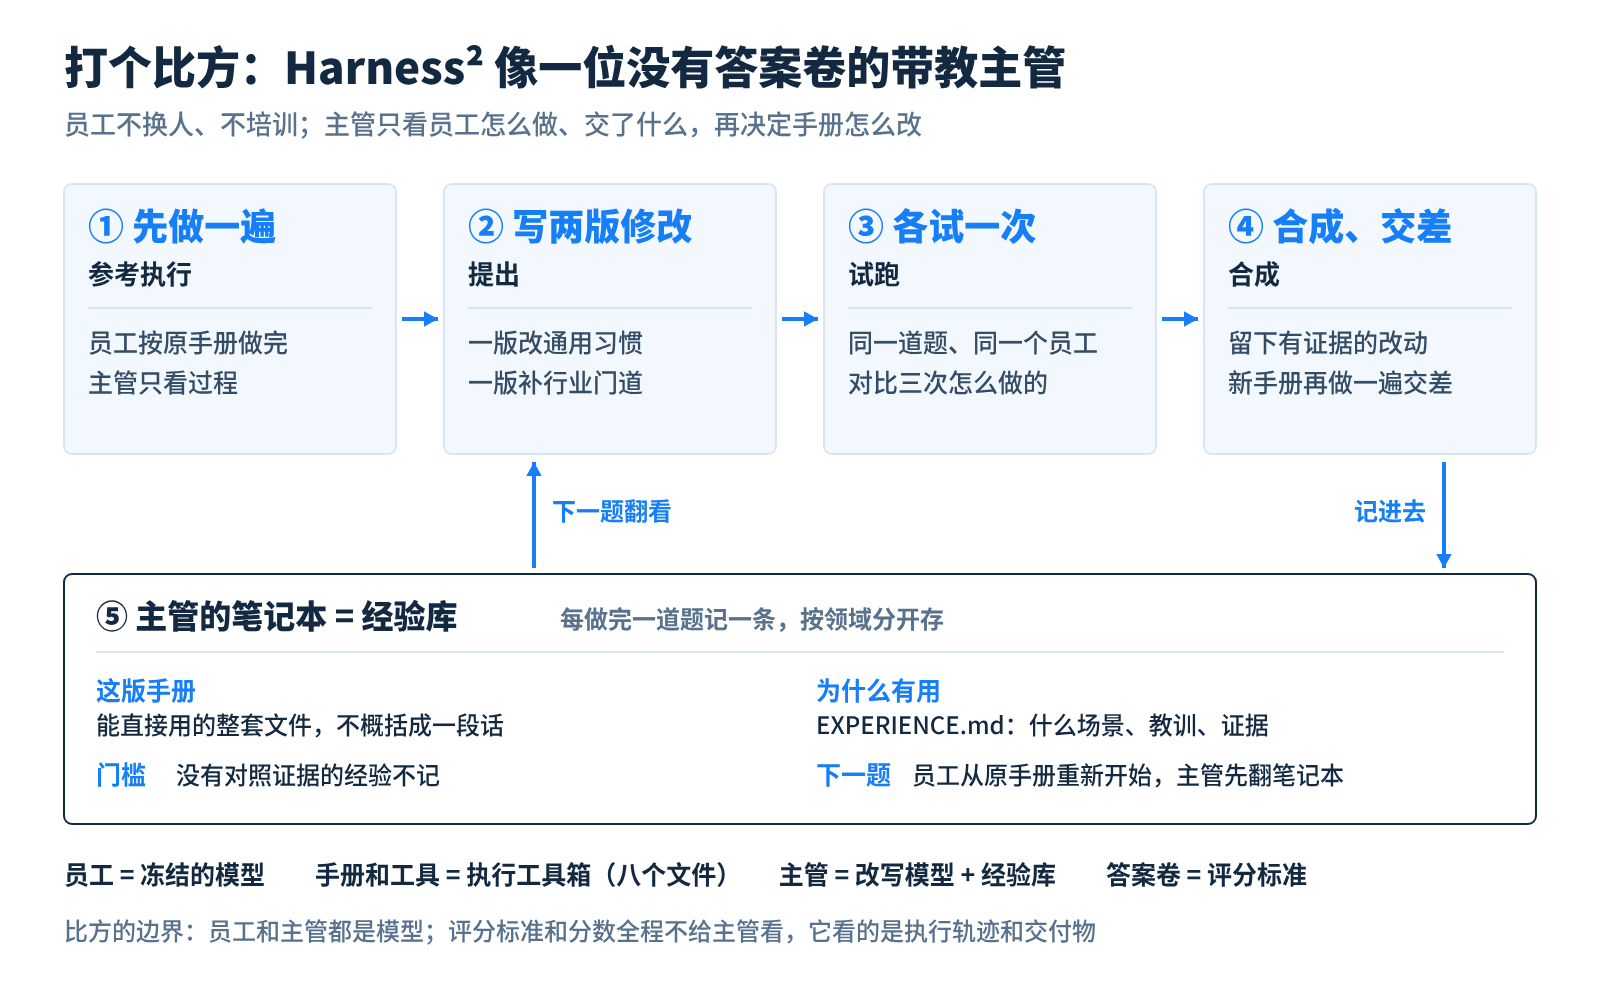
对应到论文里,每道题走一遍“提出、试跑、合成”(Propose–Probe–Compose)。
提出。 先用当前工具箱跑一遍,得到参考执行。论文特意说明,这次执行揭示的是工具箱怎么起作用,不说明交付物对不对。改写者读题目、工具箱、参考执行和经验库,写出两个候选:通用候选针对换个领域也会犯的毛病,比如规划、用工具、管理上下文、分派任务;领域候选针对本领域的知识、流程和约束。制片那道题,通用候选是开头那条“清点输入、回头检查”的规则和配套的检查脚本;领域候选是对账技能和工具说明。
试跑。 两个候选在同一道题、同一个模型和环境下各跑一遍,和参考执行对比轨迹与交付物,看改动是解决了针对的毛病、没起作用,还是带出了新问题。这些对比只用来指导合成,不判定答案对错,因为执行有随机性,几次运行也共用同一个模型的偏见。
合成。 改写者读参考执行、两个候选、它们相对原版的 diff 和全部执行证据,拼出新版工具箱:可以合并有证据支持的改动、修改互相冲突的改动、只采用一个候选,也可以保留原样。每个决定都要挂到一处具体的观察上,而不是“预计会涨分”。 新版再跑一遍,交出最终结果。制片那道题,两个候选带来的四处改动全部留下。
评分标准和分数全程不给改写者看,代码会拒绝交出任何含这些内容的工作目录;候选工具箱里的脚本和插件,改写者也只当文本读,不执行。
主实验里,执行任务的是 Gemini 3.5 Flash 或 GLM-5,改写、合成和挑选由 Claude Opus 4.8 完成。这算不算靠更强的模型带教?论文另做了一组实验(探索预算 k=2,见后文),让同一个模型自己当改写者:从 GLM-5 到 Claude Opus 5 五个模型,在三个评测上全部涨分,GLM-5 在法律评测 LAB 上涨了 13.7 个百分点。
做完一题记进经验库,下一题不继承工具箱
第二层循环发生在题与题之间。交付之后,Harness² 回看这道题的整套改进记录,提炼哪些改动在什么条件下解决了什么毛病。只有执行对照支持的经验才留下,“最后被选中”本身不算证据;证据不够,就不写新条目。
经验库按领域分开存,每道题一个条目:一套完整、能直接运行的工具箱文件,加一份 EXPERIENCE.md,写明适用场景、教训和证据;另有一个索引列出全部条目,后面的题按需翻看。论文特意保留可执行的组件,而不是把它们概括成一段文字。
关键的设计是,下一道题仍从原版工具箱起步。 上一题的组件不会自动继承,只能在“提出”这一步被挑出来复用或改写。被改进的只有带教主管这一层:模型权重和各阶段的指令都不变,变的只是这个库。
这一层有没有用,论文给了三组数,都是 Gemini 3.5 Flash 配 OpenCode:
- 去掉经验库、每道题单独改:WorkBuddy-Bench 均分从 77.5 降到 74.4,JobBench 从 36.0 降到 34.2。
- 不跑参考、不试跑、不看库,直接凭题目改原版工具箱:代码题从 73.4 掉到 63.2,网页题从 69.9 掉到 65.0。同样不跑,只是先读一个积累好的库再改,三类题能比原版高 0.9、4.4 和 5.1 分(这个库来自每题并行 5 路的运行)。
- 换个评测也能用:拿 JobBench 上积累的库去改 WorkBuddy-Bench 的题,三类题在改一轮的基础上再涨 0.6、0.5 和 2.9 分。
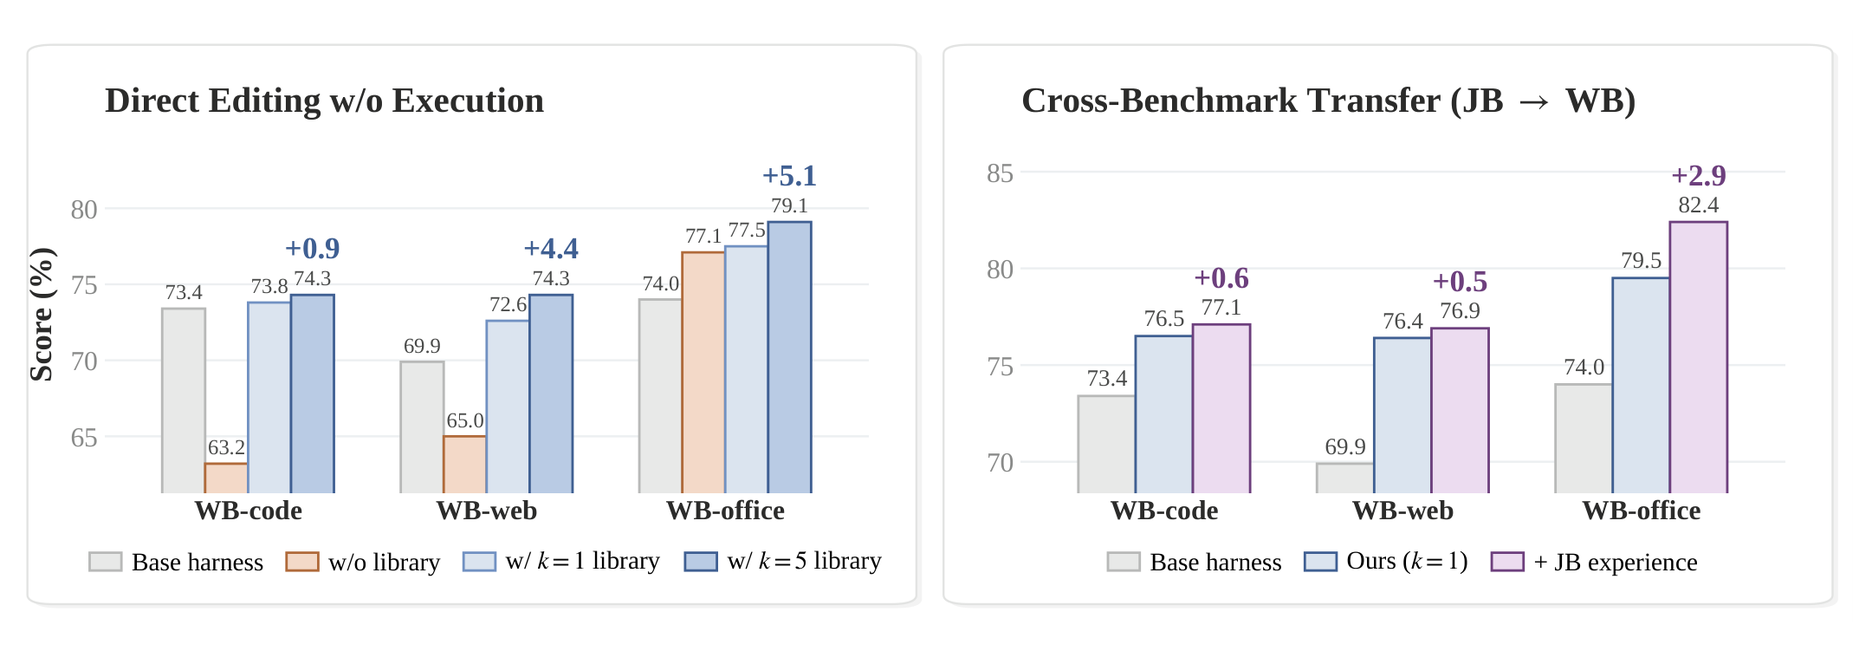
第二组数说明:不跑一遍就动手改,比不改还差;而前面花算力攒下的经验,后面不试跑也能用上一部分。
成绩:改一轮 12 组全涨,GLM-5 反超原版 Gemini
三个评测都是职业任务:腾讯的 WorkBuddy-Bench 分代码、网页、办公三类,测试集共 100 道题;JobBench 覆盖 7 个职业领域,测试集 34 道题;Harvey 的法律评测 LAB 用 100 道测试题,报告逐条评分标准的通过率。执行模型是 Gemini 3.5 Flash 和 GLM-5,原版工具箱是开源的 OpenCode 和 OpenAI 的 Codex CLI,两两组合成四组。每个分数是三次独立运行的平均,经验库从空开始。
改一轮(每题只做一次“提出、试跑、合成”)之后:
| 模型 + 原版工具箱 | WorkBuddy 均分 | JobBench | LAB 通过率(%) |
|---|---|---|---|
| Gemini 3.5 Flash + OpenCode | 72.4 → 77.5 | 31.5 → 36.0 | 79.9 → 81.9 |
| Gemini 3.5 Flash + Codex | 74.5 → 77.5 | 33.9 → 35.3 | 71.6 → 75.6 |
| GLM-5 + OpenCode | 64.2 → 75.7 | 20.6 → 24.2 | 59.6 → 71.4 |
| GLM-5 + Codex | 64.4 → 75.3 | 23.6 → 24.8 | 58.1 → 65.9 |
12 格全部上涨。最显眼的是 GLM-5:WorkBuddy-Bench 上改一轮就到 75.7 和 75.3,超过了用原版工具箱的 Gemini 3.5 Flash(72.4 和 74.5)。JobBench 上反过来,Gemini 涨得更多。
对照方法里,离线在训练题上搜出一套工具箱再部署的 Meta-Harness 最强:Harness² 在 WorkBuddy 均分和 JobBench 上四组都领先它,LAB 上 Gemini 配 Codex 这一组输给它(75.6 比 76.5)。只把过去经验检索回上下文的 ReasoningBank,和每题现改但不跨题积累的 Harness Scaling,有不少组不如原版。论文还拿 Gemini 3.5 Flash 配四个不改动的现成工具箱比,Claude Code 在代码和办公题上最好,Codex 在网页题上最好;Harness² 从 OpenCode 起步、每题并行 5 路后,三类题分别比其中最好的再高 4.6、5.8 和 4.9 分。
读这些数要看清幅度:各组标准差多在 1 到 4 分,测试题只有几十到一百道,像 Gemini 配 Codex 在 JobBench 上涨 1.4 分这样的差距,落在运行波动的范围里。
多花算力还能涨:并行和串行
每题的探索预算用 k 表示,加预算有两种方式。并行:先跑 k 次参考,通用、领域候选各写 k 个并试跑,再开 k 个独立的合成会话,各读全部证据出一版;最后由挑选者匿名比较这些交付物,选一个交出去。串行:连做 k 轮“提出、试跑、合成”,每轮在上一轮的工具箱和证据上接着改。k=1 时两种方式相同,也不用挑。
在 WorkBuddy-Bench 的代码题和办公题上,两种方式都随 k 从 1 到 5 稳步上升。并行从 76.5 涨到 80.8(代码)、从 79.5 涨到 83.4(办公),到 5 路时高于串行;k=2 时,两种方式就都超过了图中对照方法(ReasoningBank、Harness Scaling、原版跑 k 次挑最好的)在 k=5 的成绩。主表里,并行 5 路在改一轮的基础上,WorkBuddy-Bench 再涨 2.9 到 3.9 分,JobBench 再涨 3.0 到 4.2 分,LAB 再涨 2.6 到 6.7 个百分点。
代价按执行次数算:k=1 时一道题要执行 4 次(参考 1 次、试跑 2 次、终版 1 次);按论文描述的流程,并行 5 路是 20 次,还不算改写模型的会话。论文把执行和改写的 token 都算进成本,Meta-Harness 花得比 Harness² 5 路还多,效果却更低。从论文的算力图上估读,改一轮每题的总 token 约是原版的 6 到 8 倍,并行 5 路约 30 到 40 倍。JobBench 原版每题约 500 万 token,5 路超过 1 亿。
局限:会挑错、会被带偏,还可能翻到评分标准
没有标准答案,靠的就是行为对照和模型判断。论文自己写明,这些信号对运行波动和模型的共同偏见敏感,不保证改对,也不保证换一道题还有效。它分析的 9 个分数下降案例里,主要有两类:
- 挑选者挑错。 WorkBuddy 的一道代码题,五个候选交付物分别能得 95、85、85、80 和 55 分,挑中的是 55 分那个。
- 错误前提一起传开。 一个“必须用字面键名”的要求,或一个没核实的缓存假设,被几个候选同时采用,损失 2 到 11 分。
仓库文档还提醒了一个坑:执行时网络不设限,Codex 还关掉了沙箱,而 JobBench 把每道题的评分标准公开放在 Hugging Face 上。发布前的一次验证运行里,一个 Codex 执行在没人要求的情况下,下载了自己那道题的评分标准。 所以跑评测前,要在网络层屏蔽 huggingface.co、github.com 这些站点,光改工具设置不够。
想自己跑,仓库要求 Linux、Python 3.12 和 uv。本地 demo 用确定性的改写器跑真实的 Python 执行,不需要模型账号;真实评测默认接 Google Cloud 的 Vertex AI,执行和评分用 Gemini,改写模型可选 Vertex 上的 Claude 或 Gemini。代码按 Apache 2.0 开源,仓库注明这不是 Google 官方支持的产品。
值得带走的三点
平时用 Claude Code、Codex 这类工具,不跑 Harness² 的框架也能借它几条做法:
- 先跑一遍,再对照着改。 凭任务描述直接改工具箱,代码题掉了 10 分。改 agent 的提示词和技能,也值得留一次“改前”的运行记录,同一个任务跑两版比一比。
- 新规矩优先写成技能和脚本,少往常驻提示词里堆。写完文件立刻校验这类机械检查,交给脚本或 hook,模型跳不过去。
- 留下“为什么有用”,别整套继承。配置越攒越多时,记下每条规则是为哪次翻车加的、在什么场景有用,比一份越写越长的总提示词好维护。