摘要 Murea Labs 团队 10 月 17 日公开了交互视频系统 Murea-InWorld:玩家打一句话,AI 接着拍下一段带声音的视频。视频模型两次生成之间不记事,它的办法是让智能体 Murea-Mind 在模型外面记一本账,记下每个角色的参考图、位置、随身物品和剧情进度,每段拍完再看画面核对、写回。旗舰模型 Murea-Pro 在多轮交互评测 WBench 上以 81.1 分排第一,比第二名高 0.1 分,这是团队自测提交、50 步慢速配置的成绩;“3.6 秒拍完 5 秒 720p 视频”是另一套 4 步蒸馏版。开源的是基于 LTX-2.5 的轻量版 Murea-Fast 和智能体 Murea-Mind,Murea-Pro 还没发布。
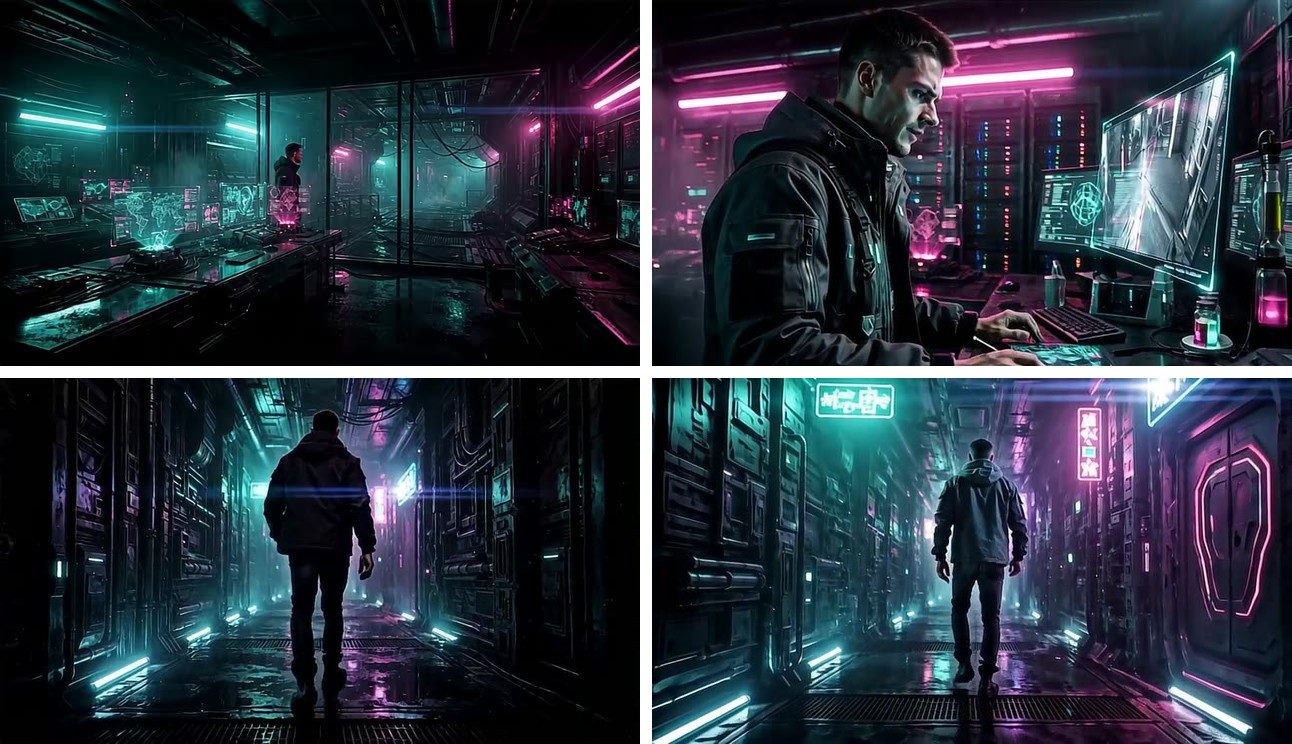
Murea-InWorld 的官网上有一个 10 段的故事,叫“孤岛谍影”。第 1 段,主角站在泛着幽蓝微光的控制室里;第 5 段,他把一段可疑的干扰数据打包,存进随身的便携数据盘;第 6 段,他把数据盘握在手里;第 7 段起,他走出控制室,沿着湿漉漉的金属长廊往前,到第 10 段,转角透出一点红光。每一段都是 AI 生成的视频,下一段演什么,由玩家打的一句话或从推荐里选的一项决定。
难点在“接着拍”。视频模型每次生成都从头开始,上一段主角穿的哪件外套、数据盘在谁手里,它并不记得。Murea-InWorld 是 Murea Labs 团队 10 月 17 日公开的交互视频系统,它的思路是不指望视频模型记事,在模型外面另记一本账。机器之心以“双榜第一”报道了它;第一名的分数和“实时”的速度各自来自哪套配置,也值得对一下。
视频模型不记事,Murea-Mind 在外面记一本账
技术报告把前提说得很直白:生成器在两次调用之间不保留记忆;这个世界背后也没有物理模拟器,一条指令只是描述“想让什么发生”,到底发生没有,只能看拍出来的画面。
所以 InWorld 分成两层。下层是视频模型 Murea,分旗舰版 Murea-Pro 和轻量版 Murea-Fast,只管把这一段拍出来;上层是智能体 Murea-Mind,在模型外面维护一份看得见、查得到的世界状态,分五块:
- 资产登记:每个人物、物品、地点各有一张参考图、可选的声音样本和一段“锁定描述”。描述定一次,后面原样复用;故事回到去过的地点,直接取同一张参考图,不让模型重新描述一遍。新角色、新地点在第一次出场前先登记、先画好参考图。
- 动态状态:人物在哪、穿什么、看起来怎样、情绪和目标;地点的时间、天气、光线和道具。长相归资产,变化归状态,两边分开记。主角捡到的东西要记进随身物品,因为锁定描述不会反映故事里新得到的东西。
- 剧情:主线、阶段、支线、当前目标,每轮一句话摘要。生成用的提示词不进剧情记录,免得把旧画面的渲染细节带进后面的规划。
- 地点图:哪些地点相通,角色走动时按已知路线走。
- 片段树:每段视频是一个节点,存着父节点、指令、提示词、参考图顺序、画面,以及生成前后的状态快照。
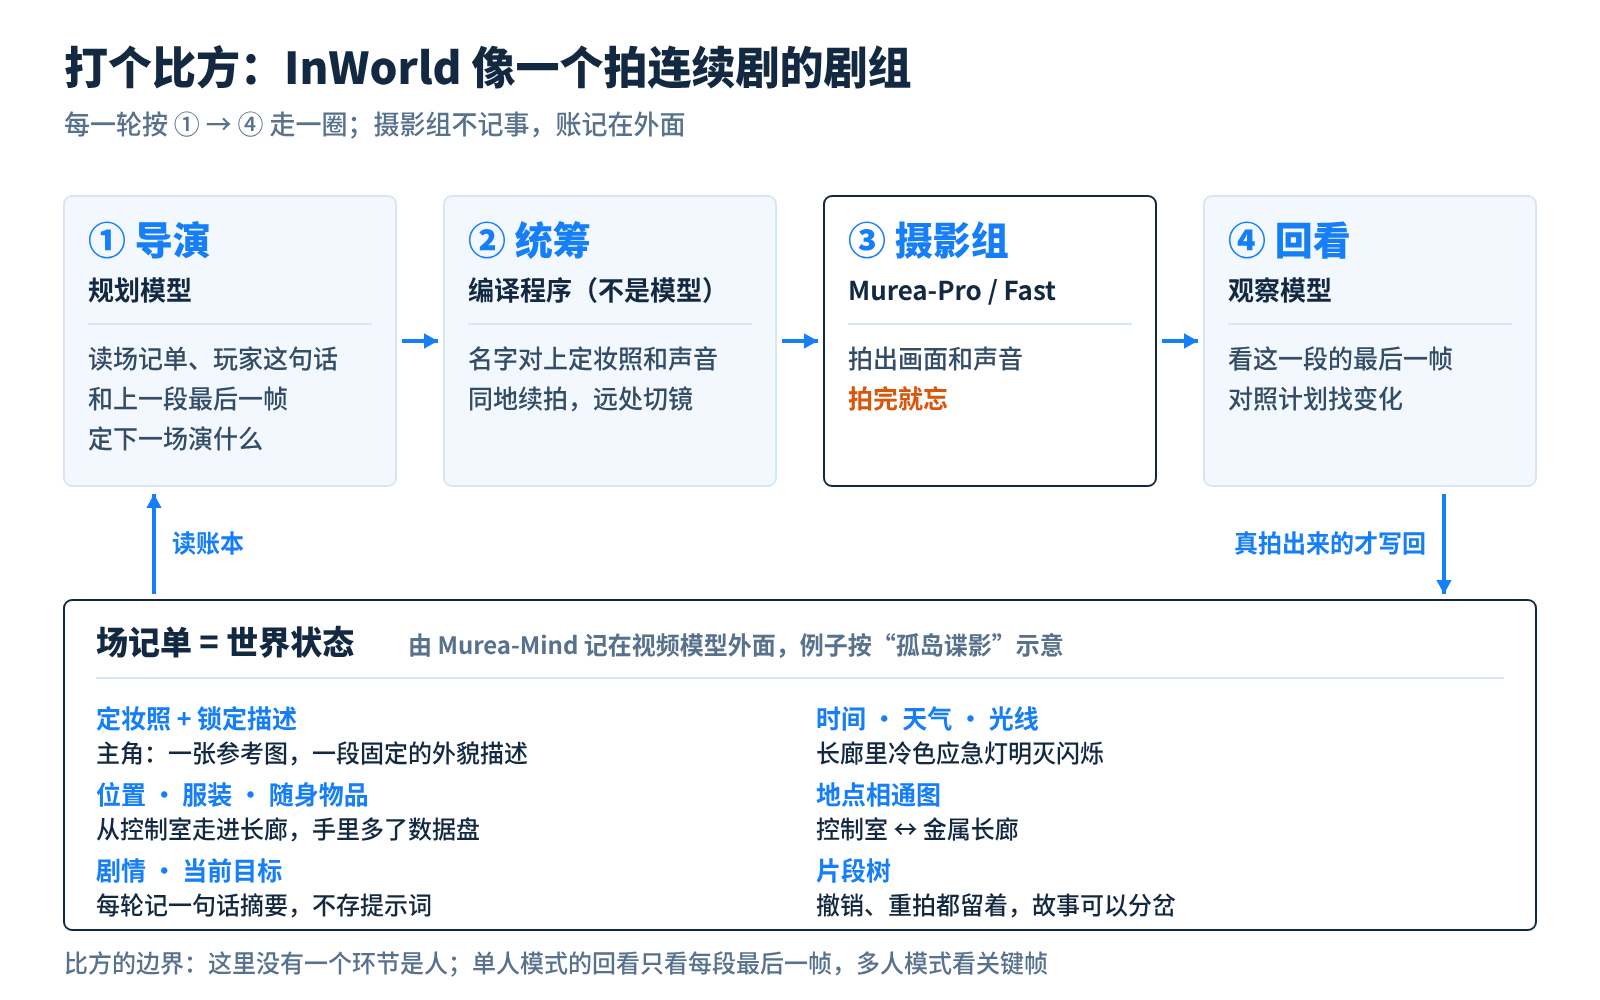
打个比方,这像一个拍连续剧的剧组。摄影组(视频模型)只管拍眼前这一条,拍完就忘;场记单(世界状态)记着每个角色的定妆照、人在哪、手里拿着什么;导演(规划模型)看着场记单和玩家这句话决定下一场;统筹(编译程序)把安排翻成拍摄单;拍完有人回看监视器,确认真拍出来了,才记回场记单。这个比方有两处边界:这里没有一个环节是人,单人模式下“回看”也只看这一段的最后一帧。
一轮交互:规划、编译、拍摄、回看
规划。 规划器是一个多模态大模型,读三样东西:世界状态的快照、玩家这句话、上一段的最后一帧。快照告诉它有哪些角色、各长什么样,最后一帧告诉它上一段实际停在什么姿势和构图。它输出一份指令:在哪、谁出场、发生什么、谁说哪句台词、状态要怎么变,再附几条下一步建议。一句话里事情太多时,比如“去市场找守卫说话”,它会拆开,这一轮只拍走到市场,剩下的改写成下一轮的输入自动接上,玩家随时可以打断。涉及推、拿、碰的动作,还要附一份动作计划(谁对谁、怎么靠近、什么时候接触、结束成什么样、镜头怎么取),先过一遍规则检查。
编译。 这一步是确定性的程序,不是模型。它把指令里的每个名字绑定到登记过的参考图和声音,展开成训练时用的分段式提示词,再决定续拍还是切镜:还在同一地点,或者连续走进相邻地点,就接着上一段的结尾续拍;跳到远处去过的地点,就用那里的参考图另起一个镜头。声音按说话人绑定,不按参考图的顺序,免得一张地点图被分到一副嗓音。
拍摄与回看。 视频模型拍出画面和声音后,观察模型看这段的最后一帧,对照计划,把确实发生的变化写回去:谁拿起了什么、放下了什么、新出现了谁,再更新目标和下一步建议。回看是异步的,视频可以先播。回看结果回来时,如果玩家已经撤销或改了世界,这次结果直接作废,靠比对世界的版本号判断。
撤销就是恢复生成前的快照,把“当前位置”退回父节点;之后再拍,新片段成为被撤销那段的兄弟节点,原片段保留。重新生成也一样,一个故事于是能长出几条分支。
多人模式让 2 到 4 名玩家(也可以是 AI 队友)各带一个角色。每人提交的动作先变成一份“动作合同”:谁、做什么、对谁、怎么走、结束成什么样。人齐以后,导演模型安排机位和先后,编剧模型写镜头文字并给每个动作留一个占位符,编译器把合同原样填回去,每份只出现一次,一轮拍成一个共享片段。只有画面里看得到的结果才进入“已确认历史”,计划里的事不算数。为了少等,当前片段播放时,系统已经按推荐动作把下一轮提前拍好,大家选的刚好一致就直接用。
Murea 拍摄:参考图钉住长相,画面和声音一起出
Murea 的核心做法叫全参考生成(Omni-Reference Generation)。人物、动物、物品、场景的参考图各自编码成一段“干净”的条件:不加噪声、不参与去噪,也不计入训练损失,每张带一个编号,在时间轴上排在正片之前,三张图就占第 −3、−2、−1 秒。它们只负责一件事:告诉模型每个角色长什么样。
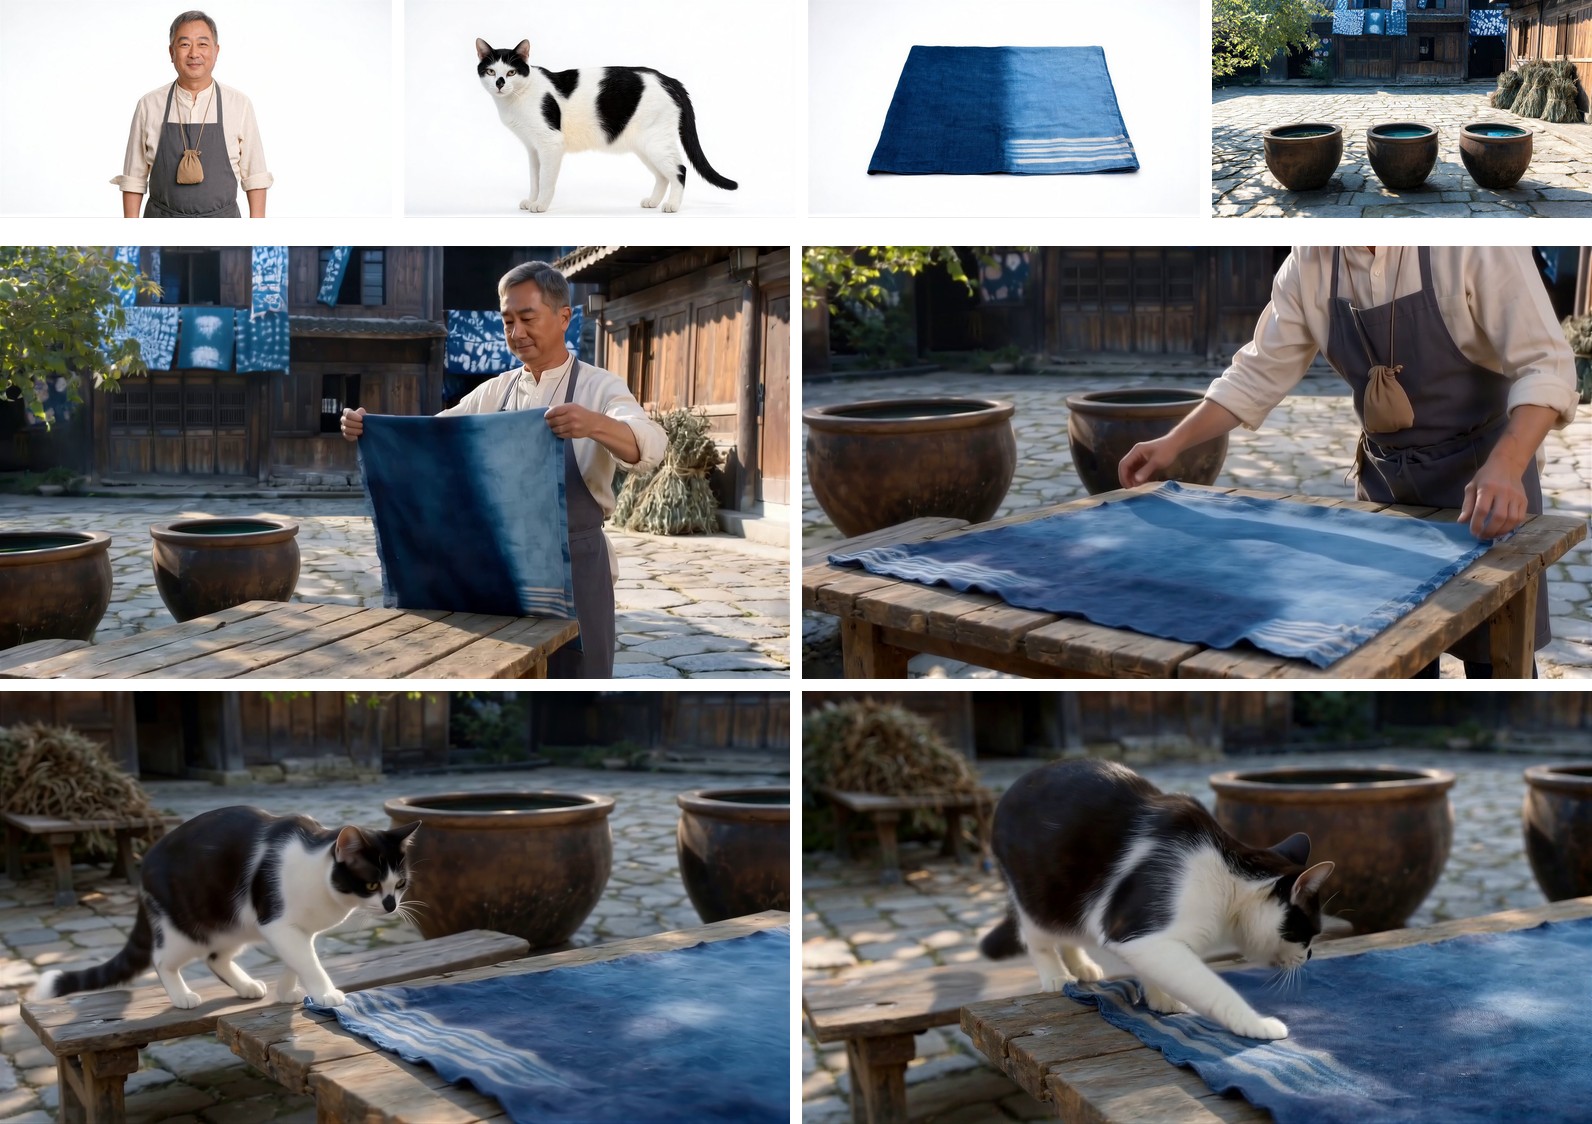
画面和声音在同一个 DiT(扩散 Transformer)里一起生成,视频和音频各走一路。参考信息先进入自己那一路,再经由正片的画面和声音互相影响,不直接参与音画之间的交叉注意力。训练数据是团队自建的数据加上 HuMoSet 数据集的一部分,先用人脸比对筛掉参考图和正片对不上的样本,再由人工按参考一致性、声音一致性和画质挑选。文字描述交给 Gemini 3.1 Pro 写成结构化格式:哪张图是谁、哪段声音属于谁、谁在第几个镜头说哪句台词。
续拍时,画面只带上一段作为历史,声音带得更长,用来接住没说完的半句话和语气,减少重说和断句。训练时还故意给历史加噪声或扰动:推理时的历史是模型自己拍的,难免有瑕疵,先让它见过不完美的前情。报告也写明,这只是让模型见过不完美的上下文,不等于覆盖了它自己会犯的全部错误。
边界同样写在文档里。声音参考这条路只做了功能验证,报告说还不能证明它能保住音色,或在多人对话里把声音配对正确。开源版的性能文档记了一条:三个角色同框时,换了几种参考图尺寸,都有大约一半的片段丢了一个角色,或者把两个人合成了一个。
3.6 秒拍完 5 秒视频:快的是 4 步蒸馏版
扩散模型生成视频要从噪声一步步去噪,默认 50 步,每一步都要把很长的音画序列过一遍网络。Murea-Pro 提速的第一刀是蒸馏:先用 MeanFlow(何恺明团队 2025 年提出的方法,让模型学一段时间区间上的平均速度,一步能跨得更远)让少步数的学生模型跟着老师走,再用分布匹配蒸馏(DMD)修正生成结果的分布,补回细节和动作。
报告在 8 张 H20 上逐项叠加优化,生成同一段 5 秒有声视频。从 50 步蒸馏到 4 步,耗时从 231.6 秒降到 23.2 秒,这一刀就是 10 倍;后面三项分别是低精度的注意力内核、在相邻去噪步之间复用一段网络层的缓存,以及先用低分辨率生成再放大 1.5 倍,最后一项又快了 2.11 倍。四项叠完是 6.96 秒,累计 33.3 倍。
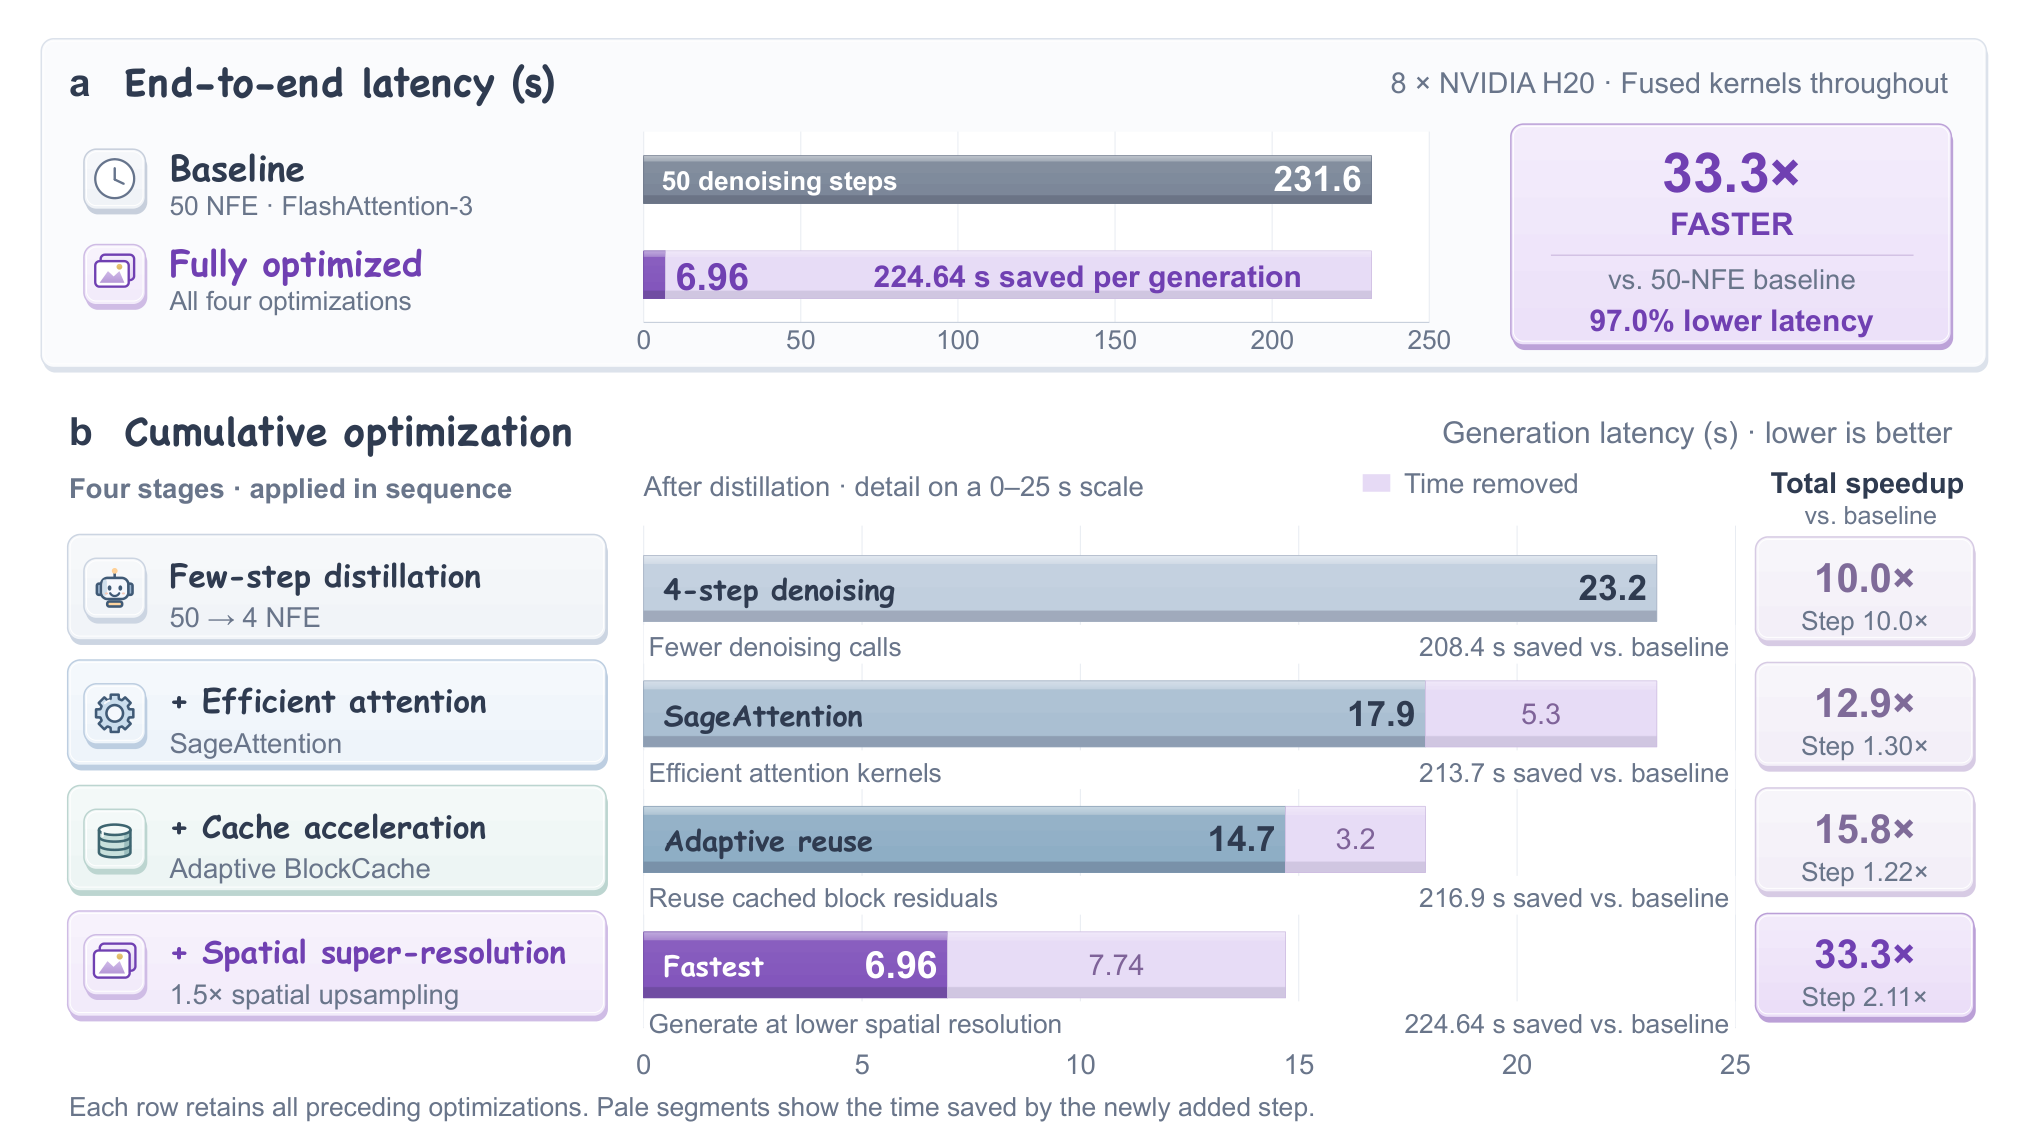
换到 RTX PRO 6000 Blackwell 显卡,同一套流程生成一段 5.04 秒的 720p 视频用 3.6 秒。实时系数是生成耗时除以视频时长,这里约 0.71,小于 1 就是拍得比播得快,“实时”说的就是这个。
读这个数要带上几个条件,官网自己也写了两条:计时是整段拍完的时间,不是边拍边播的首帧延迟;WBench 的分数用的是另一套 50 步配置。报告也没写这 3.6 秒用了几张卡。玩家实际要等的,还得加上大模型规划那一步。
双榜第一:WBench 81.1 分,比第二名高 0.1
WBench 是美团 LongCat 团队和复旦大学做的多轮交互视频评测。Full-289 这一组有 289 个案例、1,058 轮指令,分导航、角色动作、事件编辑、视角切换四类任务,从画质、设定遵循、交互(指令执行)、一致性、物理合理性五个维度打分。每一轮,模型拿到当前指令和自己上一段的最后一帧,后面几轮都在模型自己拍出的画面上接着评。
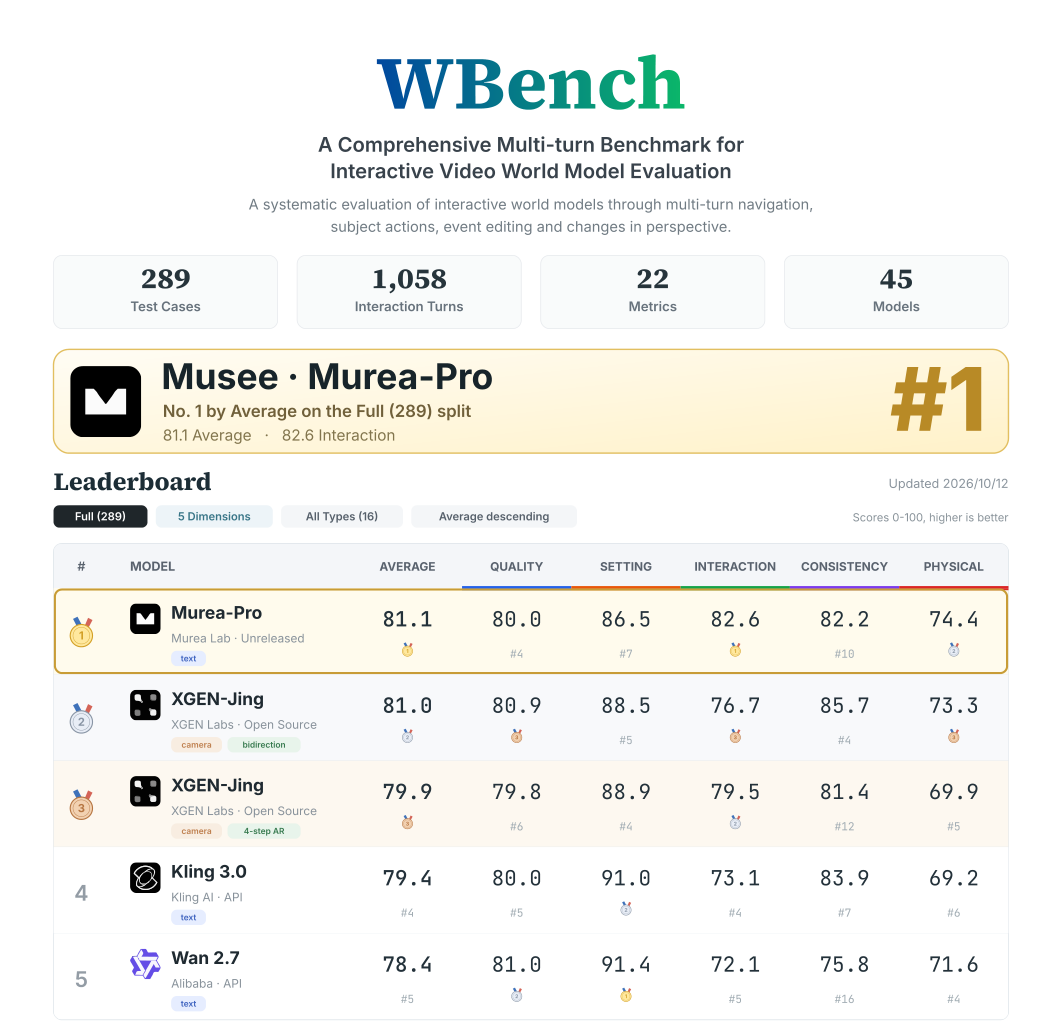
10 月 12 日更新的榜单上,Murea-Pro 以 81.1 分排第一,第二名是开源的 XGEN-Jing,81.0 分,第四名可灵 3.0 是 79.4 分。Murea-Pro 标注“未发布”,成绩是团队用公开评测代码自己跑完后提交的。这是 WBench 的默认提交方式,榜单方会抽一小部分复跑核对。
技术报告的对比表没有列 XGEN-Jing,拿可灵 3.0 当参照:交互 82.60 比 73.08,物理 74.42 比 69.19,是它领先最多的两项;画质基本持平,设定遵循低 4.48 分,一致性低 1.70 分。和 XGEN-Jing 比,交互 82.6 比 76.7,物理 74.4 比 73.3,设定和一致性则是 XGEN-Jing 更高。分任务看,事件编辑 90.92、角色动作 87.04、视角切换 80.65,导航只有 71.79,报告自己也把导航列为短板。
还有两点会改变对这个第一名的理解。一是配置:参评的是 50 步、1344×768、每轮 5 秒的版本,不是 3.6 秒的实时版。二是范围:WBench 只评视频模型,前面那本账和回看闭环没有参与打分,报告的说法是完整的智能体闭环“由系统设计给出”。
另一块榜是参考生视频评测 OpenS2V-Eval,180 个案例,从单张人脸到多人加物品。开源的 Murea-Fast 总分 64.98,在参评开源模型里排第一;衡量生成主体像不像参考图的 NexusScore 是 51.66,在参评的参考生视频系统里最高。字节的 Seedance 2.0 总分 67.13,比它高,但 180 个案例只交回 148 个,32 个涉及人脸和人物的请求被拒;只算这 148 个,Murea-Fast 是 66.11,差 1.02 分。官网首页那张排行没有放 Seedance 2.0。团队另做的扩展评测 OS2V-Pro 里,它比可灵 V3 Omni 低 0.2 分,声音质量和音画对齐也落后;报告承认其中两项检查清单取自 Murea-Fast 自己用的扩写提示词,在输入上占了便宜。
开源的是 Murea-Fast 和 Murea-Mind,Pro 还没放
GitHub 仓库放出了两部分:Murea-Fast 推理服务和智能体 Murea-Mind,代码用 Apache-2.0 许可;Murea-Fast 的权重放在 Hugging Face。拿下 WBench 第一的 Murea-Pro 没有发布,Murea-Mind 的文档写着它也支持完整版模型,只是还没放出来。
Murea-Fast 是从 Lightricks 的开源音视频模型 LTX-2.5 衍生出来的 8 步蒸馏版,权重约 42 GB,按 LTX-2 社区许可证发布,不是 Apache。它能用几张参考图生成 1280×704、每秒 24 帧、带台词和声音的视频,也能从上一段的最后 17 帧接着拍。硬件门槛不低:只在 NVIDIA 显卡上验证过,一张 H20 拍一段 5 秒视频,实测 45 到 100 秒不等,参考图越大越慢,显存峰值约 80 GB;四张 H20 并行一般在 15 到 20 秒。开源版离“实时”还远。
Murea-Mind 是网页应用加 Python 包,装了 Python 3.12 的机器就能跑,但要一个文本和图像模型的 API key:Gemini、任意 OpenAI 兼容服务,或者阿里云百炼(文本用 DeepSeek,画图用 Qwen-Image)。它负责规划剧情、画参考图,再调用 Murea-Fast 拍视频。在首页输入一句想法,它会设定世界、玩家角色、起点和主线目标,然后自动拍第一段;多人房间支持 2 到 4 人。推理服务和智能体都没有鉴权,文档提醒别直接放在共享网络上。
值得带走的三点
- 生成模型只管生成,状态记在外面。 长相靠参考图和锁定描述钉住,位置、物品、剧情放进可检查的结构里,每轮拿画面核对后再写回。长对话、长任务里的智能体也常遇到“模型记不住前情”,把记忆从模型里搬出来、交给可检查的外部状态,是同一个思路。
- 计划不等于发生。 InWorld 只把画面里看得到的结果记进已确认历史,预测单独放。“想让它发生”和“它确实发生了”分开记,后面的规划才不会建在没拍出来的事上。
- 看成绩先对配置。 第一名的分数来自 50 步版,“实时”来自 4 步版;榜单只评视频模型,没评那本账;领先第二名 0.1 分。现在能拿到手的是基于 LTX-2.5 的 Murea-Fast,要 80 GB 级的显卡和一个大模型 API key,三个角色同框时还不稳。