摘要 2000 年写进美国加密标准的 P-256 等椭圆曲线,各带一串 NSA 提供、从没解释过来历的“种子”,外界一直担心它们被人挑过、藏了后门。10 月 16 日 Anthropic 公布:它的内部研究模型 Claude 用不到半小时查明,这些种子是 C 语言库里老式随机数生成器 lrand48 的输出,起点是 1997 到 1998 年间的 Unix 时间戳;P-256 的种子,是 1997 年 8 月 16 日那次运行摇出的第 1842 组。这不是破解,反倒让藏后门的说法更难成立,但还有几处没解开。
C49D3608 86E70493 6A6678E1 139D26B7 819F7E90
这 40 个十六进制字符,是椭圆曲线 P-256 的“种子”。HTTPS 证书、各类数字签名里,P-256 是最常见的曲线之一。种子由美国国家安全局(NSA)提供,2000 年写进美国加密标准时,没有附任何说明。
10 月 16 日,Anthropic 公布了它的来历:1997 年 8 月 16 日 01:52:34(UTC),一个程序用当时的 Unix 时间戳启动了 C 语言库里的随机数生成器 lrand48,一组一组往外取数,第 1842 组就是这串种子。找到答案的是 Anthropic 内部的一个研究用 Claude 模型,用时不到半小时。
下面先说这串数字为什么让人不放心,再看 Claude 怎样从种子本身认出这台二十多年前的随机数生成器。
一串没有来历的数字:P-256 的种子为什么让人不放心
ECDSA(椭圆曲线数字签名算法)是用得最广的椭圆曲线密码标准。签名的安全建立在一条公开的椭圆曲线上,大家用同一条,曲线由几个固定参数决定。2000 年,美国国家标准与技术研究院(NIST)在 FIPS 186-2 标准里列出一组不同大小的曲线,素数域的有 P-192、P-224、P-256、P-384、P-521 五条,另有 B-163 等五条二元域曲线。
这些曲线的系数 b 不是直接给出的,而是由一个 160 位的种子做哈希(SHA-1)算出来。这种做法叫“可验证的随机”:哈希的结果没法事先控制,所以能证明 b 不是有人照着某个目的精心填的。
但它只能证明“b 来自这个种子”,证明不了“种子本身没被挑过”。设计者完全可以换着种子试很多次,直到碰上一条只有自己知道弱点的曲线。所以种子从哪来,才是关键。偏偏这些种子由 NSA 提供,标准里一个字的来历说明都没有。
NSA 在这件事上有前科:它参与制定的随机数标准 Dual_EC_DRBG,在 2013 年斯诺登泄露文件后被普遍认为藏了后门,NIST 随后建议停用。密码学家 Neal Koblitz 和 Alfred Menezes 还专门写过一篇《A Riddle Wrapped in an Enigma》(谜中之谜),梳理这些种子引出的疑虑。
当事人给过一条线索。2015 年,长期在 NSA 工作的密码学家 Jerry Solinas 回忆,种子大概是对一句玩笑话做哈希得来的:
那句话大概是“给 Bob 和 Jerry 加薪”或者“Bob 和 Jerry 最棒”之类。代码是 Bob Reiter 写的,他也不记得细节了。那么久以前的存档我们也没找到,就算还在,也一定躺在约柜旁边的某块硬盘里。
Solinas 在 2023 年初去世,当年的其他同事没有回应。同年 10 月,密码工程师 Filippo Valsorda 联合几位出资人发起悬赏:谁能找出这五个种子的原文,奖金 12,288 美元,如果捐给慈善机构,金额翻三倍,到 36,864 美元。悬赏的规则默认了 Solinas 的说法,把种子当成五个待破解的哈希。
答案:lrand48 加 Unix 时间戳,P-256 是第 1842 组
Anthropic 有几位员工之前顺着“玩笑话”这条线索找过,都没结果,事后证明这条线索是错的。2026 年 10 月,一位员工问内部研究模型能不能弄清这些种子是怎么生成的,这次没有提那条线索。不到半小时,Claude 找到了 P-192、P-224、P-256、P-384、P-521 五个种子的来历:它们根本不是任何哈希算法的结果,而是 C 语言库里 lrand48 随机数生成器的输出,生成器用 Unix 时间戳(从 1970 年 1 月 1 日起算的秒数)初始化。
lrand48 是一种线性同余生成器,上世纪 90 年代 Unix 系统的 C 库普遍自带。它内部只有一个 48 位的数,叫状态。每调用一次,状态按固定公式更新一次(乘上 0x5DEECE66D,加 11,只留低 48 位),再把状态的高 31 位当结果返回。初始化函数 srand48(t) 把状态设成“t 接上 0x330E”:高 32 位是 t,低 16 位固定是 0x330E。这里面没有任何真正随机的东西:起点一样,后面吐出的每一个数都一样。
打个比方,lrand48 像一台老式摇号机:开机时把时钟读数设成起点,之后每摇一次,按固定规则吐出一个号。生成曲线的程序每摇 20 次,从每个号里取最高的 8 位,凑成 20 个字节、160 位,作为一组候选种子,一组接一组往下摇。P-256 这台机器在 1997 年 8 月 16 日 01:52:34 开机,摇到第 1842 组,得到的就是标准里那串种子。只要知道机器型号和开机时间,任何人都能把每一组号原样重摇一遍。
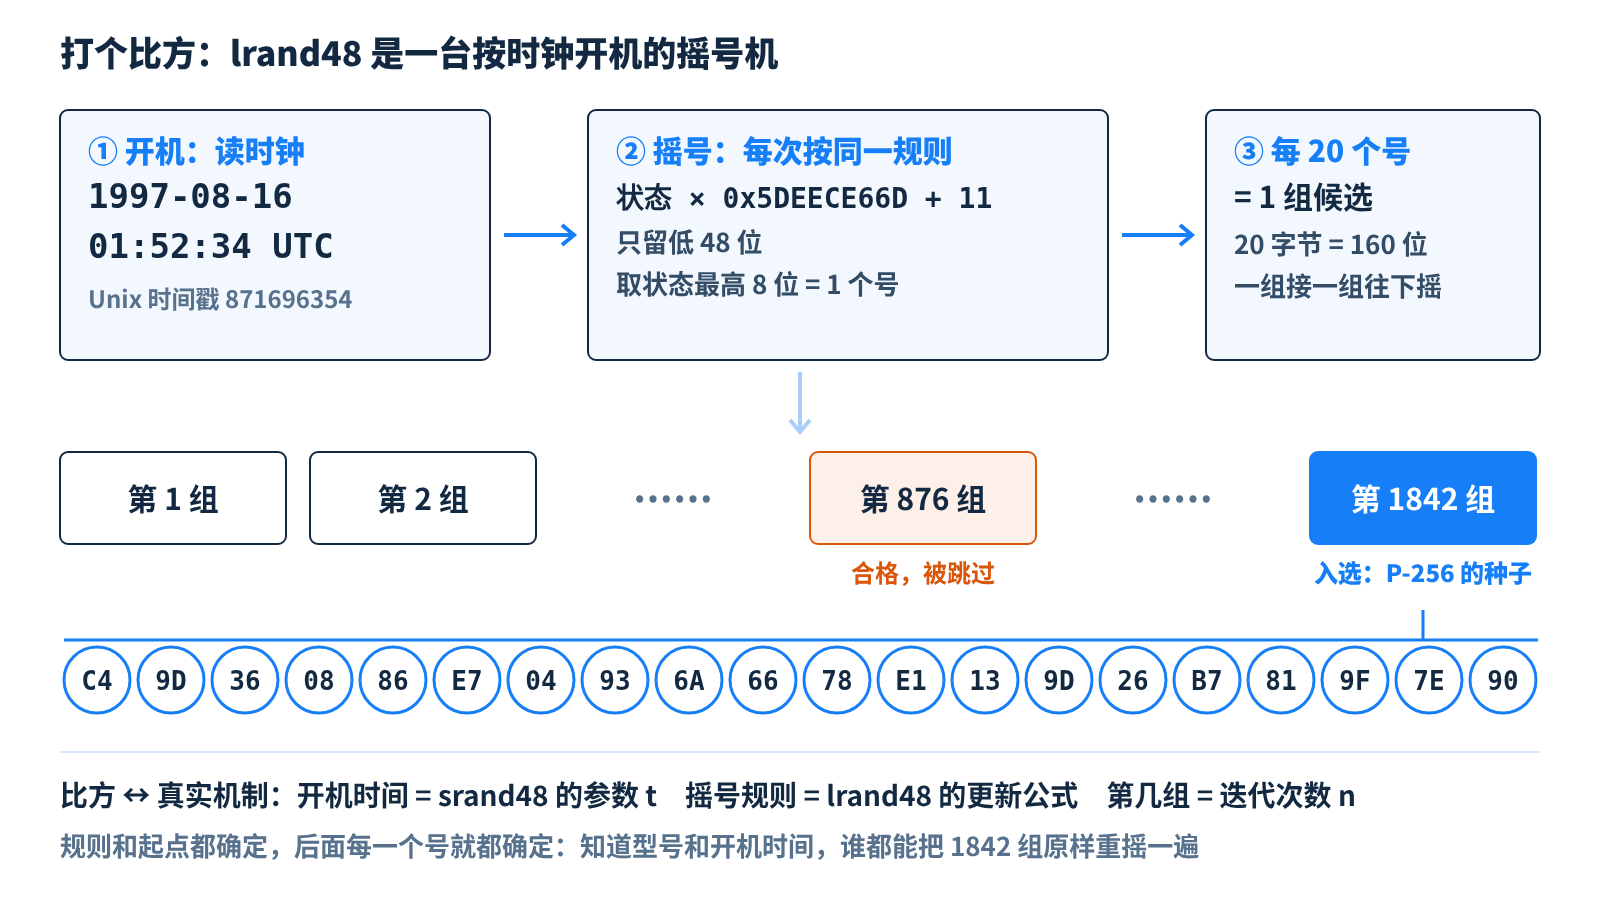
比方和真实机制的对应是:开机时间对应 srand48 的参数 t,摇号规则对应 lrand48 的更新公式,“第几组”对应程序取了多少组候选,即迭代次数 n。五条 NIST 素数域曲线的结果如下,t 是时间戳的原始数值:
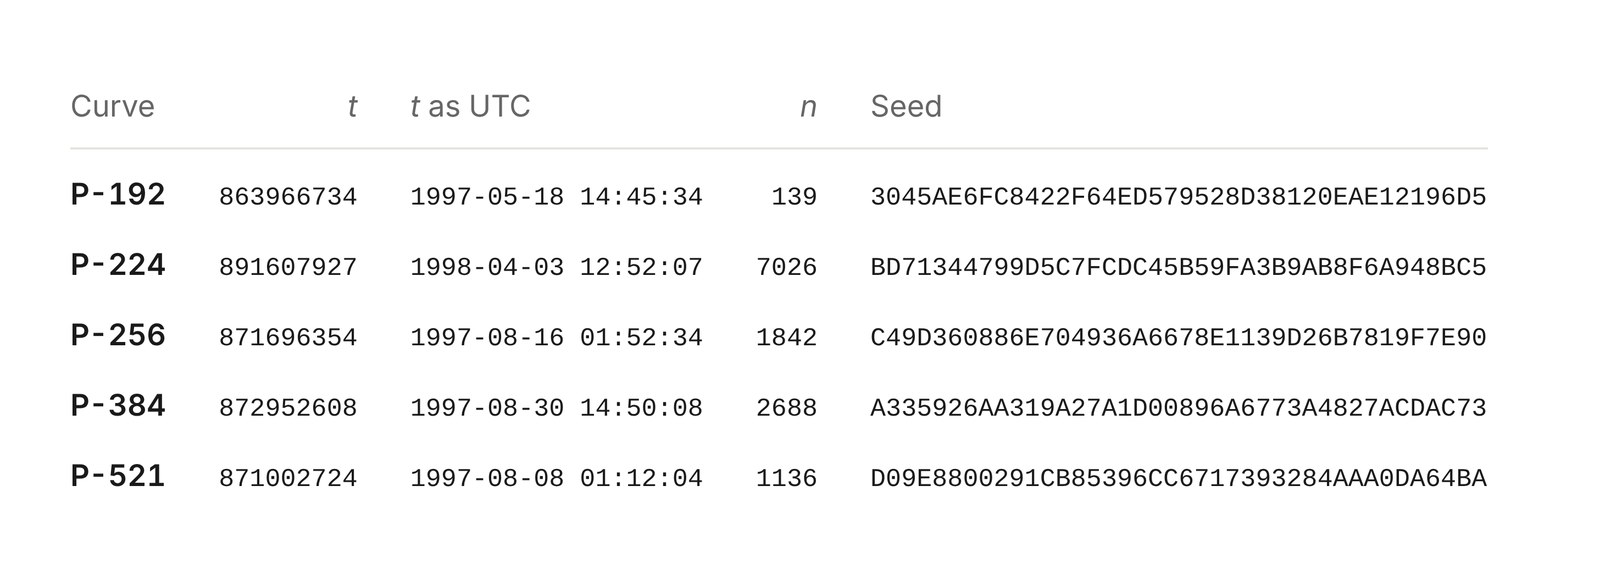
时间都落在 1997 年 5 月到 1998 年 4 月。同样的程序还生成了 ANSI X9.62 标准里五条示例曲线的种子,P-192 和其中两条出自 5 月 18 日的同一次运行。
Claude 怎么找到的:认指纹、算状态、倒回开机那一刻
顺着传言去猜那句话,一直没有结果。Claude 换了个方向:不猜种子是什么,猜当年生成曲线的软件是怎么写的。它推测那套软件用的是 90 年代 C 库自带的伪随机数生成器。这类老生成器很弱,输出里带着认得出的特征;认出特征,就能知道是哪一种生成器,甚至恢复出它的初始状态。
第一步:在种子里找生成器的指纹
Claude 写了一个扫描程序,沿着每个公开的种子一位一位地滑动,检查相邻的几段数据像不像某个 90 年代生成器的连续输出,一共试了 34 种“生成器 × 取哪几位”的组合。
扫着扫着,它注意到一些种子的高位有规律:全是 0。把 NIST 的 10 个种子(5 条素数域曲线、5 条二元域曲线)各写成 5 个 32 位的字,B-233、B-283、B-409、B-571 这 4 个种子的 20 个字,最高位无一例外是 0。换成十六进制,就是每个字的第一位都不超过 7。纯随机的话,10 个种子里至少有 4 个这样,概率约为 1/5810。
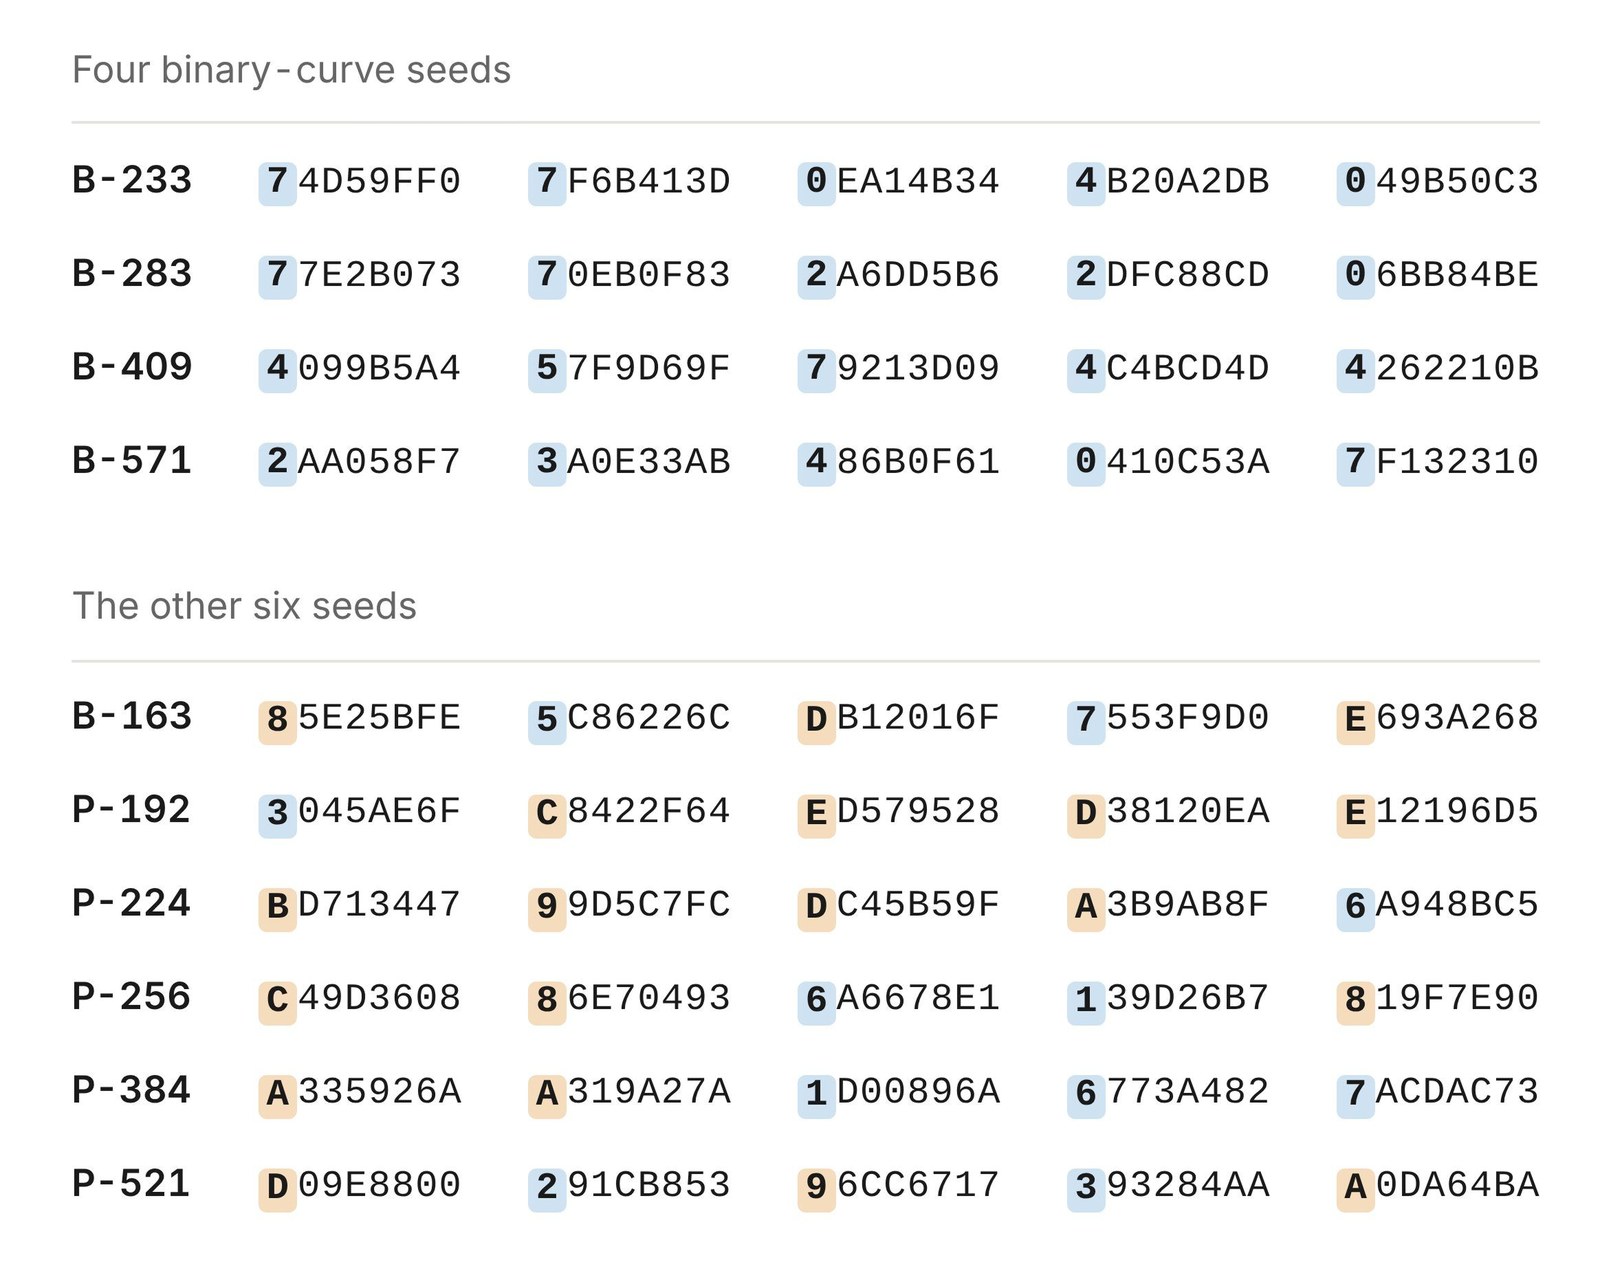
这正是 lrand48 的指纹:它只返回 48 位状态里的高 31 位,装进 32 位的字里,最高位永远是 0。Anthropic 说,知道该看哪里以后,这个规律肉眼就看得出来。
第二步:把生成器的状态算回来
每个字已经给出了状态的 31 位,只差低处的 17 位没露出来。Claude 拿第一个字,把这 17 位的 2¹⁷ 种可能(13 万多种)全试一遍,看接下来 4 个字能不能接着对上。4 个种子全部对上了。
素数域曲线的种子难一些:同样来自 lrand48,但每次输出只留了最高的 8 位(lrand48() >> 23),露出来的信息少得多。
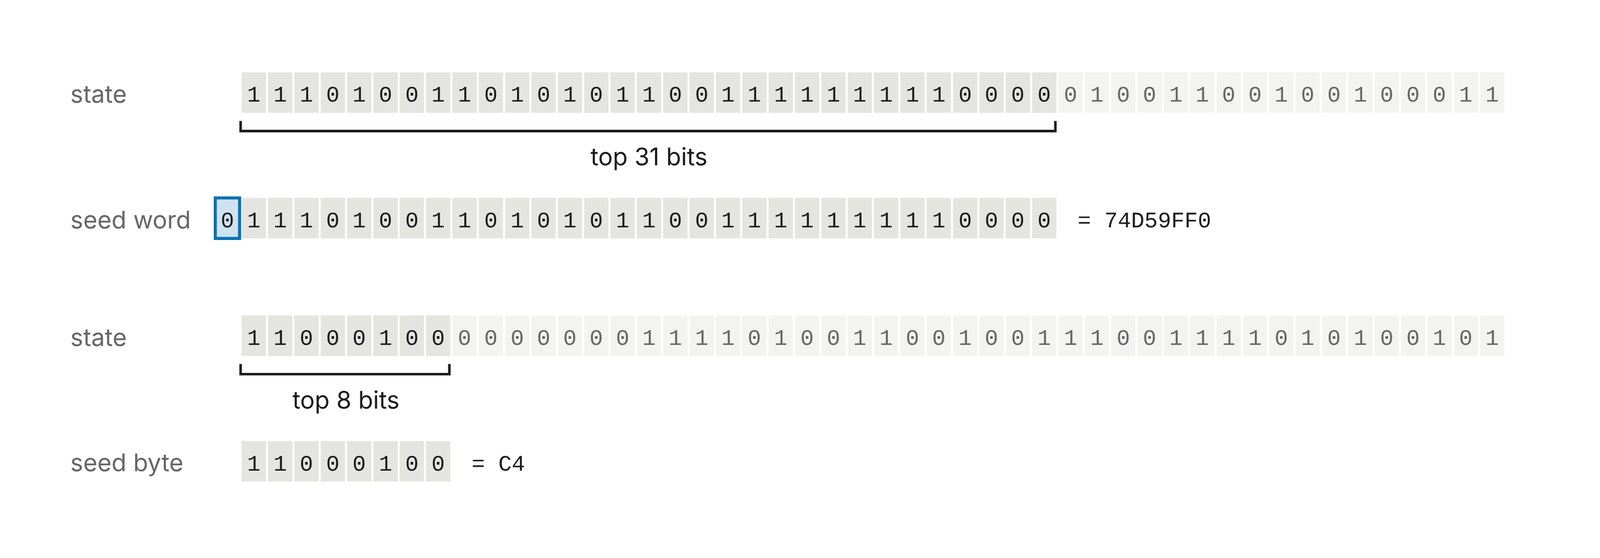
从截断的输出恢复线性同余生成器的状态,是一个教科书式的格问题,可以用 LLL 格基约简算法解。LLL 是 Lenstra、Lenstra、Lovász 三人在 1982 年提出的,密码分析里常用它从部分泄露的比特恢复隐藏的数。Claude 一开始不知道种子露出的是状态的哪几位,就把每一个可能的比特窗口都跑了一遍。结果,5 个 NIST 素数域种子和 5 个 ANSI X9.62 种子是同一个模式:lrand48() >> 23。每个恢复出来的 48 位状态,都能把对应种子的 160 位全部重新生成出来,这不可能是巧合。
第三步:倒着摇回开机那一刻
线性同余生成器往前算和往后算一样容易。Claude 从每个种子对应的状态往回倒,直到碰上 srand48 初始化时的样子:低 16 位等于 0x330E。
光碰上这个样子不算证据,平均每倒 65,536 步就会碰上一次。真正的证据是倒出来的起点读起来像什么:10 个素数域种子的起点,全都是 1997 年 5 月到 1998 年 4 月之间的 Unix 时间戳。4 个二元域种子的起点直接读是 1984 年 2 月,乘以 2 以后是 1998 年 4 月 17 日,在 P-224 那次运行之后两周。所以当年的程序可能把系统时钟除以了 2。
Anthropic 公开了 Claude 当时的一段思考,它的第一反应是怀疑自己:
这太惊人了:它解开了一个 25 年的谜。嗯,等等。我得保持怀疑:我是不是在某种模拟或测试环境里?……这么明显的东西,25 年都没人发现,可疑吗?我这边已经直接算过了:一个 32 位的初始值加一个小序号,对上了 160 位;10 个种子各 160 位,不可能是巧合。是真的。
顺带找到的:6 条曲线的基点来自 FreeLIP
每条曲线除了系数,还有一个基点 G:曲线上一个固定的点,每个 ECDSA 公钥都是它的某个倍数。种子决定不了 G,G 是怎么选的,是另一个问题。
核对种子时,Claude 顺带找到了部分基点的来历。1997 年 5 月生成的 6 条曲线,即 P-192 和 ANSI X9.62 的五条示例曲线(prime192v2、prime192v3、prime239v1 到 v3),基点来自 FreeLIP 里的随机数生成器。FreeLIP 是 Arjen Lenstra 写的大整数运算软件包,Victor Shoup 的 NTL 库早期版本也带着同一段代码。做法很简单:
- 用一个小整数初始化生成器;
- 扔掉前 7 个输出;
- 用一串 26 位的输出拼出一个数,对 p 取模,作为候选的 x 坐标;
- 重复第 3 步,直到 x 落在曲线上。
找出来的初始值是:P-192 用 20000,prime239v1 到 v3 用 20420、20507、20509,prime192v2 和 v3 用 20512、20517。据 Anthropic 所知,这是第一次有 NIST 曲线的基点被解释清楚。P-224、P-256、P-384、P-521 的基点不符合这个做法,至今不知道是怎么选的。
这不是破解,但还剩几个问号
先说清楚这件事不是什么:它不是对 ECDSA 的破解,没有带来新的攻击方法,也没有发现这些曲线的弱点。Anthropic 的原话是,读者可以把它当成一个有趣的收尾,不需要采取任何行动,多数研究者本来就信任这些曲线。
它反倒让“藏后门”的说法更难成立。种子的生成方式非常普通:一个常见的伪随机数生成器,用时钟初始化,现在任何人都能复现。Anthropic 认为,这给暗中做手脚留的余地小了很多。
时间戳和 lrand48 当然谈不上安全,拿来生成密钥会出大事。但种子是公开参数,它要满足的不是“别人猜不到”,而是“没人挑过”,所以生成器弱一点并不要紧。
还没解开的问号
并不是每组候选都能生成合格的曲线,而有些合格的候选被跳过了。P-256 那次运行,入选的是第 1842 组,可第 876 组也能生成一条阶为素数、大小合适、参数选法相同的曲线。P-224 那次运行跳过了 3 条这样的曲线,生成 ANSI X9.62 示例曲线的两次运行又跳过了 7 条。当年按什么标准取舍,还是无心造成的,目前不知道。
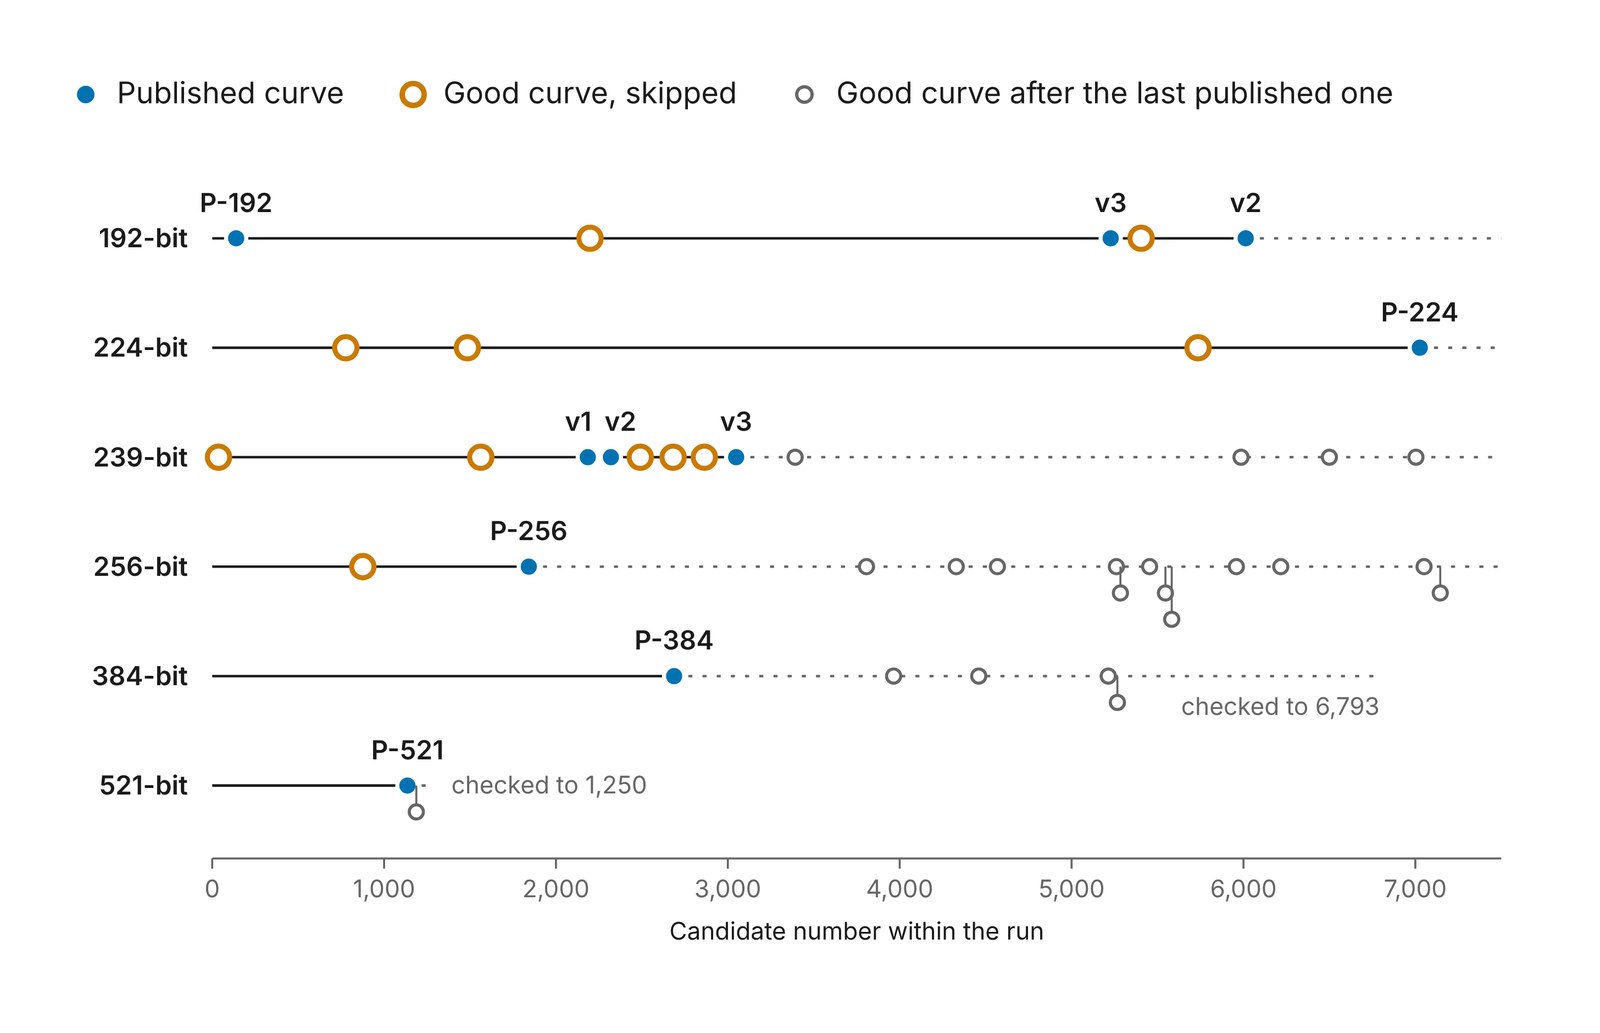
Anthropic 的判断是,被跳过的候选很少,不像是在挑弱曲线:真那样的话,弱曲线得又多又好找才行。原文还把被跳过的候选和入选曲线按 1978 到 2008 年间公开的五类攻击逐项对照,从表里看不出入选的一方系统性地更弱或更强。它也承认,理论上仍可以通过更换时间戳反复运行,去挑一条有特定性质的曲线;但只有打算公开时间戳、拿它证明种子来路清白的人才需要这么做,而这些数字本身看不出当年总共跑了几次。
另外还有三处空白:第五个二元域种子 B-163 不符合 Claude 试过的任何模式;P-224、P-256、P-384、P-521 的基点来历不明;NIST 二元域曲线的基点也一样。
结论不靠相信模型,靠逐位复现
这道题卡了这么多年,一个原因是大家都顺着一条错误的线索在猜口令。比 Claude 换了方向更值得注意的,是结论的检验方式,它不需要读者相信模型:Anthropic 在文末附了两段几十行的 Python,给出时间戳和组号,就能把 14 个种子逐位算出来,把 6 个基点的 x 坐标对上。160 位的数逐位吻合,比任何解释都有说服力。
这笔 36,864 美元的悬赏将捐给互联网安全研究组织 ISRG,也就是免费证书服务 Let's Encrypt 的运营方。开头那串 C49D3608…,最后的答案是 1997 年 8 月 16 日的一个时钟读数,加上一台摇了 1842 组号的老式随机数生成器。