摘要 大模型 API 的输出几乎总比输入贵:GLM-5.2 每百万 token 输入 8 元、输出 28 元,DeepSeek、Claude 的输出单价也是输入的 3 到 5 倍。原因在 Transformer 的工作方式和 GPU 的结构:模型每处理一个 token,几乎每个参数都要从显存搬到计算单元过一遍,像发一趟班车。读输入(预填充)时整段提示词一起上车,瓶颈是算力;写输出(解码)时下一个 token 要等上一个写出来,一趟只拉一个,算力大半在等数据,瓶颈是显存带宽。拼车(批处理)能摊薄,但每个用户的 KV 缓存都占显存;模型大到要多机部署,还要等通信。DeepSeek 公布的线上统计里,每台服务器每秒读 7.37 万个 token,只写 1.48 万个。
打开智谱开放平台的价目表,GLM-5.2 这一行写着:每百万 token,输入 8 元,输出 28 元。模型写出来的价格,是读进去的 3.5 倍。
换成一次具体的使用:让 AI 读一份 2,000 个 token 的材料(中文大约两三千字),写一段 500 个 token 的总结。读材料收 1.6 分钱,写总结收 1.4 分钱:总结只有材料的四分之一长,收的钱却差不多。用过 AI 的人也见过另一种不对称:贴进去一大段材料,它没多久就开始回答,回答却是一个字一个字往外蹦。读得快、写得慢,和写得贵是同一个原因。
服务商最大的开销是 GPU。DeepSeek 估算推理成本时,假设每张 H800 每小时租金 2 美元。一张卡一小时的钱基本固定,这一小时里处理多少 token,决定了每个 token 摊多少钱。下面就拿这份材料和这段总结,看看模型和 GPU 在读和写的时候各在忙什么。
价目表:输入、输出、缓存三档,输出价是输入的 3 到 5 倍
先把价目表上的几个词说清楚。Token 是模型读写文字的基本单位:英文里常常是一个词或半个词,中文大致一到两个字。厂商把模型部署在自己的机房,开发者调用 API、按 token 付费,这种模式叫 MaaS(模型即服务)。价目表大多分三档:
- 输入:发给模型的全部内容,包括系统提示词、对话历史、文档和问题。
- 输出:模型生成的内容,深度思考的过程也算。
- 缓存命中:这次输入的开头和之前某次请求完全相同,服务商复用上次算好的中间结果,按低价计。
几家厂商 10 月的官方价目表(每百万 token):
| 模型 | 输入 | 缓存命中 | 输出 | 输出是输入的 |
|---|---|---|---|---|
| GLM-5.2 | 8 元 | 2 元 | 28 元 | 3.5 倍 |
| DeepSeek V4.1 Flash(高峰时段) | 2 元 | 0.04 元 | 8 元 | 4 倍 |
| DeepSeek V4 Pro(高峰时段) | 9 元 | 0.30 元 | 27 元 | 3 倍 |
| Claude Opus 5.5 | 4 美元 | 0.20 美元 | 20 美元 | 5 倍 |
| Claude Sonnet 5.5 | 2 美元 | 0.10 美元 | 10 美元 | 5 倍 |
各家的排序完全一致:缓存命中最便宜,输入其次,输出最贵,输出单价是输入的 3 到 5 倍。这个排序不是营销习惯,三档各对应 GPU 上一笔不同的账。文中出现的名词,文末附录有一张速查表。
模型在算什么:一个 token 怎样穿过 Transformer
今天的大模型几乎都建立在 Transformer 结构上。模型的本体是一大堆数字,叫参数,也叫权重,是训练时学出来的,一层层排好。Qwen2.5-32B 有 325 亿个参数,分成 64 层。
一个 token 进来,先变成一串数字(向量,Qwen2.5-32B 是 5,120 个数),再依次穿过这 64 层。每一层做两件事:
- 注意力:回头看前文。每个 token 都会算出三组向量:Query(我想找什么)、Key(我这里有什么)、Value(我的内容)。当前 token 拿自己的 Query 和前面每个 token 的 Key 比一比,越相关的,就从它的 Value 里取得越多。
- 前馈网络:把取回来的信息加工一遍。Qwen2.5-32B 八成以上的参数在这一步。
穿过最后一层,模型给出下一个 token 的候选和概率,挑一个写出来。
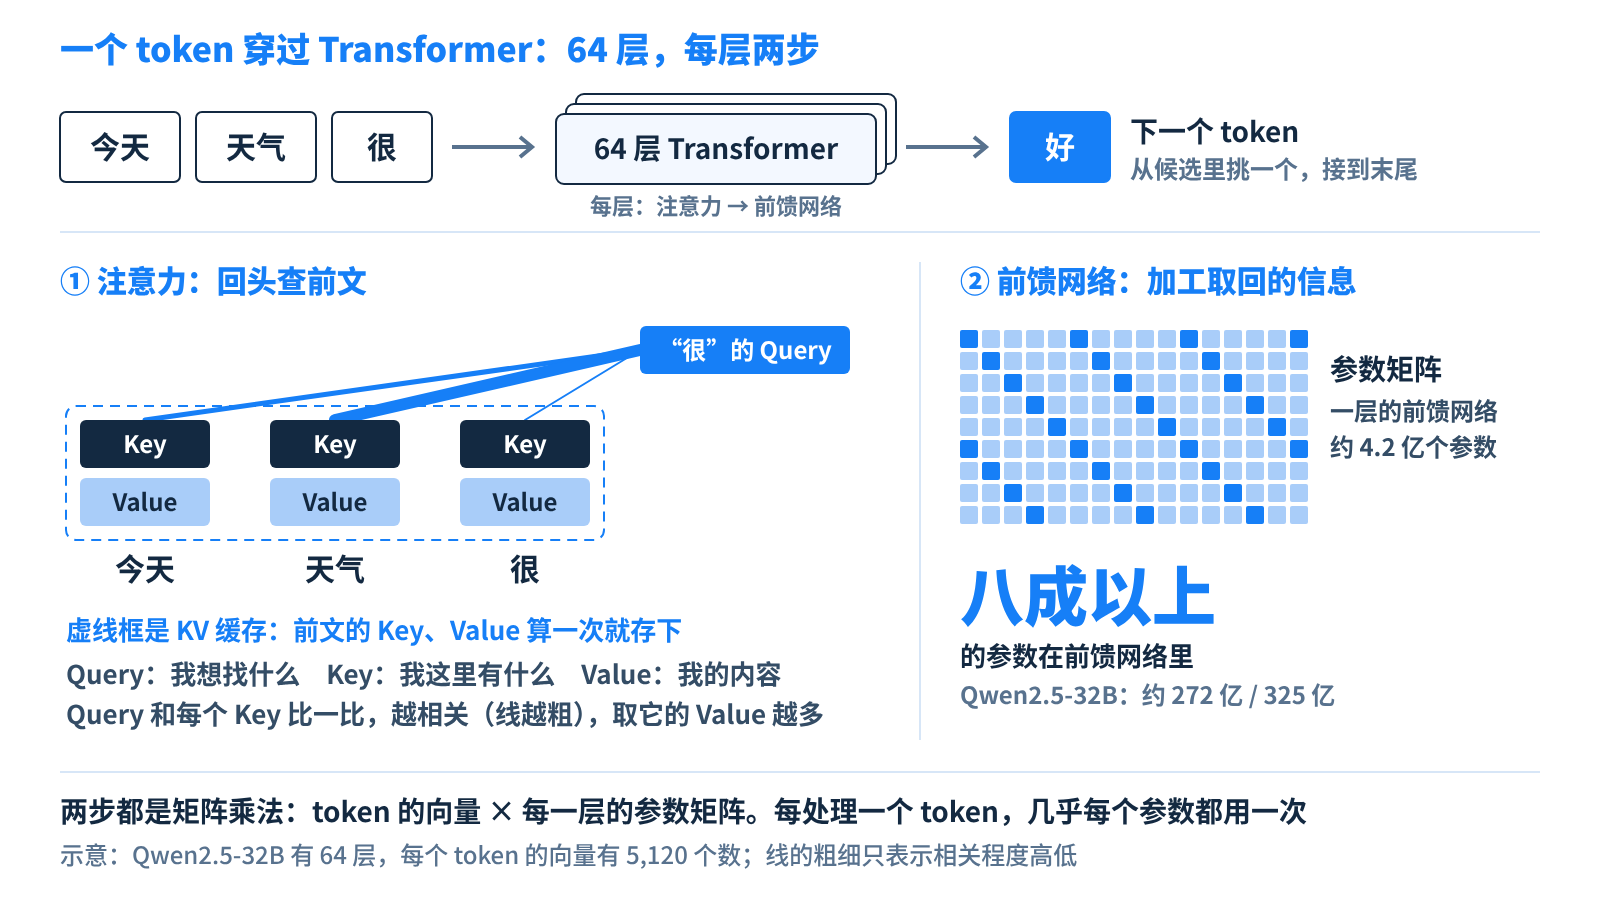
这两步几乎全是矩阵乘法:token 的向量乘上每一层的参数矩阵。所以模型每处理一个 token,几乎每个参数都要参与一次乘法和一次加法。
前面 token 的 Key 和 Value 算出来就不再变。把它们存下来,之后每个新 token 直接拿来比对,不用重算前文,这份存档叫 KV 缓存,可以理解成模型读前文时记下的笔记。
拆开一张 GPU:算力看 Tensor Core,搬数据看 HBM
这些矩阵乘法交给 GPU 来做。GPU 里干活的地方和放参数的地方是分开的:参数平时放在显存里,要用时得先搬到计算单元跟前。以英伟达的 H100 为例:
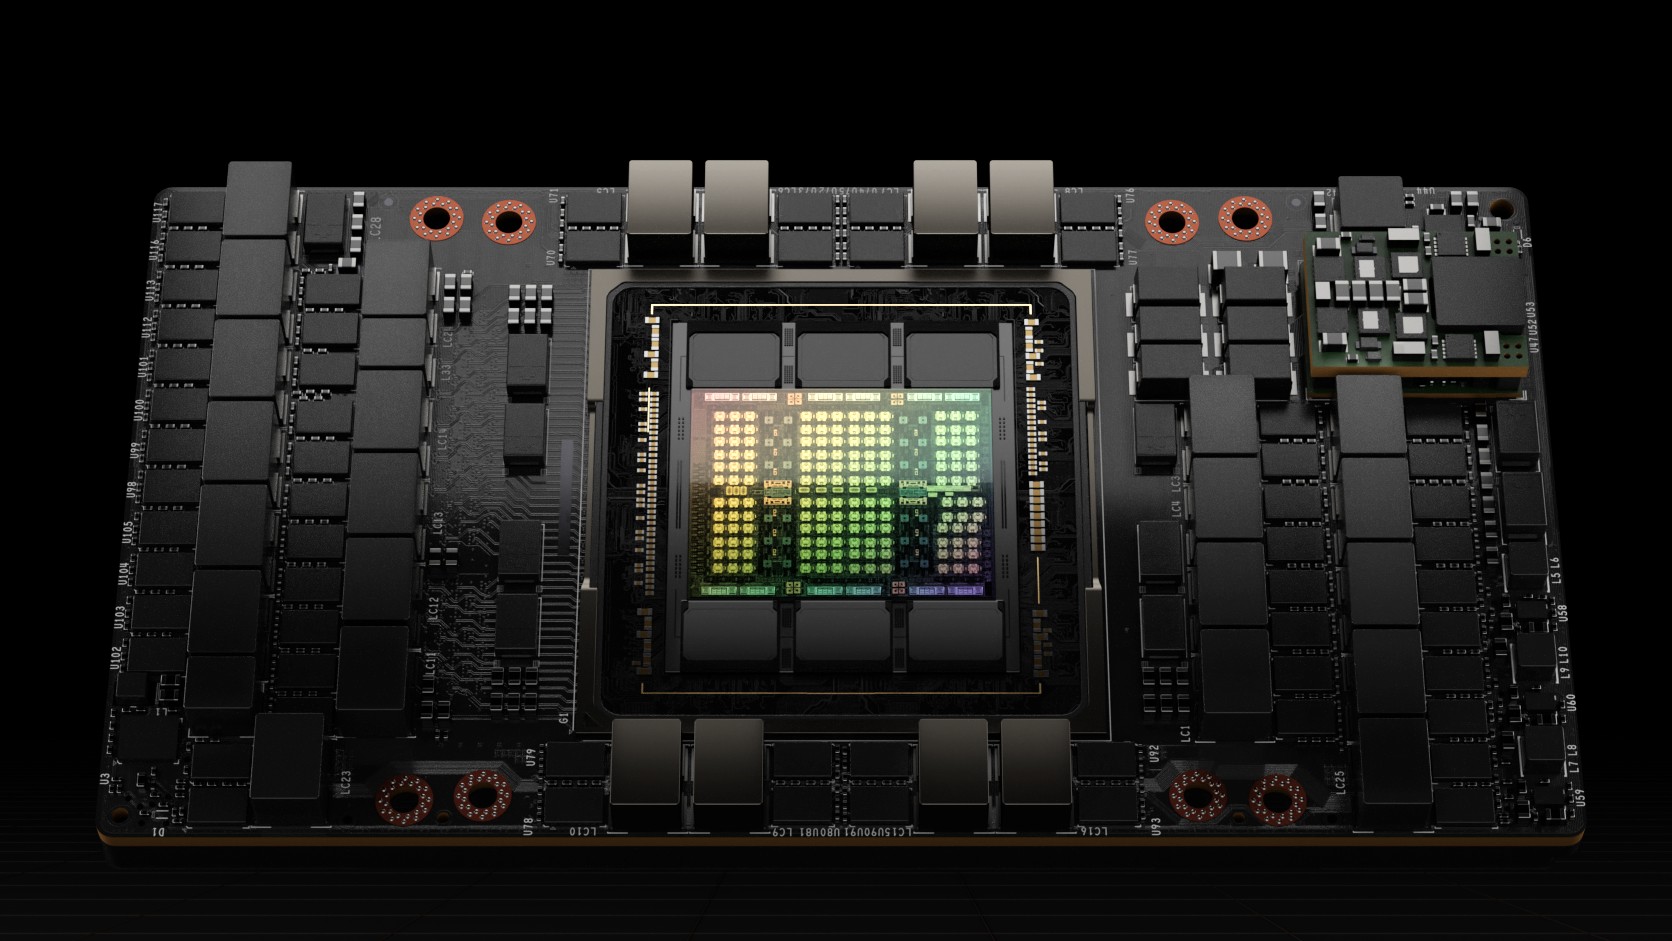
算力在芯片里。 H100 芯片上有 132 个 SM(流式多处理器,GPU 的基本计算模块),共 528 个 Tensor Core,这是专做矩阵乘法的电路。算力用每秒浮点运算次数(FLOPS)衡量,H100 SXM 用 BF16 精度时约每秒 990 万亿次(不计稀疏加速)。芯片能塞进多少计算单元,取决于制程,工艺越先进,晶体管越小:H100 用台积电 4N 工艺,814 平方毫米上有 800 亿个晶体管。
参数存在显存里。 H100 的显存是 HBM(高带宽内存):多层内存芯片叠成一摞,紧挨着 GPU 芯片封装,接口做得极宽。显存有两个指标:容量决定模型放不放得下,H100 SXM 是 80 GB;带宽决定每秒能搬多少数据,H100 SXM 是 3.35 TB/s,是双通道 DDR5 电脑内存的 30 多倍。
两个数一除,得到一个关键比例:
990 万亿次运算 ÷ 3.35 万亿字节 ≈ 每字节约 300 次运算
H100 每从显存取 1 个字节,有能力做约 300 次运算。可是 BF16 下每个参数占 2 个字节,处理一个 token 只对它做一乘一加两次运算,相当于取 1 个字节只算 1 次。参数搬进来一次,如果只处理 1 个 token,计算单元 300 份力气只用上 1 份;同时喂约 300 个 token,算力才不闲着。
数据早已送到、计算单元忙不过来,叫算力瓶颈;计算单元算完手头的、空转等数据,叫带宽瓶颈。读输入和写输出,正好各占一种。
读输入(Prefill):搬一遍参数,整段提示词一起算
模型写字的方式叫自回归:根据前面的全部内容预测下一个 token,写出来,接到末尾,再预测下一个,像接龙一样。一次请求因此分成两个阶段,先读后写。
不管读还是写,GPU 每往前走一步,都要把全部参数从显存搬到计算单元跟前过一遍。打个比方,这一步像发一趟班车:车上坐 1 个人还是坐满,油钱和司机的工钱都差不多,坐的人越多,每人摊的车费越少。车上的乘客,就是这一步要处理的 token。
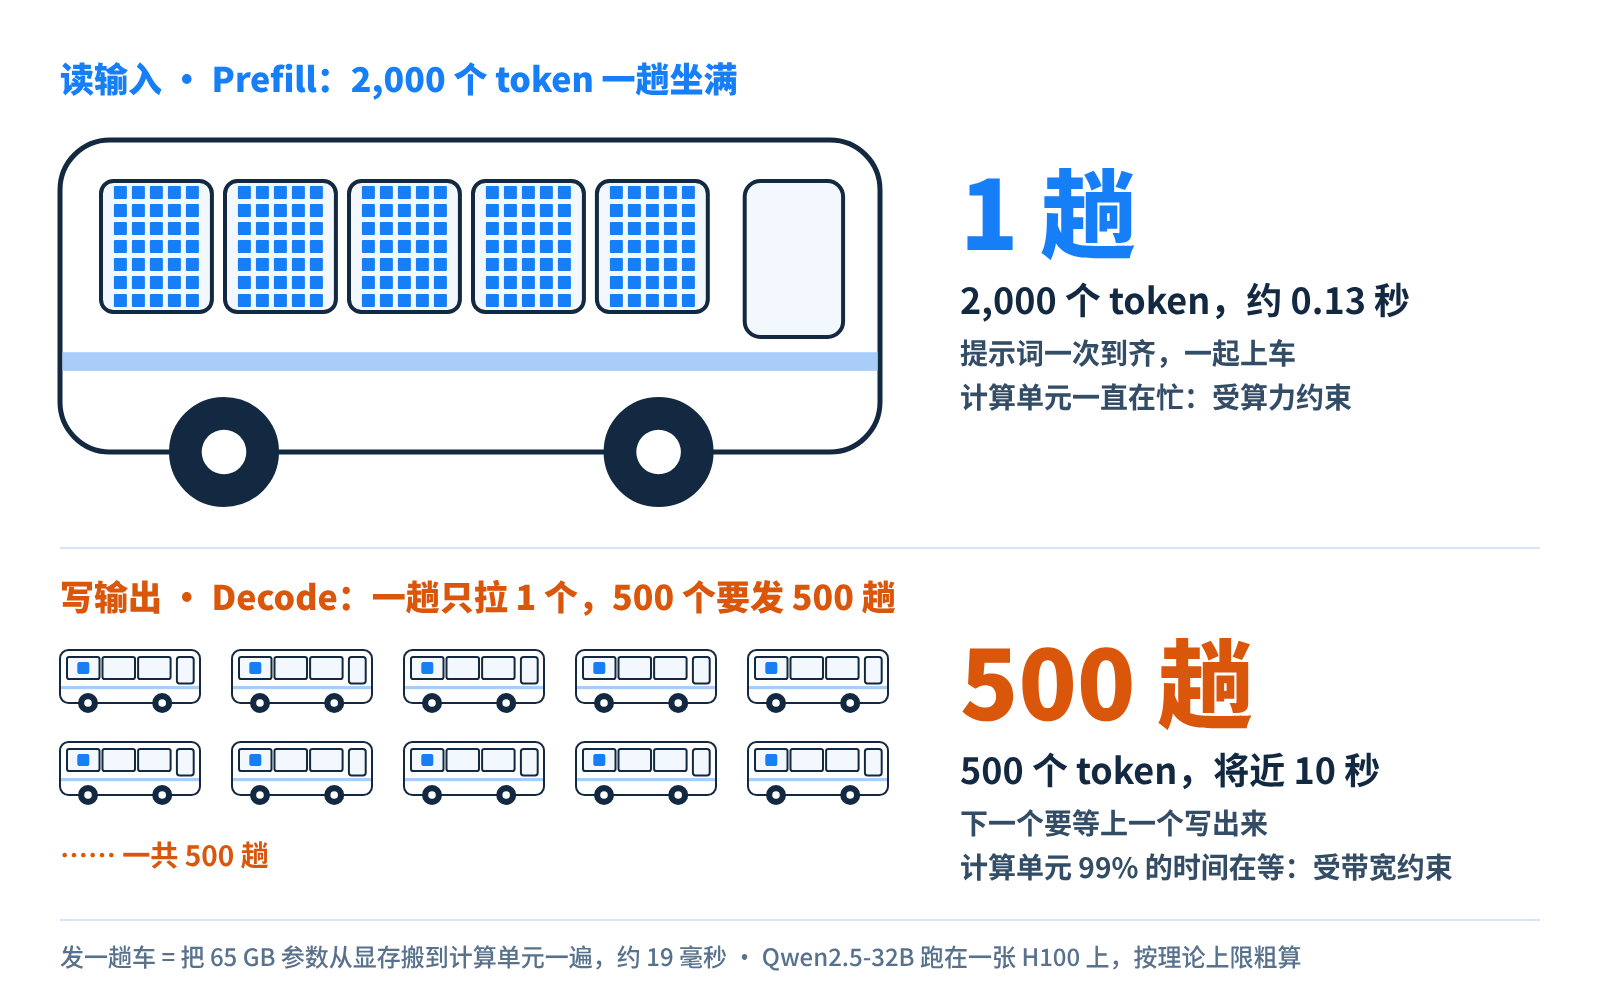
Prefill(预填充) 是读输入的阶段。提示词一开始就全部给定,2,000 个 token 能一起上车:它们的向量排成一个大矩阵,一次乘上同一份参数,每个 token 的 Key 和 Value 也顺带存进 KV 缓存。拿开头那份材料在 Qwen2.5-32B 上粗算(BF16 下参数约 65 GB,按 H100 的理论上限):
| 预填充 2,000 个 token | 耗时 |
|---|---|
| 从显存搬一遍参数 | 65 GB ÷ 3.35 TB/s ≈ 19 毫秒 |
| Tensor Core 计算 | 2,000 × 650 亿次 ÷ 990 万亿次/秒 ≈ 130 毫秒 |
搬运 19 毫秒,计算 130 毫秒,搬运藏在了计算后面,Tensor Core 基本是满的,整份材料约 0.13 秒读完。预填充受算力约束,2,000 个 token 坐同一趟车,每个摊到的成本很低。
写输出(Decode):每个 token 都要把参数重搬一遍
Decode(解码) 是写输出的阶段。接龙没法跳着写:第 101 个 token 要等第 100 个写出来才能算,一趟只能拉 1 位乘客。每一趟要做的事却一样不少:把全部参数搬一遍,再把这段对话的 KV 缓存读一遍,最后只算出一个 token。
| 同一张 H100 | 预填充 2,000 个 token | 解码 1 个 token |
|---|---|---|
| 搬一遍参数 | 约 19 毫秒 | 约 19 毫秒 |
| Tensor Core 计算 | 约 130 毫秒 | 约 0.07 毫秒 |
| 这一趟的产出 | 2,000 个 token | 1 个 token |
Tensor Core 用 0.07 毫秒就算完了,剩下的 19 毫秒都在等数据,99% 以上的时间在空转。开头那段 500 个 token 的总结要发 500 趟车,就算这张卡只服务你一个人,也要将近 10 秒,而读 2,000 个 token 的材料只用了约 0.13 秒。折算到每个 token,写一个占用的 GPU 时间是读一个的约 300 倍,正是上一节那个“每字节约 300 次运算”。解码受显存带宽约束,算力再强也帮不上忙。
如今的大模型多是混合专家(MoE)结构:前馈网络分成许多组“专家”,每个 token 只用其中几组。DeepSeek-V3 共 6,710 亿参数,每个 token 激活 370 亿。每趟要搬的少了,但一趟只拉一个 token 的规律没变。
批处理与 KV 缓存:能摊薄,但摊不平
服务商不会让一个用户独占一趟车。批处理就是拼车:把许多用户的请求拼成一批,每一步搬一次参数,同时给每个用户各算一个 token。批里 64 个用户,搬一趟就产出 64 个 token,每个摊到的搬运成本降到 1/64。
那为什么不拼够 300 个人,把算力喂饱?卡在行李上。每位乘客都拖着一只行李箱:自己这段对话的 KV 缓存。它要一直放在显存里,各是各的,没法共用,对话越长箱子越大。
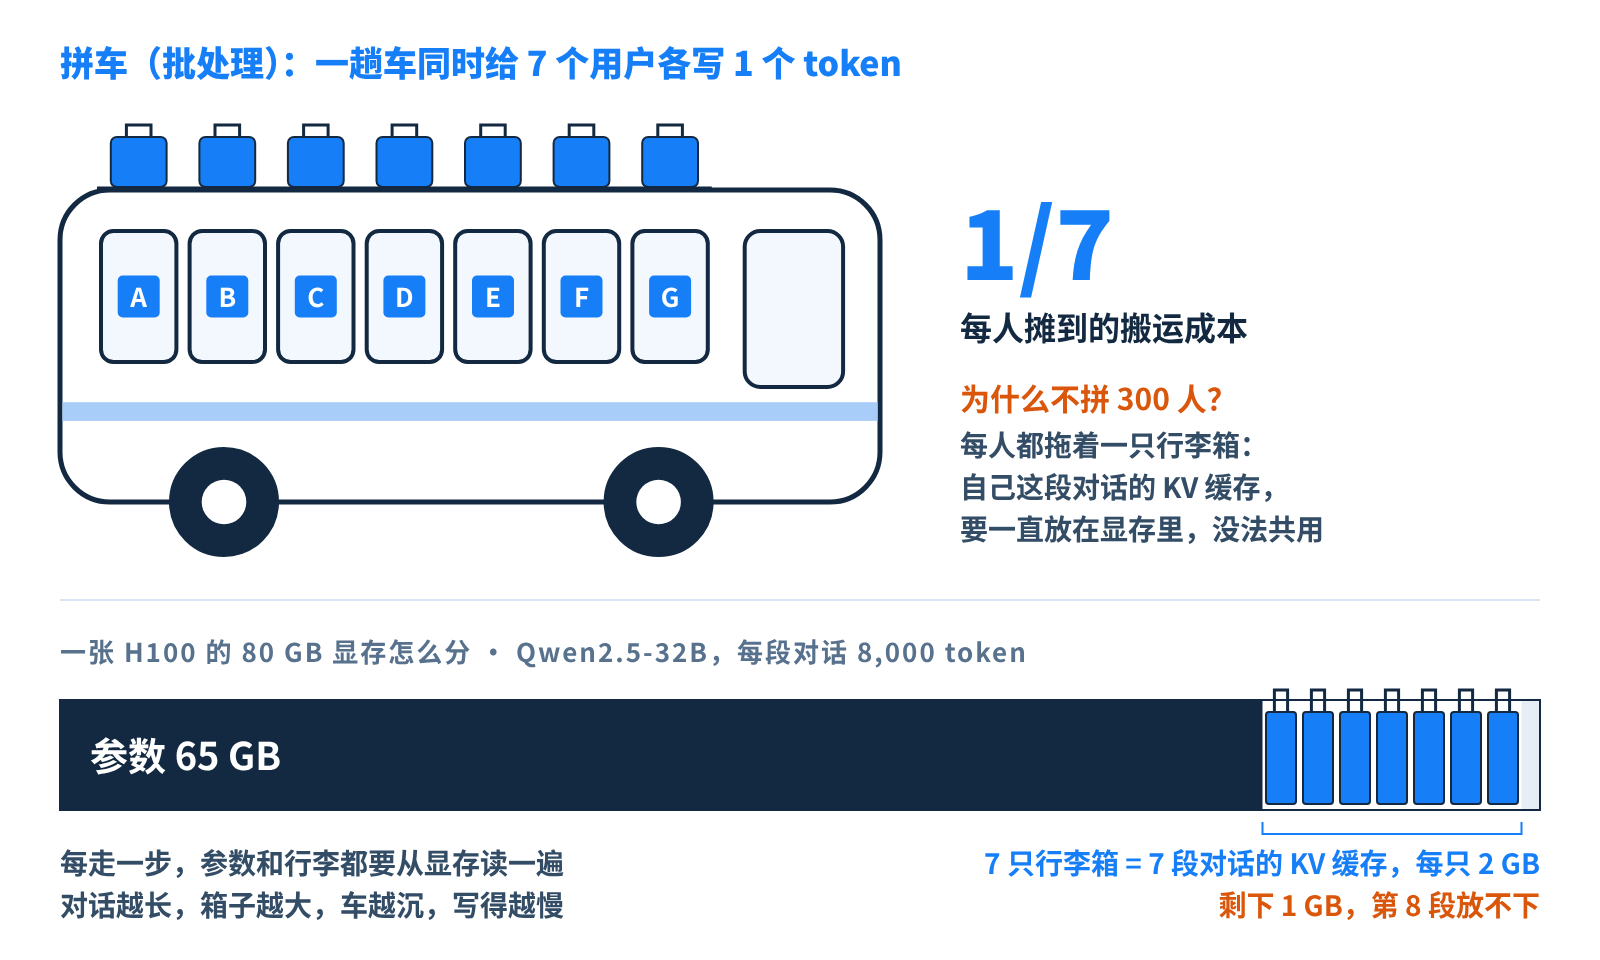
Qwen2.5-32B 每个 token 在 64 层里各存 8 组 Key、8 组 Value,每组 128 个数,合计约 0.25 MB,一段 8,000 token 的对话就是 2 GB。H100 的 80 GB 显存,参数先占掉 65 GB,剩下约 15 GB,只放得下 7 段这样的对话。每一步,这 14 GB 行李还要跟着从显存读一遍:对话越长,车越沉,写得越慢。
按理论上限粗算,拼上 7 个人以后,读的速度仍是写的 50 倍左右,比独坐时的 300 倍小了很多。真实服务还会继续缩小差距:拆到多张卡上,腾出显存放更多行李;用量化把每个参数从 2 字节压到 1 字节(FP8)甚至半字节(FP4),每趟少搬一些;从模型结构上把行李箱做小,DeepSeek-V2 提出的 MLA(多头潜在注意力)让 KV 缓存缩小了 93.3%。
优化到头,差距还剩多少?DeepSeek 在 2025 年 2 月公布过 V3 和 R1 线上 24 小时的统计:每台 8 卡 H800 服务器,预填充平均每秒处理约 7.37 万个输入 token(含缓存命中),解码每秒产出约 1.48 万个输出 token。用上大规模专家并行等优化之后,读的吞吐仍然是写的 5 倍。
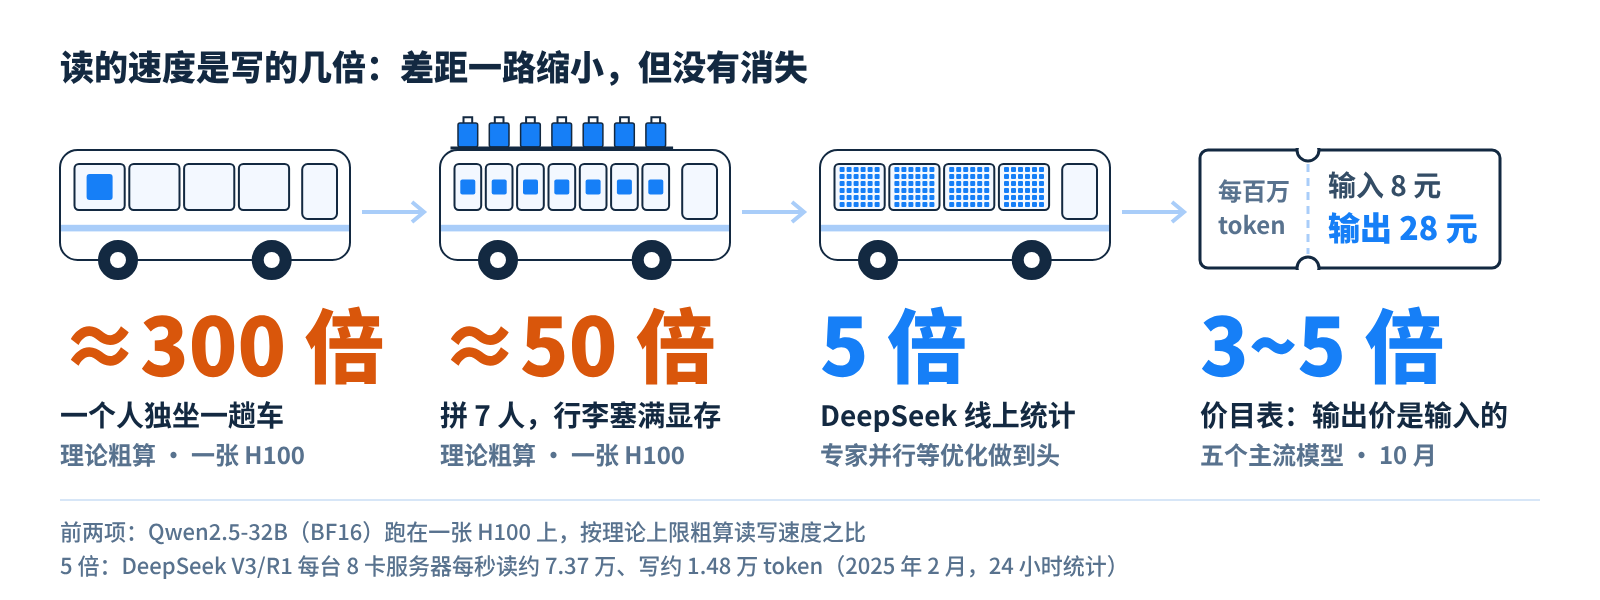
从独坐的 300 倍,到拼车的 50 倍,再到线上的 5 倍,差距一路缩小,但没有消失。输出单价是输入的好几倍,根源就在这里。
模型太大:NVLink、RDMA 与 PD 分离
再往上走,模型会大到一台机器都放不下。Kimi K3 有 2.8 万亿(2.8T)个参数,每个 token 激活 1,040 亿。权重按 4 位存(MXFP4,每个参数约半个字节),也要约 1.4 TB,而一台 8 卡 H100 服务器的显存加起来只有 640 GB。开源推理引擎 vLLM 给 K3 写的部署说明是:至少 8 张 GB300(英伟达新一代 GPU,每张显存约 280 GB),生产流量要多台机器一起扛。
模型拆开以后,每算一层,各张卡都要交换中间结果。数据走得越远,路越窄:
| 数据走的路 | 靠什么连 | 带宽 |
|---|---|---|
| 显存 → 同一张卡的 Tensor Core | HBM | 3.35 TB/s(H100) |
| 同一台机器里,卡与卡之间 | NVLink | 900 GB/s(H100) |
| 机器与机器之间 | RDMA 网络 | 每张卡约 50 GB/s(400 Gb/s 网卡) |
NVLink 是英伟达的 GPU 直连通道,连接同一台服务器里的卡;RDMA(远程直接内存访问)让网卡直接读写另一台机器的内存,不经过对方的 CPU,常见的实现是 InfiniBand 和 RoCE。
拆开部署的模型像一支车队,每过一个路口(每算一层),几辆车都要停下来互相递东西。预填充每一步都是大块计算,通信可以藏在计算后面;解码每一步本来就短,等待的时间直接加在每个 token 上。
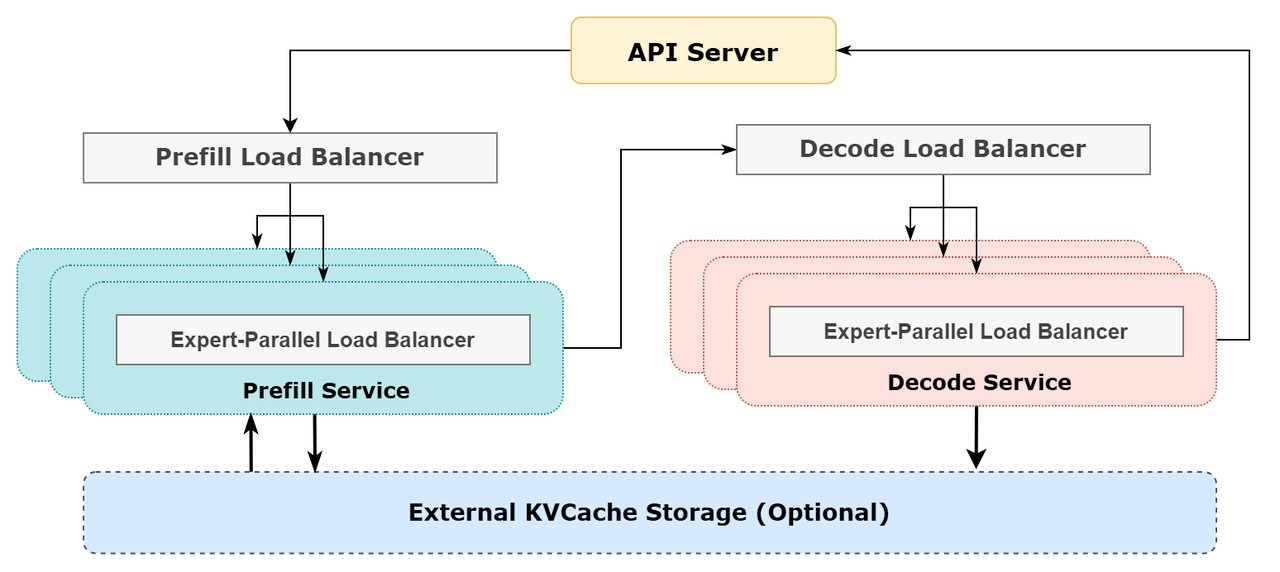
所以越来越多的服务商把两个阶段拆开部署,叫 PD 分离:预填充和解码用不同的机器组,各按各的瓶颈配置。DeepSeek 的预填充以 4 台服务器为一组,解码以 18 台为一组,每张卡只放少量专家,每张卡要读的参数少,批又能凑得很大。
回到开头:多出来的钱花在解码上
回到价目表,三档价格各对应前面讲过的一步。
缓存命中最便宜,因为跳过了预填充:开头相同的请求,服务商直接取用上次存下的 KV 缓存,连车都不用坐。DeepSeek 那份统计里,56.3% 的输入 token 命中了存在硬盘上的缓存。
输入居中,输出最贵:读输入一趟车坐满,受算力约束;写输出一趟只拉几个拼车的人,受显存带宽约束,还得一直给每段对话的 KV 缓存留着位置。深度思考的过程也是一个个 token 解码出来的,所以按输出计费。
回到开头那份材料:读两三千字收 1.6 分钱,写几百字的总结收 1.4 分钱。多出来的钱,买的是解码时一趟趟只拉几个人的班车:参数一遍遍从 HBM 搬过来,Tensor Core 大半在等,显存还得一直给这段对话的行李留着位置。
附录|名词速查
正文按出场顺序解释了下面这些名词,这里汇总成一张表,方便回查。
| 名词 | 一句话解释 |
|---|---|
| Token | 模型读写文字的基本单位,中文大致一到两个字一个 |
| MaaS | 模型即服务:厂商托管模型,开发者通过 API 按 token 付费调用 |
| 输入/输出/缓存命中 | 价目表的三档:发给模型的内容、模型写的内容、和之前请求开头相同而复用的部分 |
| Transformer | 今天大模型的主流结构:token 依次穿过几十层,每层先做注意力、再过前馈网络 |
| 参数(权重) | 训练出来的一大堆数字,是模型的本体 |
| 注意力(Query/Key/Value) | 当前 token 用 Query 和前文每个 token 的 Key 比对,越相关就从它的 Value 取得越多 |
| 前馈网络 | 每层里加工信息的部分,模型的大部分参数在这里 |
| KV 缓存 | 每个 token 在每一层留下的 Key、Value 向量,相当于模型对前文的笔记 |
| SM | 流式多处理器,GPU 的基本计算模块,H100 有 132 个 |
| Tensor Core | SM 里专做矩阵乘法的电路,H100 共 528 个 |
| 算力(FLOPS) | 每秒能做多少次浮点运算,H100 在 BF16 下约 990 万亿次 |
| 制程 | 芯片的制造工艺代际,越先进晶体管越小,同样面积放得下越多计算单元 |
| 显存 | GPU 自带的内存,参数和 KV 缓存都放在这里 |
| HBM | 高带宽内存,多层内存芯片叠起来,和 GPU 芯片封装在一起 |
| 带宽 | 每秒能搬多少数据,H100 的显存带宽是 3.35 TB/s |
| BF16/FP8/FP4 | 数字的存储精度,每个参数分别占 2、1、约 0.5 个字节 |
| 量化 | 把参数压成更低的精度,要存、要搬的数据随之变少 |
| 算力瓶颈/带宽瓶颈 | 前者是计算单元忙不过来,后者是计算单元空转、等数据送来 |
| 自回归 | 根据前文预测下一个 token,一个接一个往下写 |
| Prefill(预填充) | 读输入的阶段,整段提示词并行计算,受算力约束 |
| Decode(解码) | 写输出的阶段,一步一个 token,受显存带宽约束 |
| 批处理 | 把多个用户的请求拼成一批,共用一次参数搬运,像拼车 |
| MoE(混合专家) | 前馈网络分成许多组专家,每个 token 只用其中几组 |
| MLA | DeepSeek 提出的注意力结构,用来压缩 KV 缓存 |
| NVLink | 英伟达 GPU 之间的直连通道,用在同一台服务器内 |
| RDMA | 网卡直接读写另一台机器的内存,用在机器之间 |
| InfiniBand/RoCE | 两种常见的 RDMA 网络 |
| PD 分离 | 预填充和解码分到不同的机器组上部署 |