摘要 曾在 OpenAI 做机制可解释性、现在在 Goodfire 的 Nick Cammarata,10 月 15 日发表长文《Neural Networks Are Already Clean》。他认为,让这个领域相信“神经网络会把无关概念乱塞进同一个神经元”(叠加假说)的经典证据都被看错了:著名的猫车神经元其实认 V 形,InceptionV1 末层难读主要是架构和工具问题。借助智能体大规模检查,他们初步估计 Qwen3-32B 约九成神经元极只有一项主要工作。所以他主张直接研究网络自己的神经元,不必先训练稀疏自编码器去“解结”。这是他自称约 85% 把握的工作假说,注意力机制和大模型的完整审计还没做完。
InceptionV1 的 4e:55 号神经元,大概是神经网络可解释性领域最出名的反例。它看到猫脸会亮,看到汽车车头也会亮。从 2017 年的 Feature Visualization 到 2020 年的 Zoom In,几篇这个领域读者最多的论文都拿它说明一件让人沮丧的事:一个神经元可能同时管着几件毫不相干的事,单看神经元读不懂模型。
10 月 15 日,当年和 Chris Olah 一起写这些论文的 Nick Cammarata 发了一篇长文,说这个神经元被看错了。他重新打开那组看过几百遍的图片,问自己“这些图共有的一样东西是什么”,几秒钟就看出来了:猫脸和车头都是 V 形。
这篇长文英文约两万词,网页版配了几十张可交互的图。下面按“旧证据怎么倒的、新数字怎么来的、还有哪些没解决”的顺序讲清它。
叠加假说:为什么大家先去训练第二个模型
机制可解释性(mechanistic interpretability)想做的事,是像读程序一样读神经网络:看清每个神经元在算什么、神经元之间怎样连成回路,最后说清模型为什么给出某个答案。它最大的麻烦叫多义性(polysemanticity):一个神经元对几类看似无关的东西都有反应,猫车神经元就是代表。
对多义性,这个领域长期接受的解释是叠加(superposition)。按这个假说,神经元不够用时,网络会换一种学习方式:不再把相关的东西放在一起,而是把互不相关、很少同时出现的概念折叠进同一个神经元,反正它们不会互相干扰。这样得到的就像一团死结。网络本可以有很多种差不多好的折法,所以一个神经元里放了哪几样东西,几乎说明不了什么。
如果网络真是死结,就只能先解结再研究。实际做法是另外训练一个模型,最常见的是稀疏自编码器(SAE):把某一层的激活重新拆成数量多得多、每次只亮少数几个的“特征”方向,再去研究这些特征,而不是原来的神经元。过去几年,Anthropic、OpenAI 和不少团队的可解释性工作都走这条路。
Cammarata 说,两种解释他都参与提出过。2019 年,他在 InceptionV1 里找到一条“汽车特征散进一组不相干的狗神经元”的回路,和 Chris Olah 讨论后,两人认为网络在把汽车折叠进高维空间藏起来,给它起名叫叠加。这条回路后来成了 Zoom In 里介绍叠加现象的例子,“也是我们给出的唯一一个,我见过的唯一一个”。另一种解释是他在 2021 年 Multimodal Neurons 论文里提过、后来被忘掉的一小节,也就是下文的递归泛化。现在他认为,后一种基本是对的。
两种解释的预测几乎相反,所以能检验。泛化把相似的东西放在一起,应当是局部的:一个“垂耳狗”神经元里,装的是各种角度、各种品种的垂耳。叠加把无关的东西放在一起,应当是跨领域的:它更可能造出一个“垂耳狗+拉丁诗歌”神经元。在训练过程中看着一个神经元长出来,就能分辨是哪一种。
还要分清一个词。“叠加”在文献里有几种用法。Anthropic 2022 年的 Toy Models of Superposition 把它定义为“特征数多于维度数”,这一点连完全单义的网络也满足,因为神经元可以组合出远多于自身数量的概念。Cammarata 反对的是另一层意思:网络把无关的东西塞进同一个神经元,因为它们很少相撞。他认为可解释性的好消息坏消息,主要取决于这一种是否存在。
猫车神经元 4e:55:猫脸和车头共享一个 V 形
4e:55 是 InceptionV1(2014 年的 GoogLeNet)中间层的一个神经元。Zoom In 当年明确写过,它“不是在响应猫和汽车的某种共同点”。2021 年的 Multimodal Neurons 离答案只差一步:作者们问过“会不会是猫眼和车灯长得像”,最后因为特征可视化图里同时出现了胡须和镀铬,判定它“确实是猫或汽车”。特征可视化(feature visualization)是用梯度优化合成一张让某个神经元最兴奋的图,那些迷幻风格的图片就是这么来的。
Cammarata 这次换了一个问法:如果这组图只有一个共同点,会是什么?答案几乎立刻出现,是 V 形。随后的检查都指向同一处:
- 输入端最强的是狐狸口鼻、狼脸、面包车车头;
- 下游读取它的有火焰、郊狼脸和马提尼酒杯,回路里还连着消防船喷出的 V 形水柱;
- 它的负极,也就是让它最强烈地变成负值的东西,是 O 形:圆脸的狗、蜗牛、高尔夫球、网球、钟面。
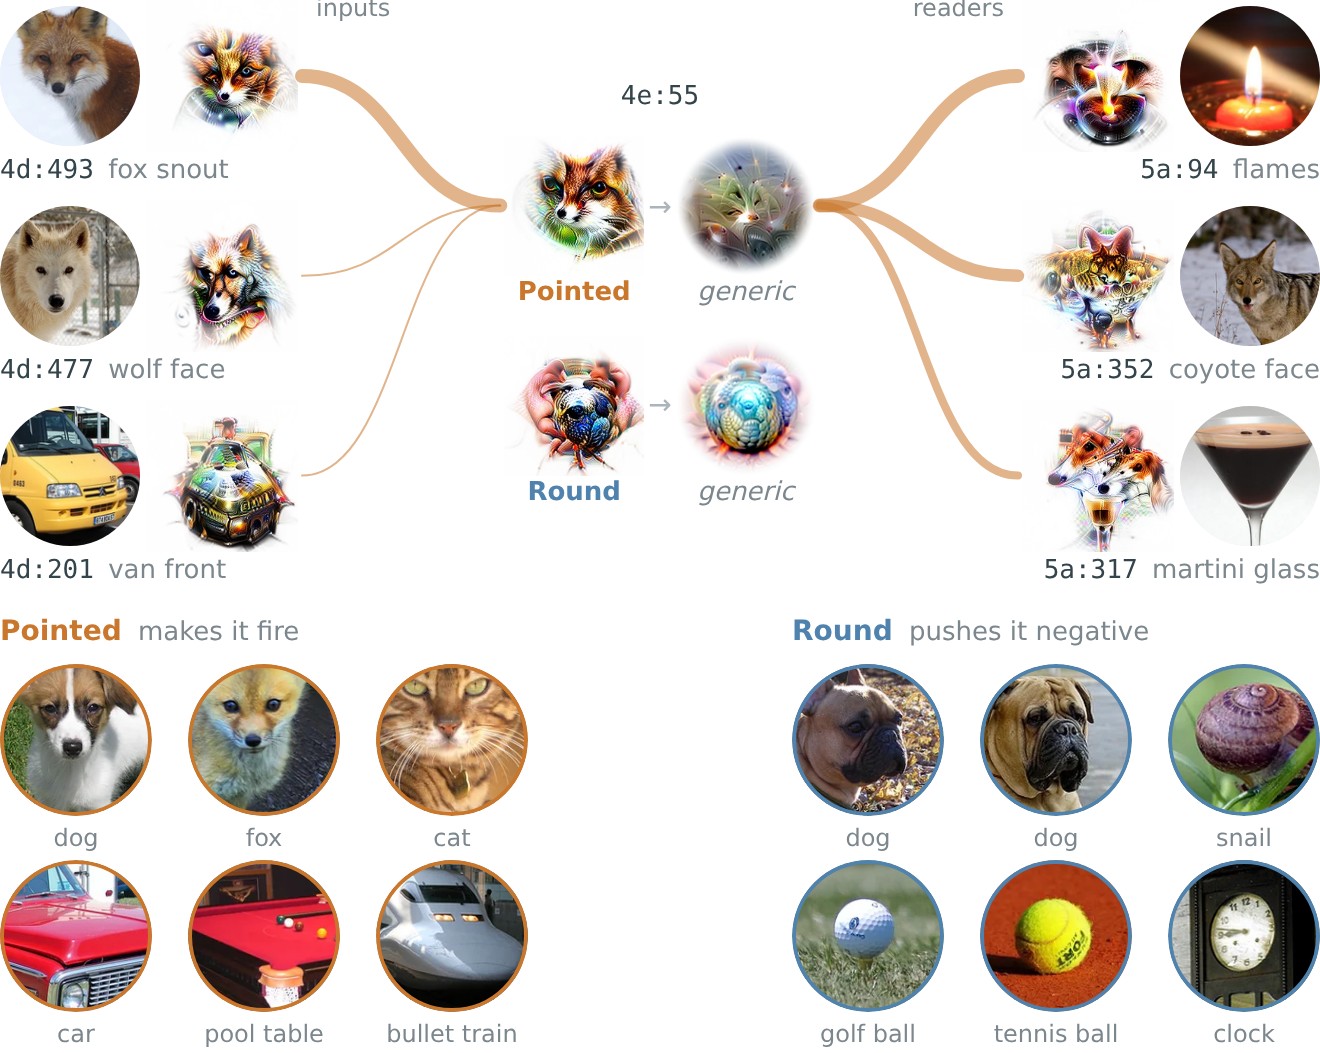
如果它真是猫和汽车的随机拼盘,没有理由和火焰连得这么紧。胡须的出现也有解释:特征可视化的目标是把激活推到最高,一旦找到“走猫的通路”能让激活升高,就会把这条通路带来的所有东西一起加进图里,胡须是搭车进来的。要看出共同模式,得去看这个神经元的各个输入有什么共同点,而不是只看它自己的可视化图。
Cammarata 2019 年找到的那条“汽车藏进狗神经元”的回路,也被重新解释了。汽车和狗被放在一起,是因为它们在照片里朝向镜头的姿态相同。InceptionV1 里有一百多个这样的“泛化姿态神经元”,每个都干净地检测一种跨越汽车、狗和其他物体的姿态,此前没人注意到。至于可视化里为什么全是狗:ImageNet 训练数据里狗的照片多、狗神经元也多,梯度优化一开始就掉进狗的通路出不来。只要稍微把优化往这些神经元最常见的真实图片方向引导,出来的多半是汽车,有些是姿态相同的狗和车。
有人会说,狗和车挤在一起只是因为空间不够,大模型会把它们分开。Cammarata 看了 DINOv2,参数是 InceptionV1 的十倍以上,架构也晚了约十年,姿态神经元更多了,但很多仍然同时覆盖狗和车。他说在看过的每个视觉模型里都见到了这种神经元。
这一节最值得带走的是看神经元的角度。人和自动解释工具都倾向于用一串名词描述神经元,比如“猫和汽车”。Cammarata 认为神经元更像动词:它的工作不是给输入贴标签,而是做一次区分,正极一种模式、负极另一种模式(V 对 O),再把激活送往不同的下游神经元。他给的办法很简单:假设不许用任何名词,你会怎样向别人描述这个神经元?共同模式往往一下就跳出来。他怀疑,中间层神经元被误判为多义,最大的原因就是把一个模式写成了一串名词。
负极因此和正极几乎一样重要,即使在会把负值截掉的 ReLU 网络里也是如此。神经元的输入权重像投票,各自投给正极或负极,票数在非线性之前相加;神经元打开时,每一票都会收到梯度,所以负极同样是学出来的。在一条识别跑车的路径上,前面的神经元把汽车和狗分开,并不是说汽车和狗是反义词,而是把早先因为姿态相同放在一起的东西,在这里分流到各自的区域。
InceptionV1 末层:从约 5% 到约 99%,变的是架构和工具
猫车神经元在中间层。让很多人相信神经网络“几乎天生读不懂”的另一项主要证据,是 InceptionV1 的最后一层:那里的神经元看上去全是无关东西的混合。有人估计这一层“基本没有可解释的神经元”,Cammarata 自己的印象是大约 5%。当时的标准解释是,越往后需要表示的高层特征越多,神经元不够,只好乱塞;早期层特征少,所以干净。
Cammarata 把这件事拆成了显微镜和样本两头。
显微镜的问题。 特征可视化早期效果很差,后来加上“变换鲁棒性”(生成图片时随机平移、缩放,逼它画出稳定的图案),同样的神经元一下子清楚了。到了网络深处它又开始失灵,原因是前面说的优化跑偏,加上正则化设置不太对。调整几个设置之后,能看清的层又往深处推进了一截。用改进后的工具,同一个 2014 年的 InceptionV1,末层可读比例从约 5% 升到约 50%。
样本的问题。 网络本身也学得不好。按同样的架构用更合理的现代正则化重新训练,末层约 70% 可读。换成参数量相同(706 万)、训练数据相同,但带残差连接和 LayerNorm 的 ConvNeXt,末层约 99% 可读。残差连接最初是为了让深层网络更好训练而发明的,跟可解释性无关,却顺带让深层在概念上变干净了。
| InceptionV1 末层,同一个问题的四种条件 | 可读的神经元 |
|---|---|
| 当年的工具,原版模型 | 约 5%(也有人估计接近 0) |
| 改进后的工具,原版模型 | 约 50% |
| 同架构,用现代正则化重训 | 约 70% |
| 同参数量、同数据的 ConvNeXt | 约 99% |
把一层压到 10 个神经元,看它会不会乱塞
叠加假说说的是“神经元不够就乱塞”,那就直接让它不够。InceptionV1 的 3b 层有曲线检测器和高低频检测器,是 Cammarata 最熟的一层。这个模型没有残差流,信息没法绕过这一层。他把 3b 从 480 个神经元砍到 10 个,压缩 48 倍,从头重训。
按叠加的预测,应该看到曲线、橙色螺旋、蜘蛛网和几种纹理叠在同一个神经元里。实际看到的是神经元变粗了,但仍然可读:一个“曲线和环”神经元代替了原来的十个曲线检测器,两个圆形神经元代替了好几种圆。
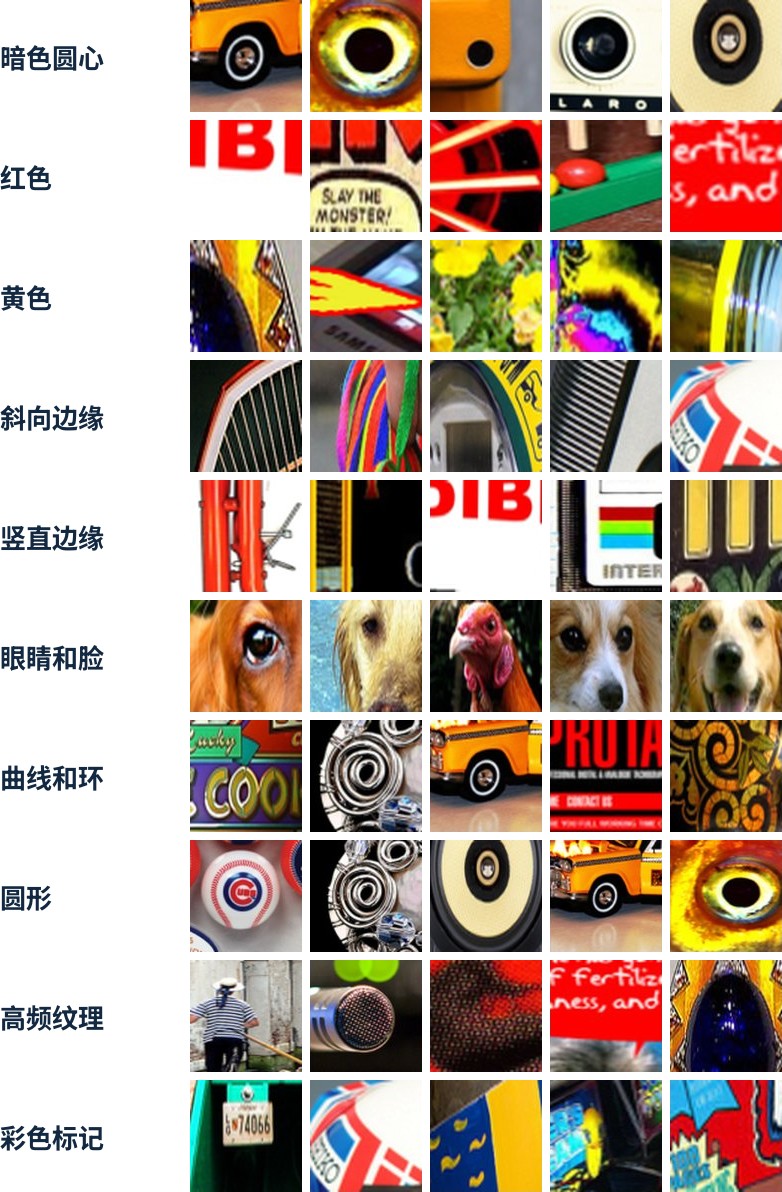
如果原来的十个曲线检测器被藏进了这 10 个神经元的某种组合里,用稀疏自编码器应该能把它们拆回来。在这一层上训练 SAE,找到的是宽泛、挤在一起的特征,没有干净的曲线。中型 ConvNeXt 的最后一层从 1024 个神经元砍到 13 个,结果相同:神经元变宽,没有拼盘。参数只有 9.2 万的小型 ConvNeXt,最后一层有个神经元正极是汽车、火车和手推车,负极是船和飞机,同样是在做区分,只是更粗,也更早停下。
结论是,空间不够时网络不会换一种学习原理,只是把概念划得更粗。这和后文语言模型里“小模型神经元更宽”的观察是一回事。
SAE 找到了什么
如果神经元的组合里藏着东西,词典类方法(如 SAE)应该能找到神经元没有的构件。Cammarata 在这些层上训练了几个 SAE,自己和智能体一起找,没有找到。在 ConvNeXt 的最后一层,SAE 88% 的活动几乎是单个神经元的复制品;把所有对不上任何神经元的方向删掉,准确率不变,被改变的少数答案原本就是两个类别分数接近的情况。两者的差别主要是组织方式:SAE 的单元是“不同场景里的蜘蛛”,神经元是“蜘蛛腿的图案”和“蛛网”。
他也承认 SAE 有用处,尤其在神经元很粗的小模型里,回答“这张图里有什么”时更方便;但在大模型上他更喜欢直接看神经元。
稀有的东西也查了。他教 706 万参数的模型一件荒唐事:某张雨伞照片是蜜蜂。如果记忆靠的是隐藏特征,网络会单独长出一个只认这组像素、与其他部分无关的东西。实际上九个训练步里,最高猜测从雨伞变成五月柱再变成蜜蜂,雨伞神经元减弱,已有的蜜蜂神经元亮了起来,改动几乎都在最后三个块里。把这三个块换进原模型,它就会说“蜜蜂”。网络是在两条现成的通路之间修了一条匝道。
递归泛化:看着乱的神经元,多半是长出了分枝
架构修好之前,InceptionV1 的末层其实也没有乱塞。Cammarata 重训了原架构,在训练过程中看一个神经元怎样形成:它一开始响应油菜花田,而这些照片里有时带着狗;接着它沿着照片的每个侧面往外长,长向其他自然风景、长向绿色的球,又长向没有花的狗。在同样数据上训练的 ConvNeXt 里,对应的神经元早期也伸向过球和水果,后来放掉了,留在花田上;InceptionV1 的那个则一路扩散到狗和西兰花,最后花田几乎看不见了。他说看过的每个神经元都是这样,改进后的架构也有,只是少得多。
他把这叫递归泛化(recursive generalization):神经元沿着不止一个方向泛化,往往先沿一个方向,再长出分枝,分枝再长分枝。每一步在局部都说得通,加在一起就不再“单义”。
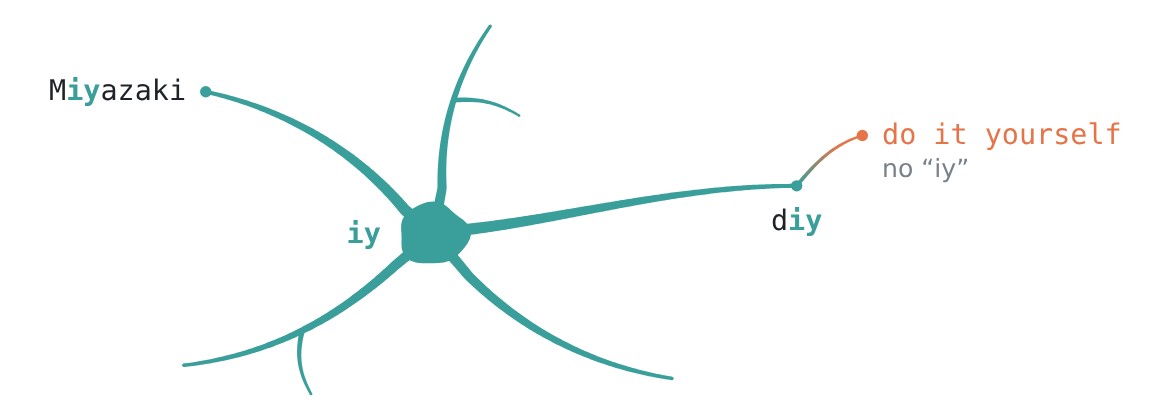
语言模型里的例子更直观。一个神经元响应字母组合“iy”,包括“Miyazaki”里的那一段;后来它也响应“diy”,再后来响应“do it yourself”,而这串词里已经没有“iy”。一个行星地质神经元,最强的激活里混着月壳和 Cesium 地图库的代码,按输入它的回路分组,其中三组是同一个核心“行星表面”的不同侧面,代码那一组是从另一条通路单独接进来的分枝。
这个想法最早出现在 2021 年 Multimodal Neurons 里叫“conjoined features”的一小节,Cammarata 自己都忘了,研究了几个月递归泛化之后翻旧论文才想起来。当时没有训练中间的检查点,看不到神经元怎样长出来,也没人把它当成 InceptionV1 末层问题的总解释。
看不懂的神经元,先怀疑五件事
Cammarata 原本是叠加的坚定信徒。他开始研究语言模型神经元,本意是测试智能体有没有“研究品味”,神经元只是基线,他预计很快就会撞上叠加造成的碎片,然后让智能体转去研究 SAE 一类更干净的基底。这一步始终没来,因为每个神经元最后都落到一个简单解释上,而且这个解释做出的意外预测都成立了:
- 一个前沿模型里的神经元,主要在“pr”上激活,但也对一堆 Base64 编码的网址和一些孟加拉语有反应。把网址解码、把孟加拉语转写出来,都是“pr”。
- 在一个稠密 Qwen 模型里,常规自动解释工具把某个神经元标成“多义的逗号神经元”。仔细看,它追踪的是科罗拉多州:当地电话区号、俚语,还和其他科罗拉多神经元相连;把它调高,模型想去徒步。逗号只是模型汇总前文语境的位置。注意力机制常把信息收集到标点上,他们把这叫“摘要模式”,知道之后很多类似的神经元都好懂了。
- 一开始样本只截两段文字,结果所有依赖长上下文的神经元都显得多义。一个神经元看上去在响应咖啡和大学,往上翻三段才发现故事发生在河内。
- 另一个神经元看上去乱七八糟、没有特别强的激活,后来数据集够广了才发现,它专找健康类 SEO 垃圾页面里的特定信号。
他把“看不懂”的可能原因列成五条:工具不好;基于坏工具写出的解释不好;网络因为架构或数据学得不好;递归泛化,神经元往几个相关方向长出了分枝;叠加,网络换了学习原理,把无关的东西塞进同一个神经元。
他的反思是,过去把叠加当成了默认假设,其实它应该排在最后,因为它最激进、也最难证伪:它唯一的症状就是“看不懂”,而坏工具、没追踪到的递归泛化、坏架构、还没理解的泛化,看起来也都是“看不懂”。Anthropic 2022 年的 Softmax Linear Units 论文写过一句:“在机制可解释性社区,叠加常被当作默认假设,只是因为它直觉上比其他解释更有吸引力,但证据很少。”Cammarata 说,据他所知,自他 2019 年那条(已被证明看错的)回路之后,没有人在真实网络里再发表过形状对得上的叠加回路。
反过来的风险是“空白处的解释”:硬给每个神经元编一个说得通的故事。他的回应有两点。其他四个原因都能检验:换更好的工具,神经元要么变清楚要么没有;换更好的架构重训,就知道是不是学习的问题;递归泛化可以在训练过程中一小步一小步地看着它长。真正的解释通常很窄、很容易被检验:怀疑是科罗拉多神经元,就把它调高,看模型说什么。实在看不懂,也可以如实说看不懂。
语言模型:Qwen3-32B 约九成神经元极只有一项主要工作
图像模型看得清,所以前面的论证大多在图像模型上做。语言模型大得多,没有特征可视化这样顺手的工具,注意力又把各种机制混在一起,更难精确验证。这一部分是 Cammarata 和 Goodfire 的同事 Curt Tigges 一起做的,更细的实验要等即将发布的配套技术论文。
旧数字和新数字
2023 年有两个常被引用的数字。Anthropic 的 Towards Monosemanticity 研究一个只有一层的小模型,按满分 14 分的评分表,神经元的中位数是 0 分,意思是评分者连一个假设都提不出来。同一年,Cammarata 在 OpenAI 发起的自动可解释性项目,让 GPT-4 给 GPT-2 XL 的神经元写解释,按最宽松的标准,只有约 1.7% 算可解释。
这次的初步审查给出的是另一幅图。在 Qwen3-32B 上,他们估计:
- 约 90% 的神经元极只有一项主要工作,常带着一些相关的小分枝;
- 约 7% 有两项相关的工作;
- 只有约 2%–4% 还没看懂。
“极”指神经元的正负两侧。现代大模型的神经元用 SwiGLU 这类门控激活函数,正值和负值都有意义,所以两侧分别计数。稠密模型和混合专家(MoE)模型结果相近,在 Kimi K3 这样数万亿参数的模型上也得到了类似结果,细节留给配套论文。
这些百分比对阈值很敏感:弱激活看到多深、怎样算“一件事”(比如两种语言里意思相近的俗语算不算同一件),都会改变数字。Cammarata 自己说,他并不觉得单一分数有多重要,删掉它之后早期审稿人觉得没有抓手,才留了一个粗略的数。只看强激活、样本较小的那几组,非随意混合的比例接近 97%。他更在意的是:东西为什么会共享同一个神经元。
他们也回头重查了 2023 年的 GPT-2 XL。用新工具几乎不做迭代,写了 500 份“神经元论文”(针对单个神经元的详细调查),约 70% 看起来大体是一件事,其中真正纯净的只有约 5%;剩下的做着几件宽泛的事,最多约六件,多数是两件。他的总结是:小模型的神经元更宽,递归泛化留下的残余也更多。
Towards Monosemanticity 开头举过一个神经元,说它响应“学术引用、英语对话、HTTP 请求和韩文的混合”。Cammarata 猜它是一个“别输出句号”的神经元,这种模式在语言模型里到处都是:引用、对话和 HTTP 请求的激活几乎都落在句号上或句号附近,它最强的十个负向输出连接里有八个以句号开头;韩文样本都落在一个音节写到约三分之二的位置,那里也不该出句号。没有原模型,他没法继续缩小解释,但这已经从“四件无关的事”变成了一两个相关的句法推力。
负极也在干活
他们认为可解释性界面太偏重正极和它的弱激活,其实强正极和强负极都很重要,弱激活通常不重要。
一个例子:在一张关于圣诞老人的归因图里,常规自动解释工具给某些神经元的标签像是“首都城市”,因为它们只看正极,忽略了对应圣诞传说的负极。去掉 8 个负极是圣诞老人的神经元,模型答“圣诞老人”的概率从接近确定降到 6%,Qwen 转而怪罪宠物;去掉 20 个标签写着圣诞或圣诞老人的神经元,概率只降到 76%。
归因图(attribution graph)是把模型从输入到某个输出的计算画成节点和连线,节点是神经元或特征,连线表示谁对谁贡献多大。Anthropic 2025 年在 Claude 3.5 Haiku 上用跨层转码器(CLT)的特征画过一张医学诊断的归因图,问的是子痫前期。Goodfire 团队直接用 Qwen3-32B 的原始神经元画出了同样的回路。用原始神经元不需要额外训练,也没有重建误差;Anthropic 最大的转码器只有一半时候能预测出和原模型相同的下一个词,图里需要“误差节点”补上它漏掉的部分。这张图里,诊断的中枢只有 4 个神经元,去掉它们,模型改问有没有瘙痒,那是另一种妊娠期肝病的典型症状,像是换到了下一个猜测。
他们还用纯神经元给 Kimi K3 画了一张归因图,说据他们所知,这是第一张公开的数万亿参数模型归因图。问题是捡到一个装着 500 美元和失主证件的钱包、没人看见,该怎么办:模型把钱包、现金和失主证件连到失物和诚实,最后答“归还”。
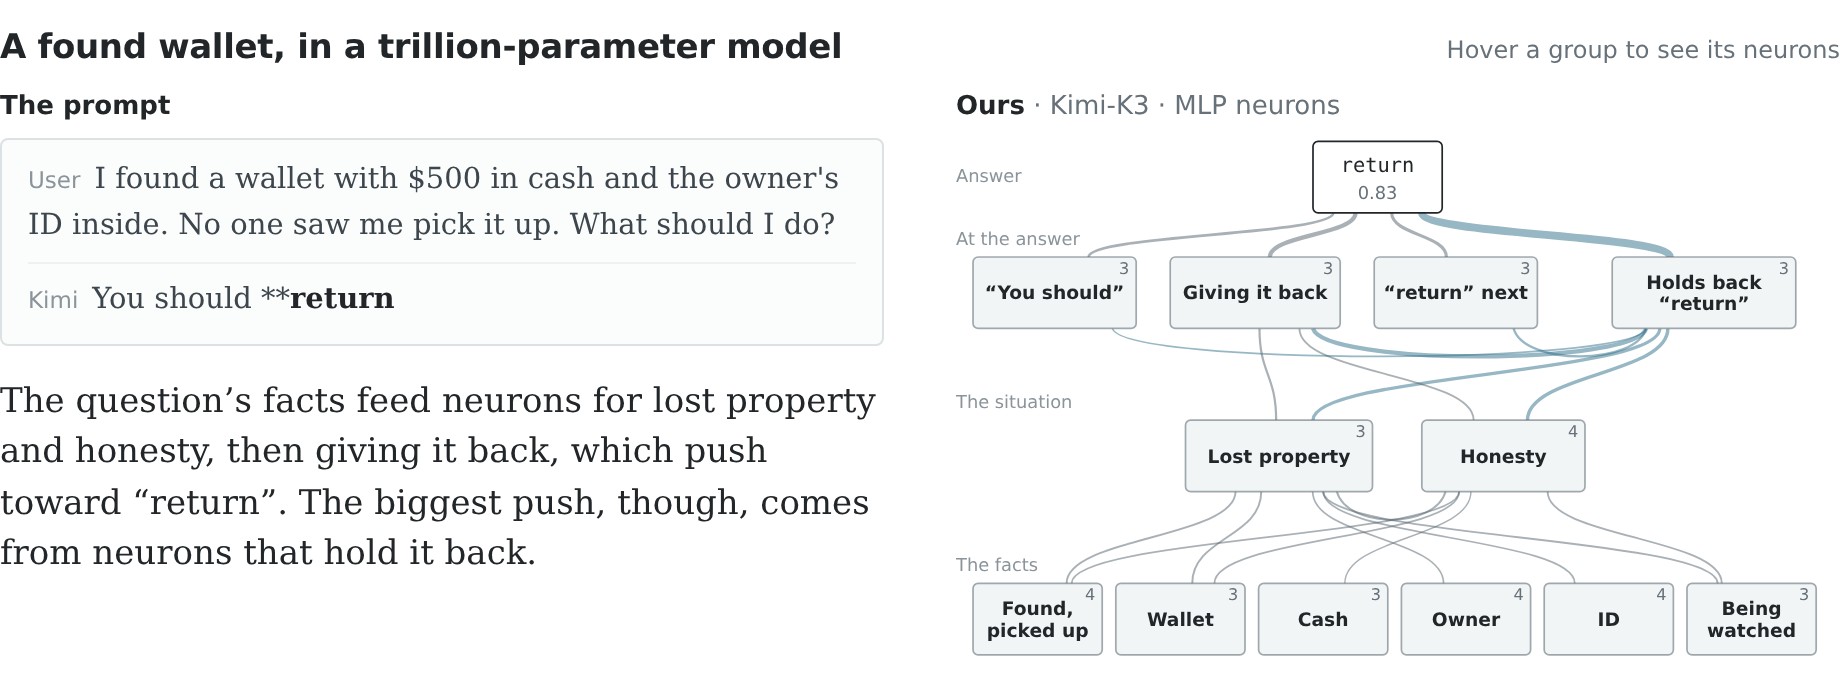 他们说这个规模的完整审计还没开始,到目前为止看到的大多凭直觉就能读懂。
两个顺带的发现
SwiGLU 的“双负”回声。 现代神经元有门(gate)和值(value)两路,两路都为负时,乘积会落到正极,看起来却像负极的内容。这种回声通常很小,但对约 4% 的神经元,它占满了整个最强激活列表,让人误以为神经元多义。在全网络范围消融这些激活,多数基准分数反而上升,但有些推理类基准下降。他们没深究,猜测原因很平常,并建议架构设计者修一修。在视觉模型里,值这一路学的东西更宽,比如“小型灰鸟”或“任何橙色的东西”,门只为灯草鹀或金鱼打开。
专家比报告的更专。 MoE 的专家也随深度变窄。Cammarata 把专家看成一种“反叠加”的架构:叠加想把无关的东西塞在一起,可神经元只在所属专家被选中时才激活。一个想装一万样无关东西的专家,需要路由器能认出这一万样东西才知道何时把词元送过来,而路由器只是一个小小的线性层。他们看到的专家恰恰相反,有一个整个都在处理桌游里的 RPG 首领。
让智能体当研究员:解释要能被推翻
上面这些数字背后,是智能体带来的研究规模。按 Cammarata 的描述,在卷积网络上,智能体能给神经元和回路做标注,搭出可浏览的“显微镜”界面再自己去逛,反复检验解释,追踪数十万张归因图;他本人手看过的语言模型归因图也有数千张。
规模一大,最该担心的是 AI 编出一个听着合理的故事。文章用了几种办法,让解释变成可以输掉的假说。
盲测最大激活。 第一个智能体研究一个神经元,写下一段简短解释;第二个智能体看不到神经元,只看这段解释,写出一个它认为能让神经元最强烈激活的例子,再交给网络实测。结果通常是一句简单好读的话,激活强度可以超过他们在 100 亿词元语料里找到的任何样本。原文给了两个例子:
| 智能体 1 写下的解释 | 智能体 2 只凭解释写出的句子 | 语料里最强 | 智能体 2 |
|---|---|---|---|
| 这个单元在不可数名词“action”表示“参与其中、正在运作”时激活 | He was a journeyman reliever who saw action in 412 games over eleven seasons. | 15.0 | 18.4 |
| 当请求已经到达负责的一方,预测“我们在处理了”这类表态 | 用户报告更新后收不到通知,官方客服回复“感谢反馈,我们这边能复现,开发同事……” | 82.0 | 99.5 |
Cammarata 的理解是,把神经元当成一个靶子更准确:意义从靶心向各个方向往外长,每个输入都在做自己的小判断,最大激活就是它们最一致的地方。一百亿个真实词元都有机会,而一句只凭解释写出来的话离靶心更近。
盲测只测靶心,测不到宽度。一个神经元如果有几项工作,一次盲测可能只碰到其中一项。所以他们还把流入神经元的归因聚成几束。比如一个宠物芯片神经元,上游分成动物标记、走失与救助、芯片与 RFID 识别三束,从同一个中心往三个方向延伸。然后每束单独做一次盲测,把其他几束消融掉,再和同样消融条件下的最强语料样本比较。如果某一束是被塞进来、而不是长出来的,它就会表现为一个和其他束都无关、却仍能驱动神经元的解释。附录里还有一种测试:专门写“看着很像、其实不该触发”的近似反例去难为解释。再加上把神经元调高看模型输出(steering)、把它置零看行为变化(消融),解释不对的时候总有一处会露馅。
他对“用解释预测激活”这类总分指标信得有限。“猫和汽车”这个解释,在 V 神经元的很多测试上都能拿不错的分,同时完全没抓住它是什么;要推翻它,得有人注意到它连着火焰。牛顿引力解释了大量观测,最后在水星轨道的一点偏差上出了问题。最好的批评,总是针对具体猜想的。
填字游戏:越往后越好填
Cammarata 认为可解释性有一种惯性,像拼图或填字游戏。刚开始只盯着一个神经元,看不懂就什么都帮不上:回路和归因图只能用其他还没看懂的神经元来解释它。等图填得差不多,一个看不懂的神经元可以从它连着什么、周围的生态、所在专家擅长什么去推,每条线索都能拿来做实验。所以“几乎全空”和“基本填满”都是自然的停留状态。
一个例子:有个神经元追踪“买了便宜货,结果比贵的还好用时那种理直气壮”。追踪微妙情绪和社交场合的神经元,是他们找到的最常见的一类。地图空白时,你只会看到它在一堆看似无关的逗号上激活;地图填满后,你知道这类神经元常在逗号上激活(那是模型汇总一句话意思的地方),于是去读前后文,再看调高它时模型写什么、上游怎么搭、下游做什么、负极是什么,还能专门测它对哪些商店品牌有反应。任何一项都可能推翻解释,结果都指向同一处。
工具也因此受益。只能看懂网络的 2% 时,分不清是工具坏了还是网络乱;看懂大部分时,剩下的部分会直指工具的毛病。前面那个 SwiGLU 双负回声就是这样发现的,他认为把很多神经元混在一起的分解方法很可能会把它掩盖掉。
规模在这里反而帮忙。在小镇上问“金融区在哪”几乎没有意义,银行在一条街,保险公司在另一条街;在纽约,一分钟就能在地图上找到。他们在三个 ConvNeXt 上看到了小号的版本:在大模型里,智能体更快找到了标注好的狗耳神经元,因为浅色的、波浪形的、头侧的各种耳朵神经元都汇进一个“下垂的耳朵”神经元,正好当起点。
他把这些归结为可解释性的“苦涩的教训”。Rich Sutton 2019 年写过,AI 研究反复证明,利用规模的简单通用方法终会胜过精心设计的巧办法。Cammarata 的版本是:把普通的观察、假设、检验放大规模去做,可能胜过不断设计更巧妙的分解方法。
约 85% 的把握:没解决的部分和反对的声音
Cammarata 把论证收成四步:网络只用一种学习原理(泛化),不用两种,所以可以直接对它做普通科学;用现代模型和工具,这门科学比多数人预想的顺利;理解会复利,图越填越好填,所以网络自己的机制至少该进工具箱;第四步他自己标为“高度推测”:这也许就是需要的大部分东西,可解释性可能比想象的好解决得多,甚至在近期。
他在 X 上发布时的说法是,他现在认为雄心勃勃的可解释性会在最需要它的时候被解决,而且可能很快。注意这是预测,不是宣布已经解决。文章本身留下的空白也不少。
他自己承认的边界:
- 把握约 85%。 他在“关于标题”的附录里解释:85% 指的是“几乎所有机制都来自泛化这一种过程”,不是“85% 的机制是干净的”。标题既高估了证据(并没有审计完每个网络),也低估了他相信的东西。“干净”的意思不是每个神经元都对应一个人类已有的概念,而是网络的各部分本来就是为了让下游读取、在其上继续搭建而长成的。
- 注意力进展少得多。 他坦言不确定有没有人足够理解注意力,能断言它的难读就是叠加。他的估计是,给每个注意力头起一个全局名字,额外能多解释的大约 5%;一个智能体在没看到他估计的情况下看了 100 张归因图,也给出约 5%。这是低把握的估计。他还猜测,注意力头会像小模型的神经元一样宽、带很多递归泛化,因为数量少得多:Qwen3-32B 只有几千个头,神经元超过一百万。
- 残差流没法完全排除。 残差流里可能存在一种连续版本的“乱塞”,彼此交织、接受一点干扰换取更多存储,这在原理上排除不了。他们把中型 ConvNeXt 的残差流收窄到四分之一和八分之一(最后一个块只剩 46 维),准确率从 72% 降到 60% 和 39%,残差流的图变得更乱,但没有看到巧妙的交织,漏进来的仍是同类的东西:一个“水面上的深色鸟”神经元,也会对短吻鳄和游泳的寻回犬有反应,不会对时钟有反应。语言模型的残差流看得更少。
- 大模型的完整审计还没做。 Kimi K3 那张归因图之外,这个规模的全面审计尚未开始。语言模型的细节要等配套技术论文。
- 还有没解释透的例外。 InceptionV1 里一个神经元收集“中间收紧”的形状:领结、蝴蝶、泳衣上衣,但也连带着皮鞋、沙滩包和人字拖,因为它们在更早的层里共享神经元。他倾向于叫它“带语义残留的泛化”,但承认还没完全理解。
- Toy Models 的结论在玩具世界里成立。 他说没在 Anthropic 的 Toy Models of Superposition 实验里发现问题;分歧在于真实网络处在哪个世界。玩具模型只算共享神经元的代价(干扰),没算好处(复用),里面每个特征都是终点,没有下游在它们的共同点上继续搭建。真正彼此毫无关联的记忆才会去“乱塞”,而真实数据里几乎没有什么和别的东西完全无关。
不同意的声音。 Hacker News 的讨论里,有几类带技术内容的质疑:结论超出了实验证明的范围,渐进式特征复杂度早就被知道,和参数复用并不互斥;有人认为有理论理由相信叠加存在于残差流,而不是 MLP 神经元的激活里,也不只靠一个例子;有人觉得这种“找到关键范式、剩下只是扩大规模”的兴奋,像极了 Anthropic 早期大规模 SAE 结果出来时的气氛。
最尖锐的批评来自 Eliezer Yudkowsky。他在 X 上把文章概括成“原以为很难找到只为埃菲尔铁塔激活的单个神经元,现在发现大模型里又能找到了”,并说这些研究还停留在非常原始的游乐场里,离理解一个心智怎样思考,只是最初的起点;在能用来做对齐的层面上,机制可解释性也不是去发现某类概念被激活了。
这两种看法其实落在不同的问题上。Cammarata 回答的是“能不能直接读神经元”,Yudkowsky 质疑的是“读懂神经元离读懂一个心智、离确保它安全还有多远”。前者有大量可检验的实验,后者文章自己也只给了推测:如果能读懂系统,也许就能做简单、谨慎的修改,比如移除一个被证明有毒的强化学习环境,而不必把梯度推过用来观察的工具。
还要说明利益关系:Goodfire 本身是一家做可解释性研究的公司,这篇文章也是它发布的。
现在就用得上的几条看法
就算第四步的乐观最后没兑现,这篇文章里有几条看模型的办法,现在就用得上。
描述神经元时先别用名词。 把“猫和汽车”换成“尖的对圆的”,再去看负极是什么。负极给出的是“在这个位置,网络在区分什么”,也是检验一个分组是否真实的快捷办法:V 神经元的负极是 O。
看不懂时,先查工具、数据和架构。 样本只截两段文字,长上下文神经元就全像多义;可视化在深层会跑偏;SwiGLU 的双负回声会占满激活列表;没有残差连接的旧架构,末层本来就学得差。这些都能检验,而“网络把无关东西塞在一起”只能靠排除。
保留原始神经元,分解方法放在后面用。 Cammarata 不反对稀疏词典,但他看到 SAE 会把 V 神经元拆成一个汽车特征和一个猫特征,离神经元实际在做的事更远。探针(probe)只能回答事先想好的问题,教不了你该问什么。他的顺序是先学会读网络自己的组织,词典和探针放到最后。
小模型不一定更好研究。 2023 年他也以为小而简化的模型是最好的起点。现在他认为恰恰相反:残差流、LayerNorm 这些“附加件”本来就是为了让网络学得更好,简化掉它们,神经元就容易学得差;大模型的神经元更窄,模式更容易辨认。
回到开头那个神经元。看出 V 并不难,Cammarata 说他用了大约五秒,他拿这组图问别人“共同模式是什么”,多数人也能看出来。难的是先相信这个神经元找到了某种真实的东西。他说两种错误并不对称:假设网络是干净的而你错了,一个乱的神经元就是线索,你会去查,解释会越查越准;假设网络是乱塞的而你错了,一个乱的神经元就是终点,你不再研究它。他自己做了多年后一种假设,这个假设又替他把能推翻它的证据解释掉了。按他的说法,他把差不多十年花在研究怎样看模型上,而不是真正去看它。