摘要 10 月 6 日,OpenAI 把一个尚未发布的内部模型做出的数学成果放上 GitHub:722 篇手稿,归成 372 个成果族,清单上有准黎曼猜想、四维挂谷猜想和唯一游戏猜想。OpenAI 说这是评估模型时的产出,约 4000 个研究问题,平均每个结果约 3 小时 ChatGPT Pro 思考算力。翻开仓库是另一面:有 Lean 形式化说明的成果族是 235 个,说明里覆盖到的论文只有 330 篇;四维挂谷、CM 阿贝尔簇的霍奇猜想、有理数域上的希尔伯特第十问题都没有形式化。证明可以批量生产了,核对和读懂还得靠人。
9 月 8 日,OpenAI 宣布证出了 Navier–Stokes 千禧年难题。按它自己的公告,做出结果的那一组用了约 1 万个并行智能体,从启动到出结果约 88 小时,单这一道题就用掉约 1300 亿个输出 token。
不到一个月,10 月 6 日,同一个内部模型的另一批产出出现在 GitHub 上:722 篇数学手稿。这一回 OpenAI 报的成本是,平均每个结果约等于 3 小时 ChatGPT Pro 的思考算力。
两个数字口径不同,没法直接相除,但落差一眼看得出来:一个月前是上万个智能体围着一道题转,现在是一套固定流程批量出结果。接下来要弄清两件事:这 722 篇是什么,以及它们现在算不算“证明了”。
openai/math 仓库:约 4000 个问题,留下 372 族、722 篇手稿
按仓库 README 的说法,这批东西是评估模型时的产出:原有的数学评测已经“饱和”,分不出高下,团队就把评估扩到了还没人解决的研究问题上,其中一部分成果建立在模型自己先前的结果之上。
整个评估里,模型一共被问了约 4000 个问题。输出先归并成“成果族”,再按“足够重要”的标准筛一遍,留下 372 族、722 篇手稿。一个成果族通常是一个主结果,加上配套论证、推论或者另一种证法。
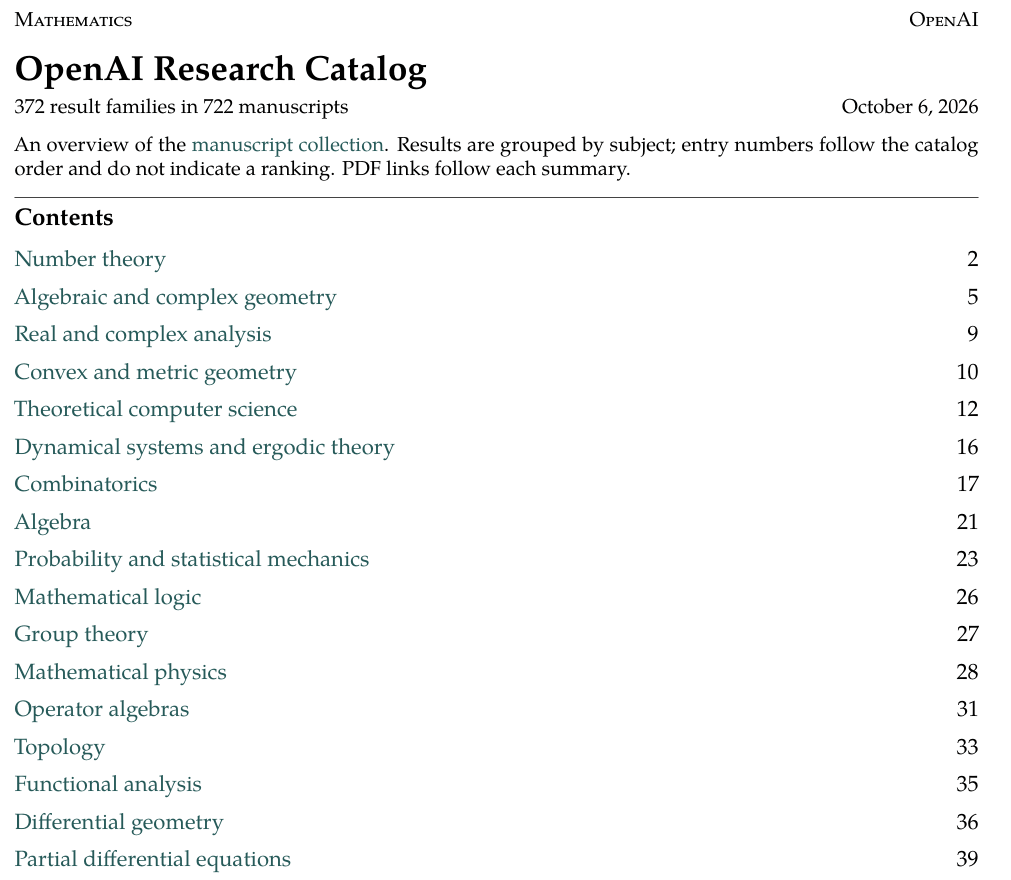
372 族分在 17 个方向里。最多的是理论计算机科学(40 族)、组合数学(37 族)、代数与复几何(36 族)和数论(31 族),最少的数理逻辑也有 6 族。手稿的文件夹名带着日期:9 月 23 日 176 篇,9 月 24 日 193 篇,两天合计 369 篇,过了总数的一半。
成本上,README 写的是:绝大多数结果用同一套流程、同一个未发布的内部模型得到,平均每个结果约 3 小时 ChatGPT Pro 思考算力。它也列了例外:黎曼 ζ 函数无零点区域的工作,和 CM 阿贝尔簇霍奇猜想的证明,没有走这套固定流程;ζ 函数那一族里有一篇手稿,文字还经过人工润色。
和手稿一起放出的还有三样东西:一部分证明的 Lean 形式化,10 份模型推理过程的摘要,以及算力和尝试问题数的统计。
有两件事没有公布。一是模型的名字,博客只叫它“内部前沿模型”;OpenAI 发言人对 WIRED 说,它从 8 月 28 日开始训练,Navier–Stokes 也是它做的。二是 4000 到 372 之间发生了什么:多少问题没做出来,多少做出来了但没过“重要性”这一关,README 没有拆开说。所以 372 除以 4000 不是成功率。
清单上的名字:准黎曼猜想、四维挂谷、唯一游戏猜想
先说清一点:下面的“证明”“推翻”都是 OpenAI 手稿自己的说法,绝大多数还没有经过同行评审。
| 编号 | 问题 | 手稿的结论 | Lean 形式化 |
|---|---|---|---|
| 003 | 准黎曼猜想 | 实部大于 7/8 的地方,ζ 函数没有零点 | 有 |
| 074 | 挂谷猜想 | 三维极大函数版本和四维的维数猜想成立 | 没有 |
| 102 | 唯一游戏猜想 | 成立,Max-Cut 等问题的近似极限一并证出 | 有 |
| 032 | 霍奇猜想(CM 阿贝尔簇情形) | 成立 | 没有 |
| 004 | 希尔伯特第十问题(有理数域版本) | 不存在通用的判定算法 | 没有 |
| 287 | 自由群因子同构问题 | 不同秩的自由群因子全部同构 | 有 |
| 157 | Hadwiger 猜想 | 不成立,有任意大的反例 | 只覆盖同族另一篇 |
| 017 | π 的无理性测度 | 恰好等于 2 | 有 |
| 158 | 平面染色数 | 5 种颜色不够,只剩 6 或 7 | 有 |
挑三个说说这些题在问什么。
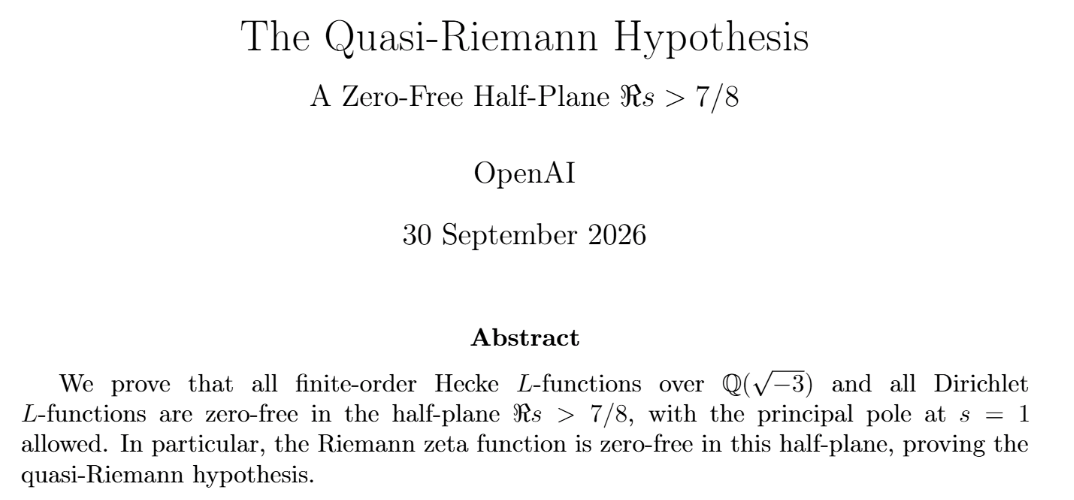
准黎曼猜想:7/8
黎曼猜想说,ζ 函数的非平凡零点全都落在实部等于 1/2 的那条竖线上。这个目标太远,数论学家退了一步:能不能找到一个小于 1 的数 θ,保证实部大于 θ 的整片区域里一个零点都没有?一百多年里,人们能证明的无零点区域都紧贴着实部为 1 的那条线,越往上越窄,始终没有撑出一条固定宽度的带子。OpenAI 的手稿给出 θ = 7/8,并且对所有狄利克雷 L 函数同时成立。
挂谷猜想:从三维到四维
起点是 1917 年日本数学家挂谷宗一的一个小问题:一根针在平面上转一整圈,最少要扫过多大面积?它的高维版本后来成了调和分析的核心难题。2025 年,王虹和 Joshua Zahl 用 127 页证明了三维的挂谷集合猜想,王虹今年 7 月因此拿到菲尔兹奖。OpenAI 这一族手稿说自己又往前走了两步:三维更强的“极大函数”版本,加上四维的维数猜想。X 上很快有人感慨,三维挂谷刚拿了菲尔兹奖,四维挂谷就被 AI 解决了。
唯一游戏猜想:一锤定一批
这个猜想由 Subhash Khot 在 2002 年提出,分量在于连带效应:只要它成立,一大批优化问题“最好能近似到什么程度”就有了定论,比如把图的顶点分成两组、让跨组的边尽量多的 Max-Cut。手稿声称给出了完整证明,还另用直接的归约,证出了 Max-Cut、顶点覆盖的最优近似门槛。
清单里还有不少结论是“推翻”。按摘要里的用词粗略统计,写着证伪或反例的成果族有 60 个左右,其中有 1943 年提出、被看作四色定理推广的 Hadwiger 猜想,也有 Kaplansky 关于群代数的零因子猜想。
Lean 形式化覆盖了多少:按族 63%,按篇 46%
Lean 是一种编程语言,也是证明检查器:把证明写成代码,由一个很小的内核逐步检查,每一步推导都合规才算通过。它能回答的问题很窄,也很硬:写下来的这条命题,确实被推出来了。
仓库给每个做了形式化的成果族配了一页说明,写清楚覆盖哪几篇论文、哪几条命题,还附上只有命题、没有证明的“挑战文件”,方便别人核对机器证的到底是哪句话。372 族里有 235 族有这样的说明页,占 63%。
这个 63% 是按族算的。一个族里可以有好几篇论文,把 235 页说明里点名的论文逐一数下来,是 330 篇,占 722 篇的 46%。其中 67 个族,说明页列出的论文比族里实有的少。
最典型的是 157 号,Hadwiger 猜想那一族。族里有三篇手稿:Hadwiger 猜想的反例,另一个着色猜想的反例,还有一个正面结论(列表色数不超过 Hadwiger 数的常数倍)。Lean 说明页只列了第三篇。这一族挂着 Lean 的标记,可最受关注的那篇反例并不在机器检查的范围里。 Bloch 定律(271 号)和二维 O(3) 模型(215 号)两族也是这样,被形式化的是同族里的另一篇。
也有覆盖得很扎实的。准黎曼猜想的说明页写明,7/8 这条结论对 ζ 函数和全部狄利克雷 L 函数都做了形式化,同时注明“论文后面的应用不包含在内”。唯一游戏猜想一族五篇手稿全部在列。
剩下的 137 族没有任何形式化,里面恰好有几项最受关注的:四维挂谷、CM 阿贝尔簇的霍奇猜想、有理数域上的希尔伯特第十问题,还有两族 BSD 公式和 Baum–Connes 猜想的反例。README 对这部分的原话是:未形式化的结果“可能存在问题”,会尽快修正。
即使 Lean 通过了,事情也没完。8 月底有一篇讨论这件事的 arXiv 论文,把“已验证”拆成三层:推导有没有错,内核能查;形式化的命题是不是数学家原本问的那个问题,只能靠懂行的人读;结果有多大意义,更是人的判断。它举的例子就是 OpenAI 自己:8 月 1 日公布的十项数学成果,每一项都带着没有缺口的 Lean 证明,四周之后,其中 Connes 刚性猜想的反例仍然陷在争论里,争的是一组引理能不能用在实际构造出的那个对象上。这种问题,内核不会替人提出来。
这次的形式化目录文件里,OpenAI 自己填的状态是三个词:范围 Partial progress,生成方式 agent,审阅 unchecked。
IAS 的发布建议:OpenAI 做到了哪几条
这次发布的方式,本身就是两个月争论的结果。
据 WIRED 报道,8 月 OpenAI 召集了约 40 位数学家,讨论“如果 AI 在数学上超过人类怎么办”,并暗示模型已经解决了数百个长期难题。与会者说,公司当时保证不会一次全放出来;OpenAI 发言人的回应是“不知道”有过这样的保证。西北大学数学家 Bryna Kra 回忆,现场的情绪是“兴奋与恐惧交织”,大家提的要求是别再只靠博客和推文发布,要写成论文,让数学家能消化、能使用。
9 月 11 日,陶哲轩等 25 位菲尔兹奖得主联署了一份声明,标题是《AI 在数学领域的严重错位》。核心是一句话:解题只是工具和代理指标,首要目标是概念上的理解与洞见。声明担心,越来越快地批量生产“对或错”的命题,可能毁掉滋养新想法的土壤;匆忙宣布结果,则留不出时间写好论文、提炼方法、引用前人,带来署名和抄袭的问题。
9 月 29 日,高等研究院(IAS)的数学与人工智能咨询小组汇总了 600 多份数学家的问卷,发布了一份给 AI 实验室的发布建议。OpenAI 这次在博客里援引的就是它。
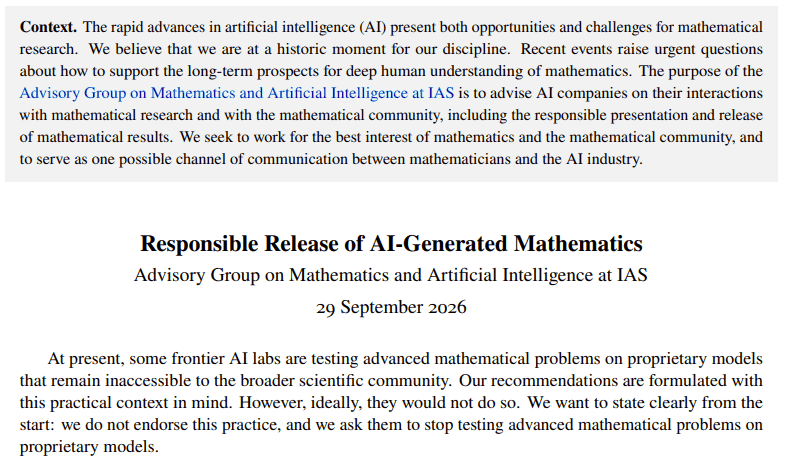
这份建议的第一段并不客气:小组不认可实验室在外界用不到的专有模型上测试前沿数学问题,并要求它们停止这样做;后面的条款,是在“它们反正在做”的前提下写的。逐条对照,OpenAI 做到了一部分:
| IAS 的建议 | OpenAI 这次的做法 |
|---|---|
| 写成传统论文的体例,检索并引用已有工作 | 722 篇手稿,每篇附引用格式;博客承认引用、阐述和呈现还要改进 |
| 存入不受任何 AI 实验室控制的学术仓库,有固定标识和修改记录 | 放在 OpenAI 自己的 GitHub,承诺保留版本历史;称在探索社区托管 |
| 公开模型名称、提示词、推理摘要、耗时和算力成本 | 模型没有名字;给了 10 份推理摘要和“平均 3 小时”这个成本数 |
| 尽可能形式化,并附可供核对的挑战文件 | 235 族有 Lean 说明页和挑战文件,其余没有 |
| 批量发布时说明还试了多少同等难度的问题、失败多少、怎么选的题 | 只有一个总数:约 4000 个问题 |
| 出资支持会议、研讨班和综述写作,帮人读懂这些结果 | 承诺资助一系列研讨会、会议和专题项目,细节待公布 |
建议里还有一句专门的提醒:不要把发布数学成果当成推销模型的手段。发布当天,Sam Altman 在 X 上配的话是“我们正在进入一个发现的新时代”。这一条算不算做到,留给读者判断。
读完可以带走的三点
- 看到“AI 解决了 N 个问题”,先问三个数。 分母是多少(这次是约 4000);验证到了哪一层(有没有形式化,形式化的是哪一篇、哪一句);别人能不能重做(这次模型没发布,提示词也没公布)。三个数都有了,N 才有意义。
- “机器验证过”和“测试全绿”是一回事。 测试通过只说明代码符合测试,不说明测试测的就是需求;Lean 通过只说明证明对上了那条形式化的命题,不说明那条命题就是数学家心里的猜想。检查推导的成本被压到接近零以后,工作量没有消失,转移到了读命题、对定义上,这部分只能由懂行的人一条一条去做。
- 批量产出之前,先想好怎么让人接得住。 IAS 的建议放到工程团队里就是一份发布清单:写成别人读得懂的样子,放在别人能评论的地方,留下修改记录,交代试了多少、失败多少。让 AI 批量生成代码、文档或报告的团队,迟早也要面对同一张清单。
一道题 1 万个智能体,到一个结果 3 小时,证明的生产速度在一个月里变了量级。读证明的速度没有变:王虹和 Zahl 那篇 127 页的论文,是两人自己核对了几个月、又先请同行看过才公开的。接下来真正的成绩单,是四维挂谷、霍奇猜想的 CM 情形、有理数域上的希尔伯特第十问题这几项没有形式化的结果,能不能扛过专家一行一行地读。