摘要 长文本按token计费,人物视频按秒计费。词元所把同一模型的不同供应商放到一起,提供效果、时延与成本的比较,以及资源核验能力。
开发一个长文档问答助手,和让照片里的人物开口说话,需要不同的模型。百度在11月12日发布的文心闪电、文心一镜微表情模型已上线千帆,企业客户和合作伙伴可通过API(供程序调用的接口)使用。与此同时,词元所把另一层选择摆到台前:同一个模型名称,背后也可能有多家供应商。
文心闪电:把长对话的历史信息压紧
问完一份长文档,再围绕它连续追问,模型要带着之前的内容继续回答。文心闪电的官方型号是ERNIE-Light-DT-1.0,结合了百度搜索闪电大模型的研发成果,适用长文档问答、多轮对话,以及Agent调用工具后继续处理返回结果的任务。Agent就是能调用工具、分步骤完成任务的AI。
它采用BSA(Baidu Sparse Attention)稀疏注意力和反馈式历史压缩,优化历史信息的存储与索引计算。KV缓存是模型为前文保留的中间计算结果,后续生成可以复用;按千帆的介绍,这套设计能减少KV存储与计算开销,减少处理长历史所需的资源。页面说的“更低成本”指这部分技术开销,token是模型读写文字和计费的单位,全时段统一价为每百万tokens输入8元、缓存命中0.8元、输出28元。
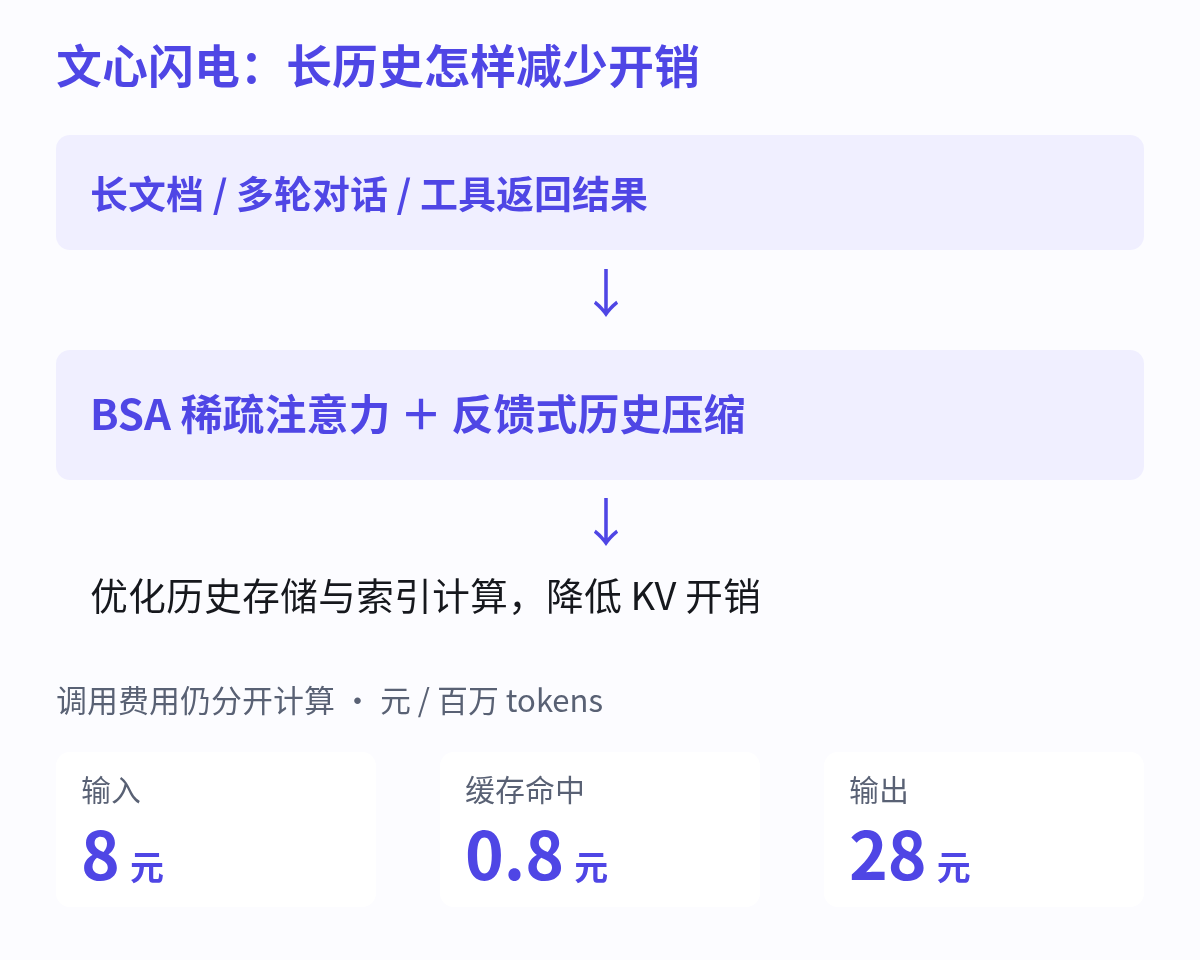
思考模式可以开关,最大输出为128K tokens,这个数指能生成的输出量。千帆称其数学、推理、Agent和Coding效果处于第一梯队,这是官方对公开评测的概括。用于自己的长文档时,更值得看它能否从反复追问中保持事实与条件,而不只是回答写得长。
文心一镜:让人物近景里的表情动起来
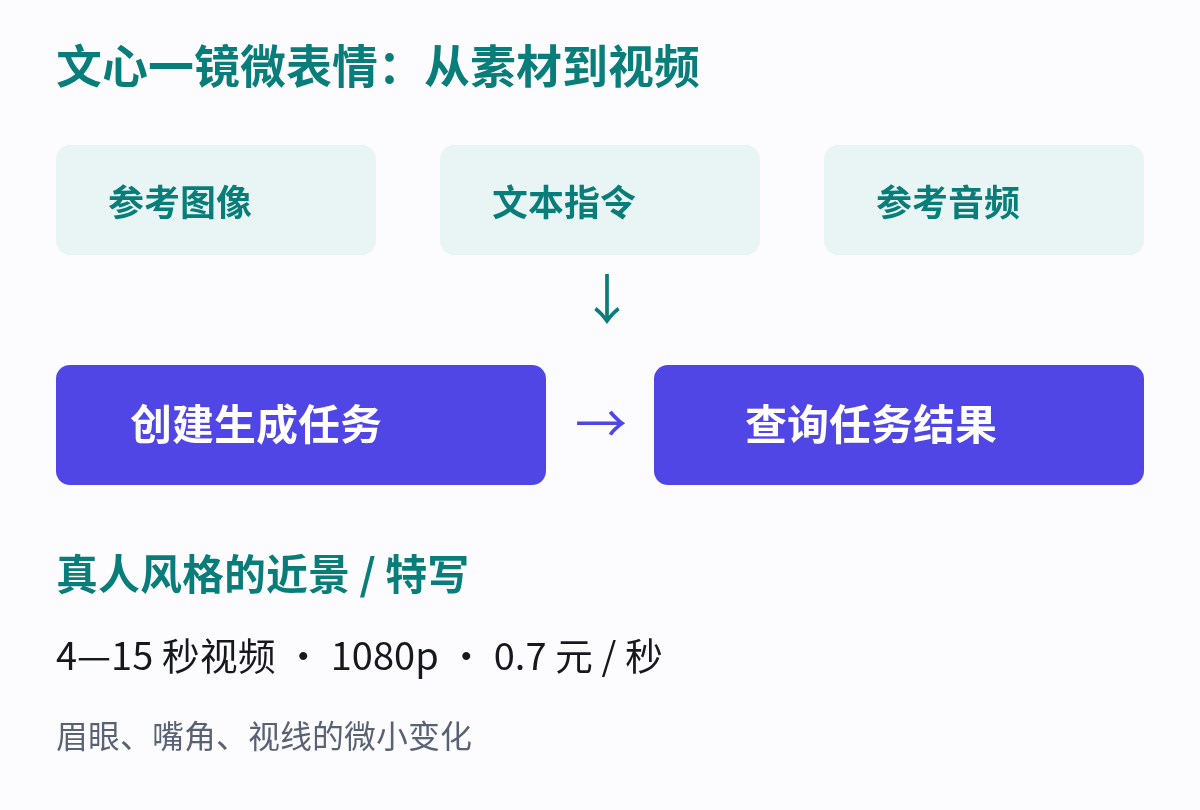
文心一镜微表情模型ERNIE-Wizshot-ME接收参考图像、文本指令和参考音频,生成4—15秒、1080p的真人风格视频。它强调的是人物近景与特写:眉眼怎样变化、嘴角怎样牵动、视线往哪里转,适合口播、访谈或短剧中的特写片段。
调用采用异步两步:先创建生成任务,再查询任务结果。因此,做一段人物口播时,应用要把素材提交和等待成片分开处理;这不是一次请求立刻返回视频的流程。官方刊例价为每秒0.7元,页面给出的5秒口播示例约3.5元。据新华网对大会的报道,另一款百度一镜智能体推出了“短漫剧Studio”,其每秒0.2元的价格属于那个产品。
词元所:模型选定后,还要比较谁来供
词元所当前页面里,deepseek-v4.1-flash列出6家供应商,glm-5.3-flash列出12家,数量会随资源上下架变化。开发者买到的是某家供应商提供的模型调用服务,同名型号只是第一层信息,还要比较响应速度、成功率与价格。
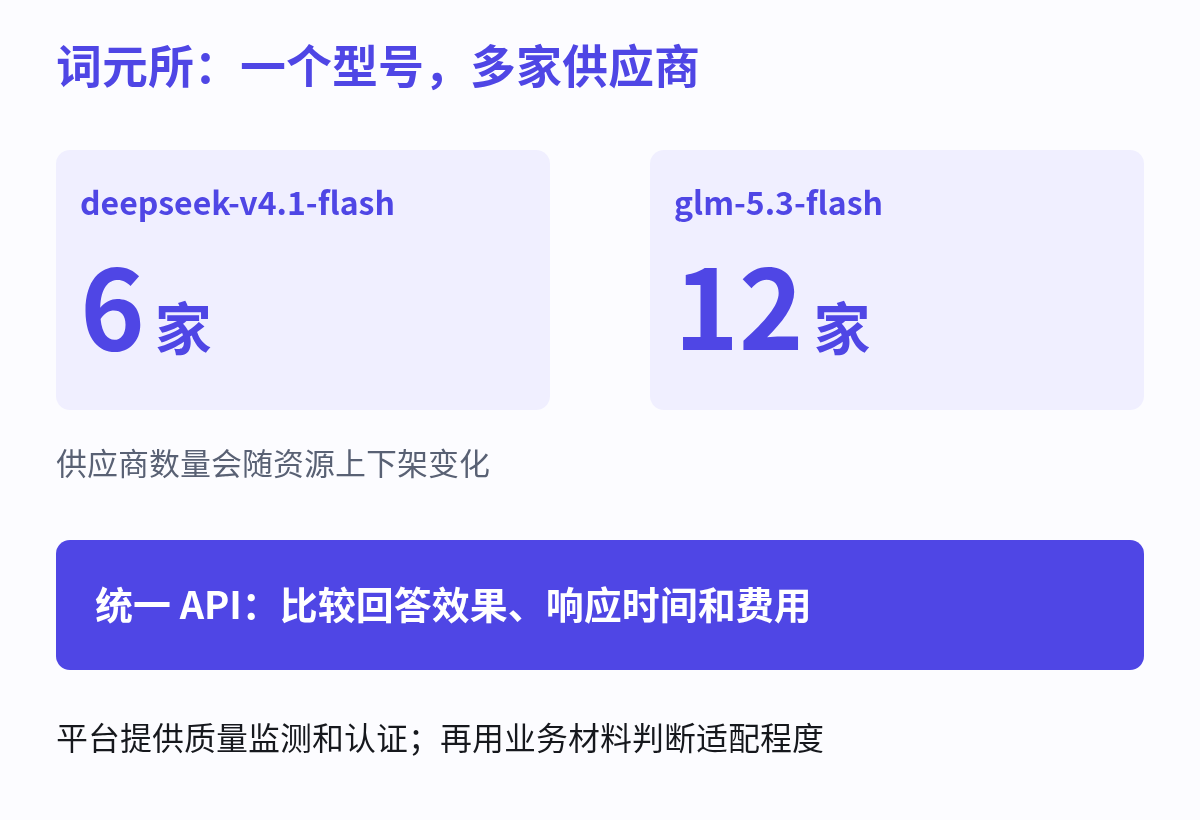
平台用统一API接入多家模型资源,并提供质量参数监测、实时排行和可信认证。其官方页还列出准入测试、定期抽检拨测与模型指纹比对:准入测试在资源接入时检查,抽检关注后续服务是否变化,指纹比对用于辅助核对模型身份。这些是平台公布的核验方式,不等于每次回答都有正确性保证。
实际选择时,可以先用同一份业务材料比较候选资源的回答、等待时间和费用,再决定由谁供应。文心闪电与一镜解决的是处理什么任务,词元所进一步把“由谁提供这次调用”变成可比较的选择。