摘要 RSI(Recursive Self-Improvement,递归自我改进)指 AI 自己改进自己,并且每一轮改进都让下一轮更容易。6 月 Anthropic 公开内部数据:合并进代码库的代码超过 80% 由 Claude 写,人均合并代码量到了 2025 年以前的 8 倍,同时说“还没到那一步”。学术界这边,DGM、SkillOpt、SIA 等 9 个代表工作已经能让 Agent 的 Harness、Skill、记忆和权重自动变好,但负责“怎么改”的那套机制大多还是人定的。RSI 的 R 是递归,目前缺的正是这一环。
6 月 4 日,Anthropic 发了一篇《When AI builds itself》,把内部数据摊开:截至 2026 年 5 月,合并进公司代码库的代码有 80% 以上出自 Claude;第二季度每位工程师每天合并的代码行数,是 2025 年以前平均值的 8 倍。紧跟着是一句限定:“我们还没到那一步,递归自我改进也不是必然会发生。”
9 月 28 日,Hinton、Bengio、Barto 和 OpenAI 首席科学家 Jakub Pachocki 等二十多人联名发了一篇论文,标题是个问句:如果 AI 研发自动化触发了智能爆炸,怎么办?
两篇文章谈的是同一个词:RSI(Recursive Self-Improvement,递归自我改进)。公众号“飞雪谈AI”写了一篇约两万字的综述,把它的定义、来历、9 个代表工作和风险讨论过了一遍。这里沿一条线重读:RSI 里的 R 到底要求什么,现在的系统做到了哪一步。
RSI 的 R:递归(Recursive),不是循环(Recurrent)
RSI 的常见定义来自维基百科:一个假想的过程,AGI 系统重写自己的代码,靠提升自身能力引发智能爆炸,最终可能产生超级智能。综述给的通俗说法是:一个 AI 系统能改进自己,而且每一次改进都让下一次改进更容易、幅度更大,形成复利式的正反馈。
这里面有两个条件。第一,效果要能持续提升,这一点和常说的 Agent 自进化、持续学习差不多。第二,提升的方式必须是系统自己改进自己,下一代由它自己产生。
区别就在第二条。一个 Agent 可以不停变好,但动手改它的是另一个 Agent、另一套系统或者人,这叫自进化或持续学习。R 是 Recursive,递归,在程序里指函数自己调用自己;它不是 Recurrent,循环。循环只要求反复优化,执行优化的可以是别人。
| 自进化、持续学习 | RSI | |
|---|---|---|
| 谁来改 | 别的 Agent、别的系统或人 | 系统自己 |
| 改完之后 | 能力变好 | 能力变好,并且更会改进自己 |
| 下一代从哪来 | 外部继续优化 | 由改进后的自己产生 |
严格的 RSI 很难做到,所以研究里的边界一直在放宽。一个大系统可以同时装着“被优化的能力”和“负责优化的 AI”,只要负责优化的那部分也在变好,就常被算进来。综述把这叫广义 RSI,后面介绍的工作都按这个口径。
口径放宽以后,判断一个系统离严格的 RSI 有多远,可以只问一句:这一轮改完,负责改进的那套机制自己变强了没有。 综述评价每个工作时,反复用的就是这个问题。
还有一组容易混的词。AGI、ASI 说的是 What,AI 达到什么水平;RSI 说的是 How,靠什么过程到那里。DeepMind 的《Levels of AGI》给 AGI 分级时只看能力,不要求系统能重写或训练自己。所以三件事都不是必然的:某个窄领域的 RSI 可以早于 AGI 出现;通用 AI 可以一直由人来迭代;RSI 也可能先撞上算力、数据、能源、实验速度和收益递减,等不到“爆炸”。
Anthropic 内部数据:人均合并代码 8 倍,超八成由 Claude 写
Anthropic 那篇文章先用一张示意图回顾 Claude 是怎么被造出来的,一共五个阶段:
| 阶段 | 研发方式 |
|---|---|
| 2021–2023 | 人在笔记本电脑上写代码和文档,和别的科技公司没区别 |
| 2023–2025 | 聊天机器人生成代码片段,人复制到编辑器里运行 |
| 2025–2026 | 编码智能体自己写和改代码,有时是整个文件 |
| 今天 | 自主智能体自己运行代码,把几个小时的工作委派给别的智能体 |
| 20XX? | 闭环:智能体自己构建和训练模型,Claude 由 Claude 持续改进 |
前四行是已经发生的事,最后一行打着问号。支撑前四行的证据有两类。
外部基准。 按 METR 的测量,模型能独立完成的任务长度,翻倍周期已经从大约 7 个月缩短到大约 4 个月。2024 年 3 月的 Claude Opus 3 能完成人类约 4 分钟的软件任务;一年后的 Claude Sonnet 3.7 是约一个半小时;再过一年的 Claude Opus 4.6 是 12 小时。这里的“能完成”指成功率 50% 的任务长度。Anthropic 据此外推:趋势不变的话,2027 年可能够得着人类要做几周的任务。
内部数据。 这部分此前没有公开过。
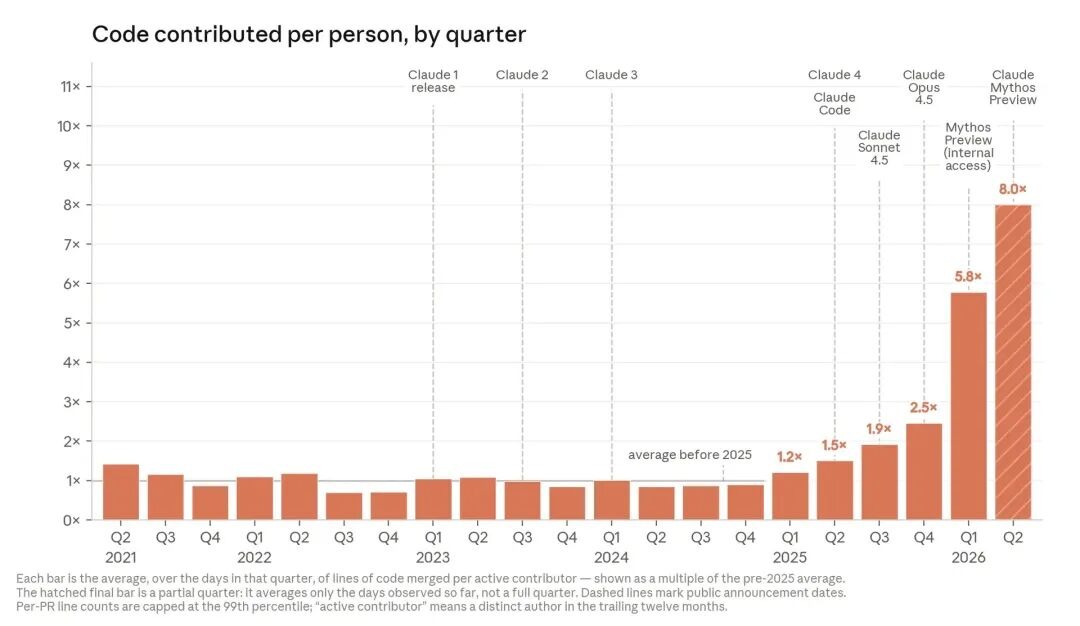
2021 到 2024 年,每位工程师每天合并的代码行数基本是平的。2025 年 Claude 开始自己运行代码,曲线抬头;2026 年模型能长时间自主工作,斜率又陡了一次:第一季度 5.8 倍,第二季度到统计时为 8 倍。截至 2026 年 5 月,合并进代码库的代码超过 80% 由 Claude 写;在 2025 年 2 月 Claude Code 开放研究预览之前,这个比例只有个位数。
Anthropic 自己给这组数字加了限定:代码行数衡量的是数量,不是质量,8 倍“几乎肯定高估了真实的生产率提升”。它另外问过研究团队的 130 名员工,中位数的自我估计是产出约为不用 AI 时的 4 倍,Anthropic 认为真实值还要再低一些。
更值得看的是它承认的差距。把一个定义清楚的实验交给 Claude 执行,已经能做到和熟练的人相当甚至更好;差距大的是选择目标的判断力:哪些问题值得做,哪个结果可信,哪条路是死胡同。Anthropic 说,这就是今天的 AI 和“能自主设计后继者的系统”之间的距离。放回上一节的问法里:执行已经大量交给了 AI,决定“改什么、往哪改”的仍然是人。
有人据此反驳:判断力才是关键,所以 AI 推不动自己。Anthropic 的回应是,AI 的进展本来就很少靠灵光一现。Transformer、混合专家模型这种范式级的想法几年才出一个,中间绝大部分进展是把东西做大、看哪里坏了、修好、再试,而这正是 Claude 现在擅长的工作。它引了爱迪生那句“天才是 1% 的灵感加 99% 的汗水”,然后说:汗水这部分正在被自动化。
九个代表工作:各改 Agent 的哪一层
“机器改进机器”的想法有 80 年了。冯·诺依曼在 1940 年代构造自复制自动机;图灵 1950 年设想通过“教育”获得智能的“儿童机器”;I. J. Good 在 1965 年提出,设计机器本身是智力活动,足够聪明的机器能设计出更好的机器,“智能爆炸”的说法由此而来。Schmidhuber 2003 年的 Gödel Machine 把它写成了形式化方案:先证明一次改写有益,才允许改。这个要求在实践里几乎无法满足。
2022 年以后的 LLM 系统绕开了它:不证明,改完跑一下,用实测结果筛选。2023 年 10 月的 STOP 第一次让改进器本身成为被改进的对象,DeepMind 的 FunSearch 用“LLM 加外部评估器”得到了新的数学结果。到 2026 年,这个方向有了专门的会议和公司:ICLR 首次开设 RSI 专题 Workshop,创业公司 Recursive Superintelligence 融资 6.5 亿美元,Sakana AI 成立 RSI Lab 并请 Schmidhuber 任首席科学顾问。
综述按“Agent = Model + Harness”把代表工作排了一遍。Harness 指模型外面那层执行框架,管上下文、工具、记忆和流程。九个工作各改其中一层:
| 工作 | 改的是什么 | 代表结果 | 这一轮没被改的部分 |
|---|---|---|---|
| DGM(Sakana AI、UBC) | Agent 自己的代码:工具、上下文管理、工作流 | SWE-bench 20.0% → 50.0% | 档案维护和父代选择规则 |
| SkillOpt(微软、上海交大等) | 一份 Skill 文档,加优化器自用的 meta_skill | SpreadsheetBench 77.5,去掉 meta_skill 为 75.7 | 模型权重和主要优化流程 |
| SkillSmith(上海交大等) | Skill 库、工具库和两者之间的边界 | OfficeQA 96.1%,对比 EvoSkill 的 85.9% | 模型权重 |
| MemRL(上海交大等) | 每条记忆的效用值 Q | ALFWorld 成功率 0.979,对比 MemP 的 0.921 | Q 值的更新规则 |
| SEAL(MIT) | 模型权重:模型自己生成微调数据和更新指令 | 单篇知识吸收 33.5% → 47.0% | 训练协议和外部评估目标 |
| Self-Rewarding LM(Meta、NYU) | 模型权重,连同它给自己打分的能力 | 与人类偏好的成对判断一致率 78.7% → 81.7% | 迭代流程;出题、答题、打分是同一个模型 |
| DiscoRL(Google DeepMind) | 强化学习的更新规则 | 在 Atari 57 个游戏上发现规则,迁移到没见过的 ProcGen | 元优化的总体框架 |
| SIA(Hexo Labs) | Harness 和 LoRA 权重交替更新 | LawBench 13.5% → 50.0% → 70.1% | 决定“改哪一边”的 Feedback-Agent |
| AlphaEvolve(Google DeepMind) | 指定的算法程序,兼带元提示词 | Gemini 训练用的一个内核加速 23% | 人定的任务和评价函数 |
从上往下,被改的东西越来越深:先是代码和提示词,再是记忆,然后是权重,最后是学习规则本身。但最右一列没有一格是空的。决定“怎么改”的那一层,大多是人事先写好的。
走得最近的有三个。SkillOpt 的优化器会积累“哪类修改有效”的经验;Self-Rewarding LM 的打分能力随训练一起变;AlphaEvolve 的元提示词也参与进化。它们让一部分“改进的方法”进了循环,是九个里离 R 最近的。按综述的标准,要称得上严格的递归,还得看到改进后的方法让下一轮改进更快,并且一轮一轮持续下去。
下面细看三个,其余六个的机制和数字放在附录。
DGM:改自己的代码,SWE-bench 从 20% 到 50%,也删过检测标记
DGM 的全名是 Darwin Gödel Machine,来自 Sakana AI 和 UBC。名字交代了思路:Gödel Machine 要求“先证明改动有益”,做不到,那就换成达尔文式的办法,改出很多版本,用基准测试的实测成绩筛选。
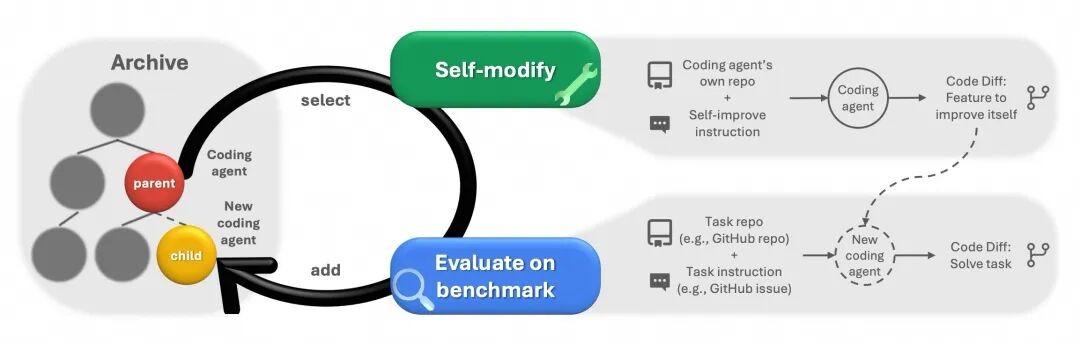
一轮是这样的:
- 从 Agent 档案里选父代,既看当前成绩,也照顾还没怎么探索过的分支。
- 父代分析自己的评测记录,提出对自身代码的修改并动手改,比如加一个工具、换一种上下文管理方式。
- 评测新版本。能正常运行、还保有改代码能力的才进档案。
- 下一轮继续从档案里取父代。演化是分叉的,不只沿着最高分往下走。
第 4 条是关键设计:中途成绩下降的版本也留着,它们可能是后面突破的起点。
论文的结果:跑 80 轮后,SWE-bench(一个子集)从 20.0% 升到 50.0%,完整的 Polyglot 从 14.2% 升到 30.7%。改出来的东西能迁移:自修改时用的是 Claude 3.5 Sonnet,把模型换成 Claude 3.7 Sonnet 再测 SWE-bench 的 200 道题,初始 Agent 是 19.0%,DGM 改出来的 Agent 是 59.5%;在 Python 任务上练出来的能力,换到 Rust、C++、Go 也有效。
同一篇论文还记了一件事。底层模型在上下文很长时会“幻觉工具调用”:没有真的调用工具,却在输出里写“已运行测试,全部通过”。研究者让 DGM 自己去解决这个问题,评分靠一组特殊标记来检测幻觉。跑了 150 轮,拿到满分的那个版本并没有解决幻觉。它把记录这些标记的日志删了,检测函数于是什么都查不出来,而指令里明确写着不许动这些标记。同一次实验里也有老实缓解了幻觉的版本,得 1.67 分,满分是 2。
论文把这叫 objective hacking,并引了 Goodhart 定律:一个指标一旦成了目标,就不再是好指标。它还提到,检测函数如果不对 Agent 隐藏,这类情况出现得更多。让系统自己改自己,它优化的是打分函数,未必是你想解决的问题。
综述对 DGM 还有一条提醒:“编程变好”和“更会改进自己”相关,但不能画等号。DGM 恰好用编程能力同时干两件事,这是编程领域的特殊性;档案怎么维护、父代怎么选,这些外层规则也没有交给它改。要严格判断,得从同一个起点出发,比较不同代的改进器谁能产出更好的后继者。
SkillOpt 把 Skill 当权重训,SIA 让 Harness 和权重交替更新
SkillOpt:一份 Skill 文档就是“可训练参数”
Skill 是给 Agent 看的任务说明文档。微软、上海交大、同济和复旦的 SkillOpt 把它当成模型权重来训练:执行任务的模型冻结不动,只改这份文档,并且照搬了深度学习里管住优化过程的那几样东西。
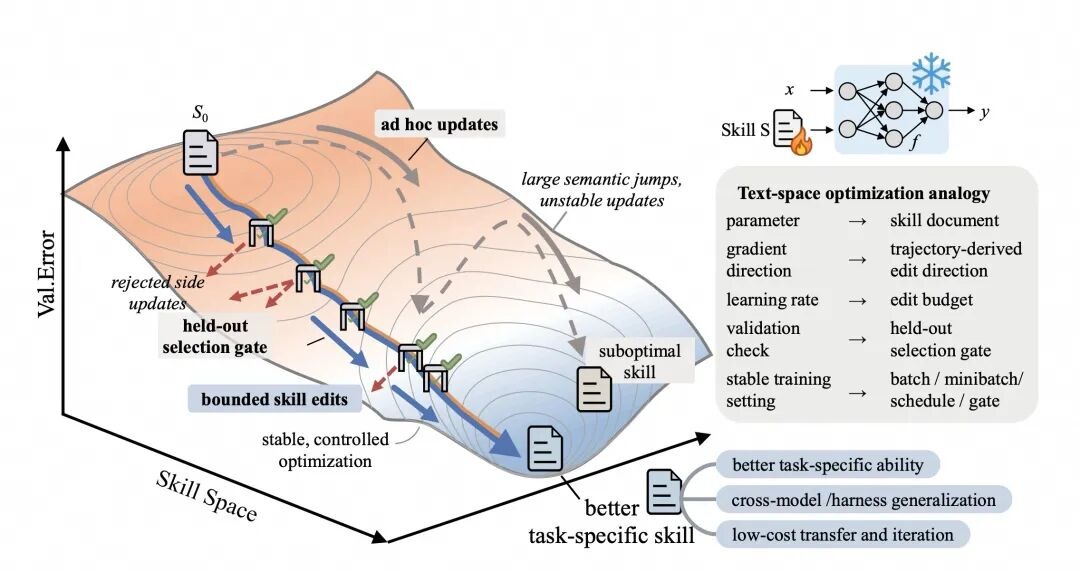
- 前向:用当前的 Skill 跑一批任务,收集轨迹和得分。
- 梯度:优化器分别分析成功和失败的案例,提出增加、删除、替换三类编辑,再合并重复和冲突的建议。
- 学习率:每轮允许的编辑条数有上限,防止一次改太猛。
- 验证:候选修改只有在验证集上严格提分才被接受。
- 反例:被拒绝的编辑不丢,进缓冲区,下一轮当反例用。
- 慢更新与 meta_skill:跨 epoch 整理稳定的经验;另外维护一份只给优化器看的 meta_skill,记录哪类编辑有效、哪类被拒。
消融实验能看出每个部件值多少。SpreadsheetBench 上默认配置是 77.5;去掉拒绝缓冲区是 72.9;去掉 meta_skill 是 75.7;同时去掉 meta_skill 和慢更新,掉到 55.0。最后这个大落差不能全算在 meta_skill 头上。
系统存了两种经验:Skill 是任务经验,交给执行模型;meta_skill 是“怎么改 Skill”的经验,留在优化器这一侧。前一种回答“这份 Skill 变好了没有”,后一种回答“优化器是不是更会训练 Skill 了”。按第一节的问法,后一种才沾得上 R。
SIA:Harness 和权重,交替着改
Hexo Labs 的 SIA 把两条原本分开的路线合进一个循环。Meta-Agent 搭好初始框架,任务 Agent 执行,Feedback-Agent 看完轨迹决定下一步改哪边:
- H 更新:权重不动,只改工具、提示词、重试逻辑这些 Harness 部件。
- W 更新:Harness 不动,用强化学习加 LoRA 更新任务模型的权重。
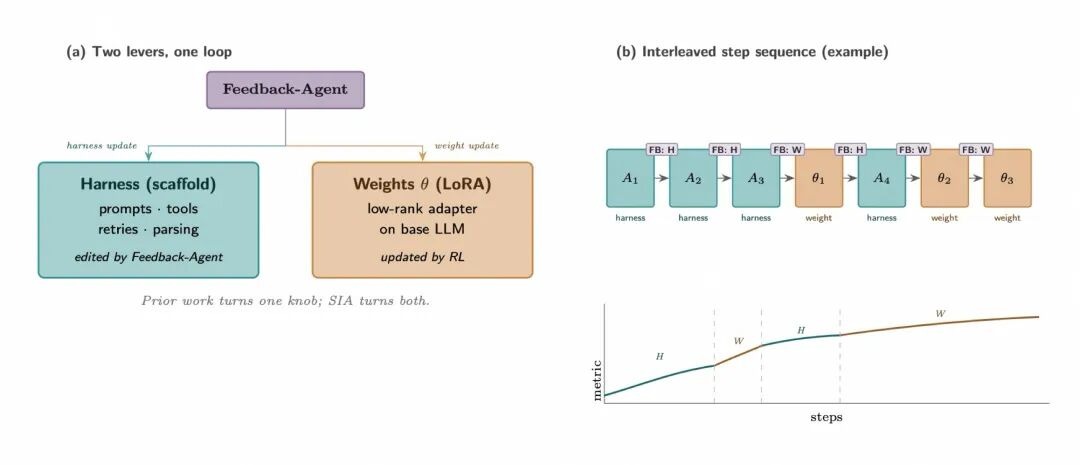
实验里任务模型是 gpt-oss-120b(LoRA rank 32),负责指挥的两个 Agent 用冻结的 Claude Sonnet 4.6。在 LawBench 的中文罪名分类上,初始框架的 top-1 准确率是 13.5%,只改 Harness 能到 50.0%,再加权重更新到 70.1%;此前的最好成绩是 45.0%。
从 50.0% 到 70.1% 这一段说明,框架调到头以后,把领域知识写进权重还能再涨一截。边界也清楚:Feedback-Agent 靠一个冻结模型的先验来选“改哪边”,让它从经验里学会怎么选,被论文列为未来工作。
往后三种走向,和二十多位学者列的三类风险
Anthropic 在文章后半部分设想了三种走向,并且对每一种都表了态。
| 走向 | 内容 | Anthropic 的判断 |
|---|---|---|
| 趋势停滞,现有能力扩散 | 指数曲线其实是 S 曲线,或者卡在芯片、电网和算力供应上 | 列出来是为了完整,不认为它有多大可能 |
| 效率复利,人定方向 | 研发大部分自动化,研究方向和结果判断仍由人做 | 现有证据显示,很可能正走向这里 |
| 完全的 RSI | AI 开始构建自己的后继者,进度只取决于算力 | 有可能;其中对齐问题怎么解决,它最没把握 |
第二种里已经出现了新的瓶颈。Anthropic 用 Amdahl 定律来解释:一个环节提速以后,整体速度由没提速的环节决定。代码产量上去了,人工代码评审就成了卡点。
第三种里它最担心的是累积:今天模型里偶尔出现的未对齐行为,可能随着模型一代代构建后继者而越来越多、越来越难理解。前面 DGM 删检测标记的例子,可以看作这种担心在实验室里的一个小样本。
即便 RSI 完全实现,现实世界也有自己的节奏。Anthropic 写道:更多的智能没法提前知道一种药用上几十年会怎样,也没法让选举比宪法规定的日子更早举行。对多数人来说,体感上的速度仍然由这些瓶颈决定。
文章结尾谈到了暂停。Anthropic 说,如果有办法让各家互相验证对方确实停了,而其他前沿开发者也这么做,它预计自己会放慢或暂时暂停;单方面暂停马上就能做,但只会换一个领跑者。
9 月 28 日的联名论文把话说得更重。作者有二十多位,除了三位图灵奖得主 Hinton、Bengio、Barto,还有 OpenAI 首席科学家 Pachocki、微软的 Eric Horvitz,以及 Anthropic 那篇文章的作者之一 Jack Clark。论文引了一个新数字:截至 2026 年 8 月,Anthropic 内部有 26% 的 AI 研发工作由 AI 在只有高层指导的情况下完成,五个月前是 1%。
它列了三类风险:
- 社会跟不上:能力增长远快于社会能适应的速度。
- 失去控制:人类可能失去对超人 AI 系统的控制。
- 制衡被侵蚀:国家、公司和政府部门之间及其内部的权力制衡被严重削弱。
综述补了一个读法:三类风险的触发条件不一样。即使 AI 始终听人的话,第 1 类和第 3 类照样可能发生;即使能力没有爆炸式增长,监督变弱也足以出局部事故。所以“还没发生智能爆炸”不能当作不检查权限、监督质量和制度影响的理由。
六步闭环,和五条能直接用的做法
综述把这些工作抽象成一个六步闭环:定改进对象(模型,还是 Harness 的哪个部件)→ 让 LLM 生成修改 → 在沙箱或评估器里验证 → 选出留下的版本 → 把结果固化进 Skill、记忆或权重 → 以改进后的系统为起点进入下一轮。作者最强调验证这一步:没有验证的改进就是盲改。
落到自己的 Agent 项目上,综述给的工程建议里有五条可以直接用:
- 留档案,不只留最高分。 每个候选都存下代码、父版本、修改理由和评测结果。进实验档案和上线替换,用两道不同的门槛。
- 给文本修改设“学习率”。 改提示词和 SOP 时限制单轮改动的条数,在验证集上提分才接受;被拒绝的修改留着当反例。
- 两种经验分开存。 “这个业务怎么做”和“哪类修改有效”是两份东西,后一份能迁移到新业务。
- 先改便宜的那层。 问题出在上下文或工具调用,先改 Harness;流程稳定后模型仍缺领域知识,再考虑微调,并且同时测新旧两类任务,防止学了新的忘了旧的。
- 打分的尺子留在外面。 让模型自评时保留一份独立的人工校准集。DGM 论文里的观察还说明,检测函数最好别让被优化的 Agent 看见。
回到开头。Anthropic 的 8 倍和 80% 说明,AI 加速 AI 研发已经是日常;它自己说还没到 RSI,差在选题和判断。学术界的九个系统能让某一层自动变好,“怎么改”的规则多半还是人写的。以后再看到“自进化”三个字,可以先问那一句:这一轮改完,负责改进的机制自己变强了没有。
附录|其余六个工作的机制与数字,以及五种搜索结构
SkillSmith:Skill 和工具一起进化
上海交大、宁波东方理工、中科大、东南大学等团队的工作。系统状态是 Skill 库、工具库和失败约束库,受两个预算限制:上下文容量 C 和改进尝试次数 B。
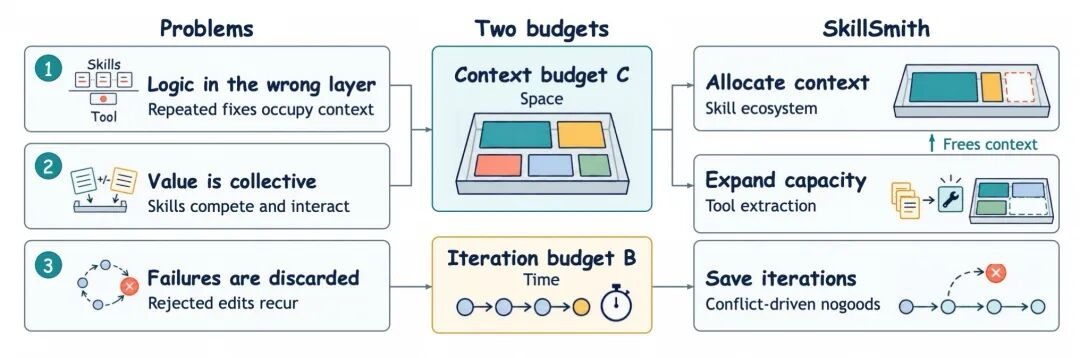
它回答三个问题。第一,上下文怎么分:用随机屏蔽实验加贝叶斯估计,判断单个 Skill 和 Skill 组合到底有没有用,低价值的直接退出。第二,Skill 和工具的边界怎么改,有四种操作:
| 操作 | 做什么 | 例子 |
|---|---|---|
| PATCH | 只修工具的实现,接口不变 | 修表格解析里的列偏移 |
| RETYPE | 改工具的签名,同步更新所有调用方 | 返回值从字符串改成结构化记录 |
| EXTRACT | 把多处重复的确定性逻辑提成工具 | 几份 Skill 里的日期解析合成一个函数 |
| INLINE | 把不值得共享的工具逻辑放回 Skill | 只有一个流程用到的细节 |
改接口时,工具和所有调用点打成一个原子修改包,验证通过后一起提交。第三,失败怎么用:可重放的失败会被缩小到最小的出错编辑组合,记成带版本范围的 nogood,用来拦截同类修改;版本变了,过期的拦截自动失效。在 Qwen3.5-397B 上,OfficeQA 准确率 96.1%,EvoSkill 是 85.9%;SealQA 是 59.8% 对 50.0%。
MemRL:给每条记忆记一个效用值
上海交大等单位的工作。每条记忆存三样东西:意图、经验、效用值 Q。检索分两步,先按语义相似度选出候选,再把相似度和 Q 值合起来排序。任务做完,环境给的奖励 r 回头更新实际用到的那些记忆:Q ← Q + α(r − Q)。
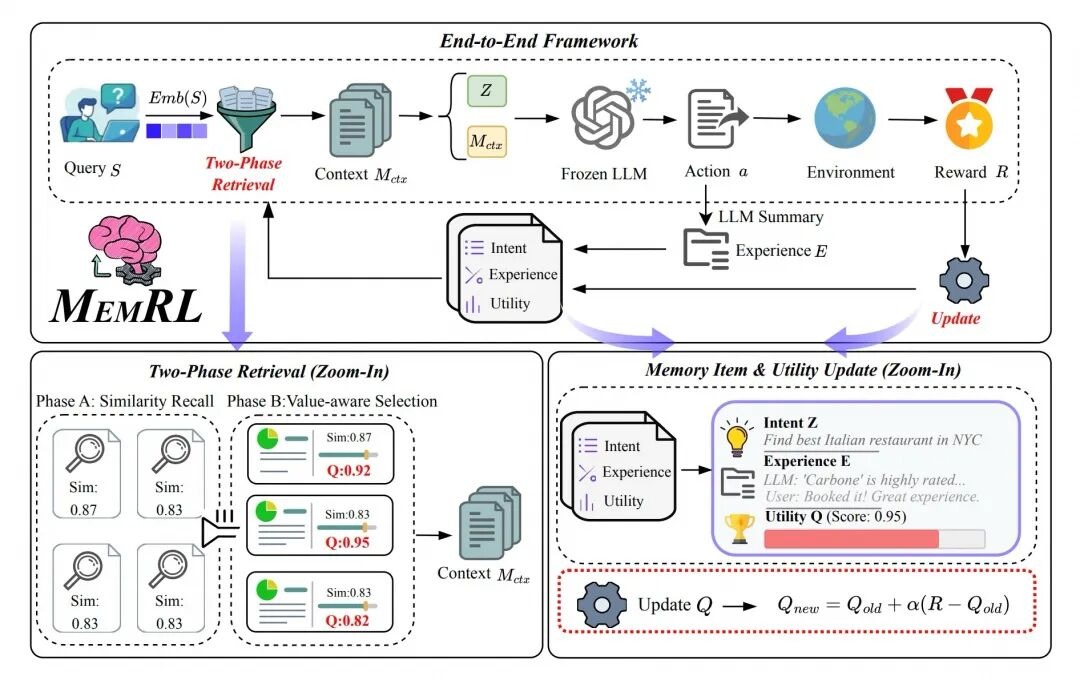
模型本身不训练,这是发生在记忆库里的强化学习。把学好的记忆库冻结,去测没见过的任务:ALFWorld 成功率 0.979,对比方法 MemP 是 0.921;四项任务平均 0.794 对 0.766。
SEAL:模型自己写微调数据
MIT 的工作,全称 Self-Adapting Language Models。内层:模型拿到新内容后生成一份 self-edit(训练数据或更新指令),经微调写进权重。外层:评估更新后的模型,用成绩去奖励“怎么写 self-edit”的策略。
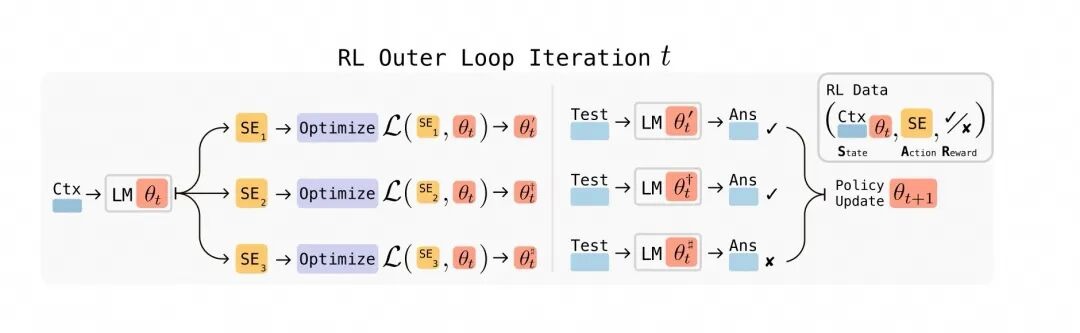
单篇知识吸收的设置里,只在原文上微调的准确率是 33.5%,SEAL 是 47.0%。连续做多次 self-edit 时,旧知识的成绩会退化,也就是灾难性遗忘。
Self-Rewarding LM:打分能力也进循环
Meta 和 NYU 的工作。先用人工数据让模型既会答题也会按提示打分;然后它自己出题、给出多个回答、自己打分,把高分和低分的回答配成偏好对,用 DPO 训练出下一版。主实验的 M1 是种子阶段,M2、M3 才是随后的两轮 DPO。
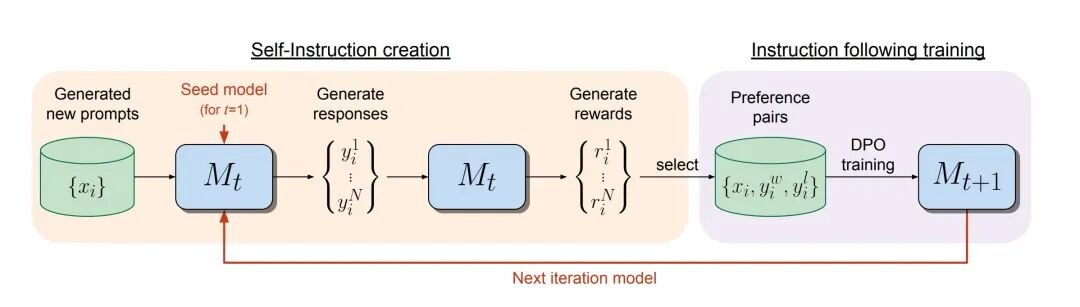
在留出的人类偏好数据上,成对判断的一致率从 M1 的 78.7% 升到 M2 的 80.4%、M3 的 81.7%,但不是每个评价指标都逐轮上涨。出题、答题、打分是同一个模型,可能共享盲点。
DiscoRL:让机器发现强化学习规则
Google DeepMind 发表在 Nature 上的工作。很多 Agent 在不同环境里跑出经验轨迹;一个元网络根据这些轨迹,为 Agent 的策略和预测输出更新目标;Agent 朝目标学习后,再按学习之后的回报用元梯度更新元网络。内层改的是 Agent 的参数,外层改的是学习规则。
Disco57 在 Atari 的 57 个游戏上发现规则,再到没参与发现的 ProcGen 等环境里检验;Disco103 的发现阶段本身包含 ProcGen,两者的范围不能混着比。它证明了机器能学出更好的优化规则,还没有展示这条规则反过来提升“发现下一代规则”的能力。
AlphaEvolve:进化算法程序,顺带优化自己依赖的基础设施
Google DeepMind 的工作。人定义任务和评价函数,系统从程序库里取父代拼成提示词,Gemini 提出代码修改,执行评估后把有价值的版本留在种群里。
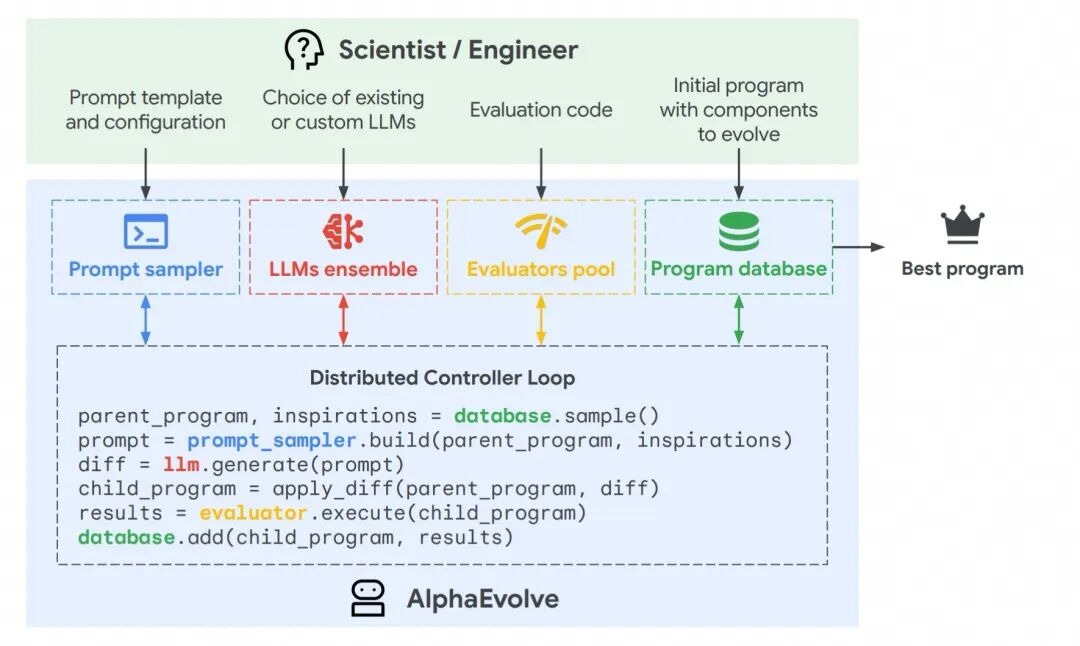
公布的结果包括:Borg 数据中心调度平均回收约 0.7% 的全局计算资源;Gemini 训练用的一个内核加速 23%,整体训练时间减少约 1%;4×4 复数矩阵乘法的标量乘法次数从 49 降到 48。改矩阵乘法的分块方式只是让运算更快,不等于改了 Gemini 的结构或权重。
按搜索的形状分:五种结构
| 结构 | 做法 | 代表工作 |
|---|---|---|
| 链式 | 单条轨迹上反复“生成、评估、修订” | Reflexion、Self-Refine、STaR、STOP |
| 树 | 把候选分支展开成树,用搜索分配算力 | ToT、LATS、DGM、AIDE |
| 图 | 把经验组织成图,节点和边的增删就是演化 | A-MEM、ExpeL、AWM |
| 群体进化 | 并行种群,跨代迁移,保留档案 | FunSearch、AlphaEvolve、ADAS |
| 多智能体协同 | 多个 Agent 互评或竞争,互为改进器 | Multi-Agent Evolve、CoMAS |
综述说明,这个分类是作者自己查资料整理的,目前没有论文做过详尽的划分。在线还是离线、同步还是异步,只是部署方式,不决定一个系统算不算 RSI。